
Python随机森林使用指南:投票原理与特征重要性分析
本文深入剖析了Python中RandomForestClassifier的实际调优要点与常见陷阱,从参数选择(如n_estimators、max_depth、class_weight等)到predict_proba与predict的本质区别,从feature_importances_的随机性本质及稳定评估方法,再到VotingClassifier软硬投票的配置关键与典型翻车场景,系统揭示了模型表现不佳背后常被忽视的“背景噪音”——如随机性未控制、概率未校准、特征尺度干扰等;它不是一份泛泛而谈的API文档,而是一线实战者用踩坑经验凝练出的清醒指南:教会你如何让随机森林真正可靠、可解释、可集成。

sklearn.RandomForestClassifier 怎么选参数
默认参数跑出来准确率低,不是模型不行,是没调对关键开关。n_estimators 别死守 100,小数据集 50 就够,大数据集 200–500 更稳;max_depth 不设限容易过拟合,尤其特征多、样本少时,建议从 6–10 试起;min_samples_split 设太小(比如 1 或 2)会让树学噪声,生产环境至少用 5 起步。
常见错误现象:RandomForestClassifier 在训练集上完美、测试集暴跌,八成是 max_depth=None + min_samples_split=2 组合导致的过拟合。
class_weight='balanced'要在类别严重不均时强制加上,否则少数类会被直接忽略- 用
oob_score=True可以省掉单独的验证集,但注意它只对袋外样本有效,不能替代真实测试逻辑 - 如果内存吃紧,把
n_jobs设成-1前先确认机器有足够 CPU 核心,否则反而变慢
predict_proba 和 predict 的区别到底在哪
predict 输出硬分类标签(比如 'cat' 或 1),predict_proba 输出每个类的概率向量(比如 [0.1, 0.85, 0.05])。别在需要置信度的场景(如风控阈值决策、模型融合输入)里只用 predict。
使用场景:做集成投票前要统一用 predict_proba,否则不同模型输出格式不一致,VotingClassifier 会直接报 ValueError: could not convert string to float。
- 注意
predict_proba返回的是数组,索引对应classes_属性顺序,别靠猜 - 如果某棵树没分到某个类,对应位置概率可能是 0,不是 NaN —— 这会影响后续加权平均逻辑
- 二分类时
predict_proba返回两列,真正要用的是第二列(正类概率),别直接取[:, 0]
feature_importances_ 为什么每次运行结果不一样
因为随机森林本身带随机性:bootstrap=True(默认)、max_features 抽样、树内分裂点随机选择。即使固定了 random_state,只要没锁住所有随机源,重要性排序就可能浮动。
性能影响:单次计算 feature_importances_ 很快,但它反映的是当前这批树的平均贡献,不是理论真值。想看稳定排序,得做多次重训+聚合(比如跑 10 次,取各特征重要性的中位数)。
- 别拿单次
feature_importances_当绝对依据,尤其当两个特征分数差小于 0.01 时,基本可视为无显著差异 max_features='sqrt'(默认)会压制高维稀疏特征的重要性,换成'log2'或固定数值有时更合理- 如果用了
StandardScaler预处理,特征重要性仍按原始变量名解释,和缩放无关
VotingClassifier 投票机制怎么配才不翻车
硬投票(voting='hard')只看最终标签,软投票(voting='soft')才用 predict_proba 加权平均。但软投票要求所有基模型都实现 predict_proba 方法 —— RandomForestClassifier 有,SVC 默认没有,必须显式加 probability=True,否则初始化就报 AttributeError: 'SVC' object has no attribute 'predict_proba'。
容易踩的坑:混用 RandomForestClassifier 和没开概率的 LogisticRegression(它其实默认支持,但有人手动关了),或者把 DecisionTreeClassifier 当软投票成员却不设 random_state,导致每次 predict_proba 输出抖动。
- 软投票下,各模型权重用
voting='soft', weights=[2,1,1]控制,不是传进estimators的顺序 - 硬投票对异常预测鲁棒性更强,软投票对校准后的概率更敏感 —— 如果你的一棵树概率输出明显偏移(比如总在 0.4–0.6 之间),它会在软投票里拉低整体置信
- 别在 VotingClassifier 里塞两个完全一样的随机森林实例,它们会高度相关,投票失去意义
特征重要性不是因果证据,投票结果不等于共识真理。真正卡住的地方,往往不是代码写错,而是没意识到随机种子、概率校准、特征尺度这些“背景噪音”正在悄悄改写输出。
今天关于《Python随机森林使用指南:投票原理与特征重要性分析》的内容就介绍到这里了,是不是学起来一目了然!想要了解更多关于的内容请关注golang学习网公众号!
 转转app修改资料方法 头像昵称怎么改
- 上一篇
- 转转app修改资料方法 头像昵称怎么改

- 下一篇
- 扣子AI定时任务设置方法详解
-
- 文章 · python教程 | 2天前 |
- Python logging Formatter 统一结构化字段输出
- 185浏览 收藏
-
- 文章 · python教程 | 2天前 | 配置 · python · Python教程 · 配置管理 Python 3.15 frozendict 不可变映射
- Python 3.15 frozendict 内置类型的配置使用场景
- 192浏览 收藏
-
- 文章 · python教程 | 2天前 | 序列化 · python · Python pickle 进程池 multiprocessing Pool
- Python multiprocessing 进程池传递不可序列化对象
- 255浏览 收藏
-
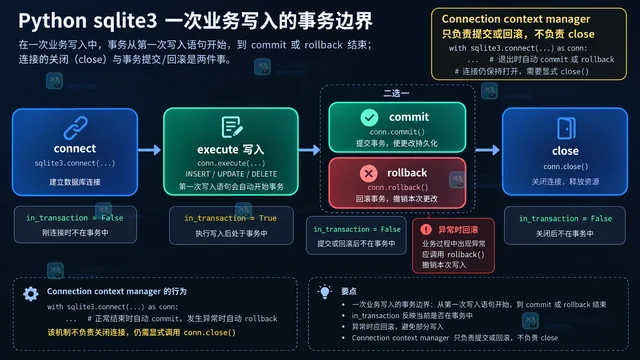
- 文章 · python教程 | 2天前 | 数据一致性 · Python教程 · Python 事务 自动提交 sqlite3 autocommit isolation_level
- Python sqlite3 事务模式与自动提交边界
- 197浏览 收藏
-
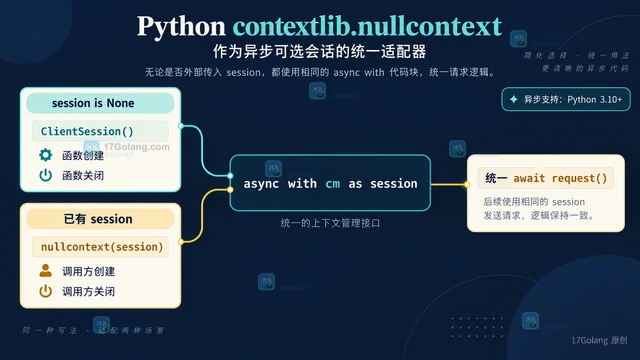
- 文章 · python教程 | 2天前 |
- Python contextlib.nullcontext 统一同步异步入口
- 316浏览 收藏
-
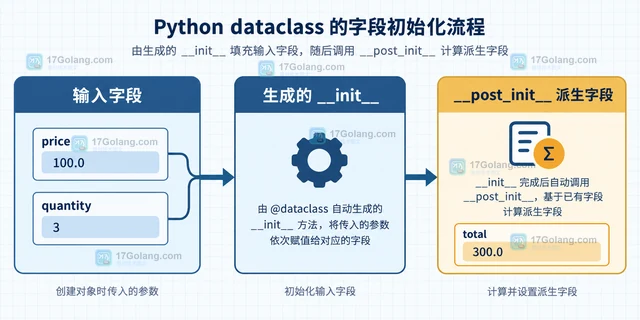
- 文章 · python教程 | 2天前 | 面向对象 · python · Python教程 · InitVar __post_init__ Python dataclass 派生字段 field(init=False)
- Python dataclass __post_init__ 计算派生字段
- 303浏览 收藏
-
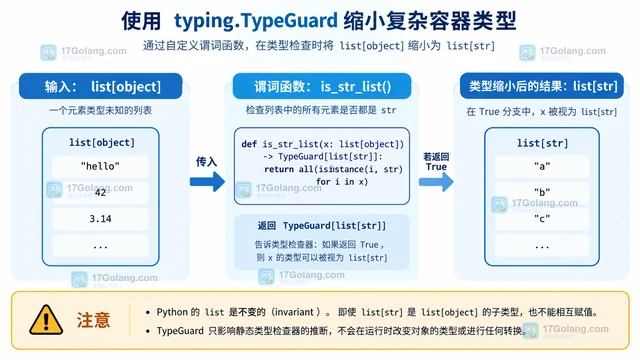
- 文章 · python教程 | 2天前 |
- Python typing.TypeGuard 处理复杂容器类型收窄
- 437浏览 收藏
-
- 文章 · python教程 | 2天前 |
- Python os.fspath 支持自定义路径对象
- 214浏览 收藏
-
- 文章 · python教程 | 2天前 | 异常处理 · 异步编程 · Python教程 · asyncio · 后台任务 任务取消 CancelledError Python asyncio asyncio.shield
- Python asyncio.shield 保护后台任务免受外层取消
- 407浏览 收藏
-
- 文章 · python教程 | 2天前 |
- Python configparser ExtendedInterpolation 组织分层配置
- 480浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 450次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 520次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 536次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 481次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 304次使用
-
- Python sqlite3 Connection serialize 怎么导出数据库快照:备份窗口、内存占用与恢复校验
- 2026-08-26 501浏览
-
- Python监控网页状态:requests异常处理实战
- 2026-05-29 501浏览
-
- TensorFlow模型部署为API的TF Serving方法
- 2026-05-26 501浏览
-
- Python字符串编码转换:encode与decode详解
- 2026-05-16 501浏览
-
- TensorFlow裁剪无用算子方法详解
- 2026-05-15 501浏览


