
Python用bar()画柱状图及颜色设置技巧
本文深入解析了使用 matplotlib.pyplot.bar() 绘制专业级柱状图的核心技巧与常见陷阱:从 x 轴类别索引的显式构造与标签对齐(避免字符串误用和 DataFrame 列名重排导致的错位),到多组并列柱子的精准错位偏移(通过 width 控制宽度、x ± width/2 实现无重叠对比);从 color 与 edgecolor 的视觉协同(消除“发灰”边框、适配深色背景)到中文字体配置的实操方案(正确设置 font.sans-serif 和 unicode_minus,结合系统字体排查);每一步都直击实际绘图中高频报错、显示异常和效果失真的根源,帮你避开隐性坑,画出清晰、准确、美观且可复现的分类统计图表。

用 plt.bar() 画分类柱状图,x轴必须是明确的索引或类别序列
直接传入字符串列表当 x 参数,plt.bar() 能正常显示,但背后它其实把每个字符串当成了独立刻度位置——不是自动编码,也不依赖 pandas 的 categorical 类型。一旦 x 是数字(比如 [0, 1, 2]),而你又想标成 ['A', 'B', 'C'],就得手动配 plt.xticks(),否则柱子对不上标签。
常见错误现象:plt.bar(['A','B','C'], [10,20,15]) 看起来没问题,但后续加误差线、叠加多组柱子时容易错位;更隐蔽的是用 DataFrame 列名直接传给 x,结果列名顺序被重排,图表就乱了。
- 推荐做法:显式构造 x 坐标(如
range(len(categories))),再用plt.xticks(range(len(categories)), categories)控制标签 - 如果数据来自 pandas,别直接用
df['category']当 x,先做df['category'].tolist()或用df.index配合df['value'] - 注意:x 坐标长度必须和 y 值长度严格一致,否则报
ValueError: x and height must have same length
plt.bar() 的 color 和 facecolor 区别不大,但 edgecolor 很关键
color 同时控制填充色和边框色;facecolor 只管填充,edgecolor 单独控边框。默认边框是黑的、宽度 linewidth=0,看起来像没边,实际一放大就能看见细黑线。很多人在调色时发现柱子“发灰”或“边界模糊”,其实是黑色边框和浅色填充混在一起造成的视觉干扰。
- 要干净效果:加
edgecolor='none'或edgecolor='white'(尤其深色背景) - 想强调分隔感:设
edgecolor='gray'和linewidth=0.5,比纯黑柔和 - 批量配色时,
color接列表(如['#1f77b4', '#ff7f0e', '#2ca02c'])比单字符串更安全;传单字符串(如'C0')会复用同一色系,但多组柱子时易混淆
并列柱状图别硬塞多个 plt.bar(),用 width 和 align 微调位置
画两组分类对比(比如「去年 vs 今年」),不能简单连写两个 plt.bar()——默认都从同一 x 坐标开始画,后一个完全盖住前一个。得让它们左右错开。核心靠 width 缩窄柱子,再用 x - width/2 和 x + width/2 偏移位置。
常见错误现象:柱子重叠、间隙过大、标签居中失效、图例顺序和柱子不对应。
- 设统一
width = 0.35(默认是 0.8),然后第一组用x - width/2,第二组用x + width/2 - 别改
align='edge',保持默认'center'更稳;改了 align 容易导致 xticks 错位 - 图例顺序按
plt.bar()调用顺序来,先画的在前,别反了 - 示例:
plt.bar(x_pos - width/2, data1, width=width, label='2023'),plt.bar(x_pos + width/2, data2, width=width, label='2024')
中文标签显示为方块?重点查 matplotlib 字体配置和 plt.rcParams
不是所有系统默认支持中文字体,matplotlib 会静默回退到无字形字体,结果就是小方块。这不是编码问题,也不是 plt.show() 的锅,而是字体路径没对上。
- 临时解决:运行前加
plt.rcParams['font.sans-serif'] = ['SimHei', 'Arial Unicode MS', 'DejaVu Sans'],确保列表里有本机存在的中文字体名 - 查可用字体:
import matplotlib.font_manager as fm; [f.name for f in fm.fontManager.ttflist],找含 “Sim”、“Noto”、“Source Han” 的条目 - Mac 用户优先试
'Helvetica Neue'或'Arial Unicode MS';Windows 一般用'SimHei';Linux 常需手动装fonts-wqy-zenhei并重启 Python 进程 - 别漏掉这句:
plt.rcParams['axes.unicode_minus'] = False,否则负号显示为方块
细节都在参数微调里,比如 width 差 0.05,柱子间距就明显不同;edgecolor 设成 'none' 还是 'white',在深色背景上差别极大。这些地方不试几次根本看不出问题。
以上就是本文的全部内容了,是否有顺利帮助你解决问题?若是能给你带来学习上的帮助,请大家多多支持golang学习网!更多关于文章的相关知识,也可关注golang学习网公众号。
 国家政务服务平台官网入口及办理指南
- 上一篇
- 国家政务服务平台官网入口及办理指南

- 下一篇
- CSS自定义单选框样式技巧
-
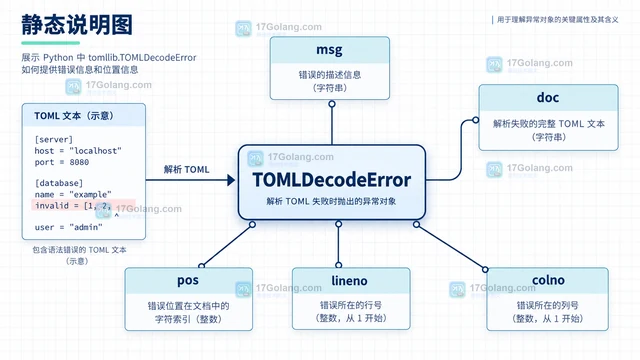
- 文章 · python教程 | 6小时前 | python · Python tomllib TOMLDecodeError
- Python tomllib 解析失败时如何定位具体键与行列
- 198浏览 收藏
-
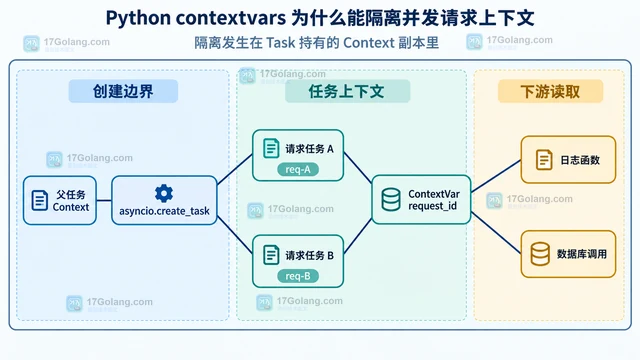
- 文章 · python教程 | 10小时前 |
- Python contextvars 为什么能隔离并发请求上下文
- 202浏览 收藏
-
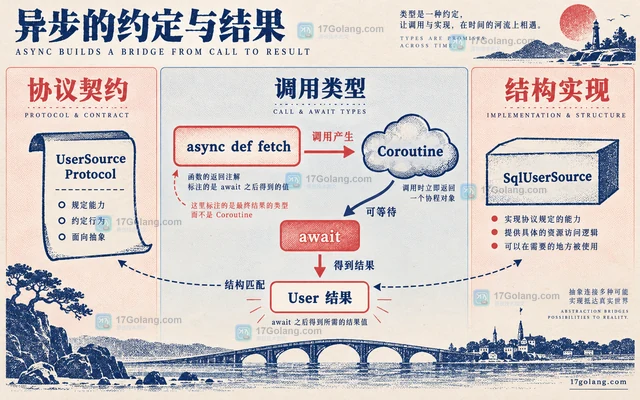
- 文章 · python教程 | 14小时前 | Python教程 · 静态类型检查 异步方法 Python Protocol 结构类型 Awaitable
- Python Protocol 怎样描述带异步方法的结构类型
- 363浏览 收藏
-
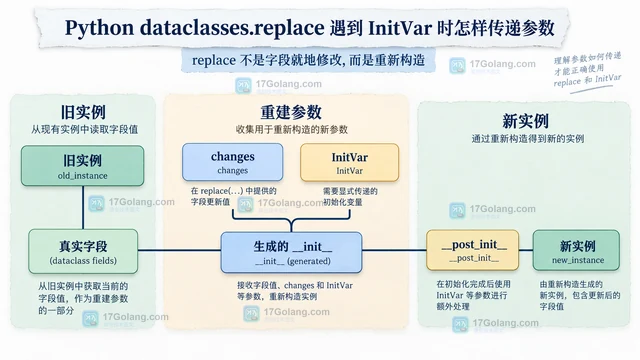
- 文章 · python教程 | 16小时前 | Python教程 · InitVar __post_init__ Python dataclasses.replace 数据类复制
- Python dataclasses.replace 遇到 InitVar 时怎样传递参数
- 381浏览 收藏
-
- 文章 · python教程 | 19小时前 | python · pathlib ·
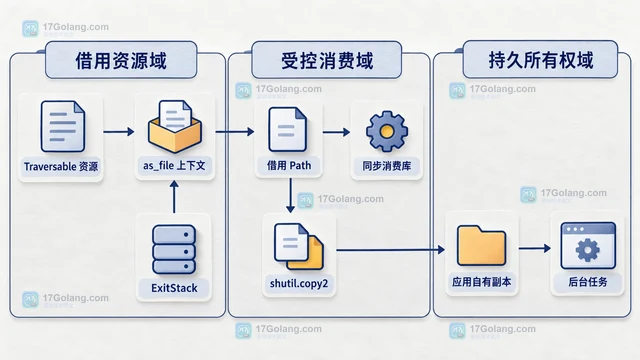
- Python importlib.resources.as_file 的临时路径何时失效
- 318浏览 收藏
-
- 文章 · python教程 | 21小时前 | SQLite · Python教程 · Python sqlite3 Connection.backup 进度回调 SQLite备份
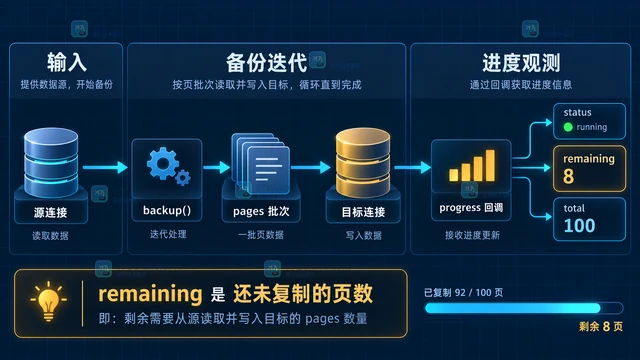
- Python sqlite3 备份进度回调怎样判断剩余页数
- 264浏览 收藏
-
- 文章 · python教程 | 23小时前 | python · 内存优化 · Python教程 · 文件读取 大文件处理 Python mmap 分段映射 ALLOCATIONGRANULARITY
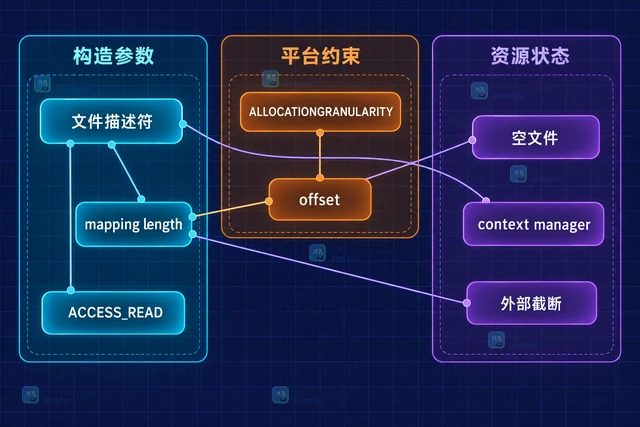
- Python mmap 怎样分段处理超过内存的大文件
- 146浏览 收藏
-
- 文章 · python教程 | 1天前 | python · Python 二进制协议 零拷贝 memoryview
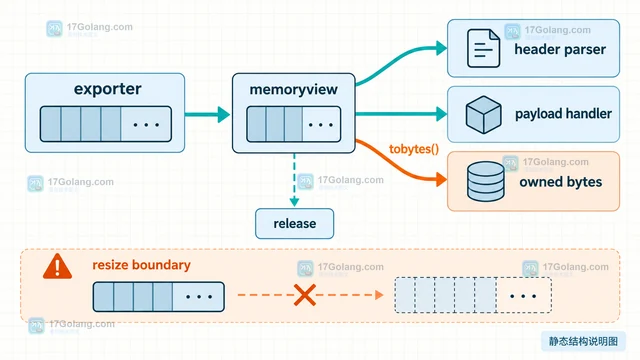
- Python memoryview 如何零拷贝切片二进制协议数据
- 225浏览 收藏
-
- 文章 · python教程 | 1天前 | 并发控制 · Python教程 · asyncio · 虚假唤醒 wait_for Python asyncio asyncio.Condition 异步同步
- Python asyncio.Condition.wait_for 如何处理虚假唤醒
- 478浏览 收藏
-
- 文章 · python教程 | 1天前 |
- Python ExceptionGroup 派生新组时如何保留异常元数据
- 417浏览 收藏
-
- 文章 · python教程 | 1天前 | 异常处理 · 并发编程 · Python教程 · asyncio · asyncio 结构化并发 ExceptionGroup except* Python TaskGroup
- Python TaskGroup 如何汇总多个子任务异常
- 208浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 399次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 478次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 483次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 429次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 257次使用
-
- Python sqlite3 Connection serialize 怎么导出数据库快照:备份窗口、内存占用与恢复校验
- 2026-08-26 501浏览
-
- Python监控网页状态:requests异常处理实战
- 2026-05-29 501浏览
-
- TensorFlow模型部署为API的TF Serving方法
- 2026-05-26 501浏览
-
- Python字符串编码转换:encode与decode详解
- 2026-05-16 501浏览
-
- TensorFlow裁剪无用算子方法详解
- 2026-05-15 501浏览