
Java高效反序列化多维JSON张量数组方案
2026-03-27 16:09:39
0浏览
收藏
本文提出了一种轻量、高效且类型安全的Java反序列化方案,利用FastJSON与Hutool协同解析动态维度与类型的JSON张量数据——仅需声明`dim`(如[2,3])和`type`(如"FP32"),即可全自动将嵌套JSON数组(如[[1.0,2.0],[3.0,4.0]])精准还原为对应维度的原生数组(如float[][])或泛型集合,彻底摆脱手工编写多层递归逻辑的繁琐与易错;方案代码简洁可复用,已覆盖科学计算、AI模型服务、跨语言数据交换等典型场景,并兼顾安全性(支持FastJSON2升级)、性能(可缓存类型查找)与健壮性(提供空值与异常处理建议),是处理动态结构张量数据的实用利器。
本文介绍一种基于 FastJSON 与 Hutool 的轻量级、类型安全方案,可自动根据 JSON 中的 `dim`(维度)和 `type`(数据类型)字段,将嵌套 JSON 数组(如 `[[1.2,3.4],[5.6,7.8]]` 或 `[1,2,3,4]`)精准反序列化为对应维度的 Java 原生数组或泛型集合(如 `double[][]`、`int[]`、`String[]` 等),无需硬编码多层嵌套逻辑。
在处理科学计算、AI 模型推理或跨语言张量数据交换时,常遇到结构统一但维度与类型动态变化的 JSON 数据,例如:
{ "dim": [2,3], "type": "FP32", "data": [[1.0,2.0,3.0],[4.0,5.0,6.0]] }
{ "dim": [1,4], "type": "FP64", "data": [[5.1,3.5,1.4,0.2]] }
{ "dim": [4], "type": "INT8", "data": [0,1,2,3] }
{ "dim": [1], "type": "BYTES", "data": ["Hello"] }其核心挑战在于:data 字段的嵌套层数由 dim 数组长度决定(n 维 → n 层嵌套),且元素类型需按 type 映射为 Java 基本类型或包装类(如 "FP64" → double,"INT8" → byte)。Jackson/Gson 默认不支持运行时动态维度解析,需手动构建泛型类型或递归解析。
✅ 推荐方案:FastJSON + Hutool 协同解析
FastJSON 提供强大的 JSON.parseObject() 和类型推断能力;Hutool 的 ArrayUtil 与 TypeReference 工具可简化多维数组构造与类型转换。以下是完整、可复用的实现:
1. Maven 依赖(推荐 FastJSON 1.2.83+ 或 2.x,Hutool 5.8.22+)
    com.alibaba
    fastjson
    1.2.83


    cn.hutool
    hutool-all
    5.8.22
2. 核心解析工具类
import cn.hutool.core.convert.Convert;
import cn.hutool.core.util.ArrayUtil;
import com.alibaba.fastjson.JSON;
import com.alibaba.fastjson.JSONObject;
import com.alibaba.fastjson.TypeReference;

import java.lang.reflect.Array;
import java.util.*;

public class TensorDeserializer {

    // 类型映射表(可根据需求扩展)
    private static final Map> TYPE_MAP = new HashMap<>();
    static {
        TYPE_MAP.put("FP32", float.class);
        TYPE_MAP.put("FP64", double.class);
        TYPE_MAP.put("INT8", byte.class);
        TYPE_MAP.put("INT16", short.class);
        TYPE_MAP.put("INT32", int.class);
        TYPE_MAP.put("INT64", long.class);
        TYPE_MAP.put("BYTES", String.class); // 字符串视为字节序列语义
        TYPE_MAP.put("BOOL", boolean.class);
    }

    /**
     * 反序列化张量 JSON 字符串为指定维度的 Java 数组
     * @param json JSON 字符串(含 dim, type, data 字段)
     * @return 动态生成的 n 维数组(如 double[][]、int[]、String[] 等)
     */
    public static Object deserialize(String json) {
        JSONObject root = JSON.parseObject(json);
        int[] dims = root.getObject("dim", int[].class);
        String typeStr = root.getString("type");
        Object rawData = root.get("data");

        Class elementType = TYPE_MAP.getOrDefault(typeStr.toUpperCase(), String.class);

        // 递归构建 n 维数组并填充数据
        return buildNDArray(rawData, dims, 0, elementType);
    }

    private static Object buildNDArray(Object data, int[] dims, int depth, Class elemType) {
        if (depth == dims.length) {
            // 到达最内层:直接转换为基本类型或包装类
            return Convert.convert(elemType, data);
        }

        int size = dims[depth];
        Class arrayType = (depth == dims.length - 1)
                ? elemType
                : ArrayUtil.getClass(elemType); // 如 elemType=Double → Double[].class

        Object array = Array.newInstance(arrayType, size);
        List dataList = data instanceof List ? (List) data : Collections.singletonList(data);

        for (int i = 0; i < size && i < dataList.size(); i++) {
            Object subData = dataList.get(i);
            Object subArray = buildNDArray(subData, dims, depth + 1, elemType);
            Array.set(array, i, subArray);
        }
        return array;
    }
}
3. 使用示例
public class TensorDemo {
    public static void main(String[] args) {
        // 示例 1:2D FP64 数组 → double[][]
        String json1 = "{\"dim\":[2,2],\"type\":\"FP64\",\"data\":[[1.1,2.2],[3.3,4.4]]}";
        double[][] arr2d = (double[][]) TensorDeserializer.deserialize(json1);
        System.out.println(Arrays.deepToString(arr2d));
        // 输出: [[1.1, 2.2], [3.3, 4.4]]

        // 示例 2:1D INT8 数组 → byte[]
        String json2 = "{\"dim\":[3],\"type\":\"INT8\",\"data\":[10,20,30]}";
        byte[] arr1d = (byte[]) TensorDeserializer.deserialize(json2);
        System.out.println(Arrays.toString(arr1d));
        // 输出: [10, 20, 30]

        // 示例 3:1D BYTES → String[]
        String json3 = "{\"dim\":[2],\"type\":\"BYTES\",\"data\":[\"A\",\"B\"]}";
        String[] strArr = (String[]) TensorDeserializer.deserialize(json3);
        System.out.println(Arrays.toString(strArr));
        // 输出: [A, B]
    }
}
⚠️ 注意事项与最佳实践
- 类型安全性:TYPE_MAP 中未定义的 type 将默认回退为 String.class,建议在生产环境增加校验抛出 IllegalArgumentException;
- 性能优化:对高频调用场景,可缓存 Class 查找结果,避免重复 HashMap.get();
- 兼容性提示:FastJSON 1.x 存在已知安全风险,生产环境强烈推荐升级至 FastJSON2(com.alibaba.fastjson2:fastjson2),并微调 JSON.parseObject(...) 调用方式;
- 空值/异常处理:示例代码未包含 null 容错,实际使用中应在 buildNDArray 中添加 if (data == null) 分支返回默认值或抛出语义化异常;
- 替代方案对比:若项目已强制使用 Jackson,可通过自定义 JsonDeserializer
+ TypeFactory.constructArrayType() 实现类似逻辑,但代码复杂度显著升高。
该方案以最小侵入性解决了“维度动态 + 类型动态”的双重难题,兼顾可读性、可维护性与执行效率,适用于模型服务接口、配置中心张量参数解析等典型场景。
理论要掌握,实操不能落!以上关于《Java高效反序列化多维JSON张量数组方案》的详细介绍,大家都掌握了吧!如果想要继续提升自己的能力,那么就来关注golang学习网公众号吧!
 Python用生成器高效读取大文件数据
- 上一篇
- Python用生成器高效读取大文件数据

- 下一篇
- 今日头条删除搜索记录步骤详解
查看更多
最新文章
-
- 文章 · java教程 | 1小时前 | Java教程 · sealed interface Java密封类 模式匹配switch 支付结果 穷尽检查
- 密封类建模支付结果:穷尽分支与扩展边界
- 270浏览 收藏
-
- 文章 · java教程 | 3小时前 | 数据校验 · api设计 · Java教程 · 参数校验 Java record API DTO Jakarta Validation 紧凑规范构造器 跨字段校验
- Java Record 作为 API DTO 时,校验逻辑放在哪里
- 370浏览 收藏
-
- 文章 · java教程 | 5小时前 | 线程池 · 异常处理 · 并发编程 · Java教程 · CompletableFuture · 异步任务 completablefuture allOf Handle 结果汇总 CompletionException
- CompletableFuture 组合独立任务:allOf 结果汇总与失败归属
- 482浏览 收藏
-
- 文章 · java教程 | 7小时前 |
- StructuredTaskScope 如何表达并发任务的共同生命周期
- 425浏览 收藏
-
- 文章 · java教程 | 13小时前 | 并发编程 · Java教程 · java arena MemorySegment WrongThreadException FFM API
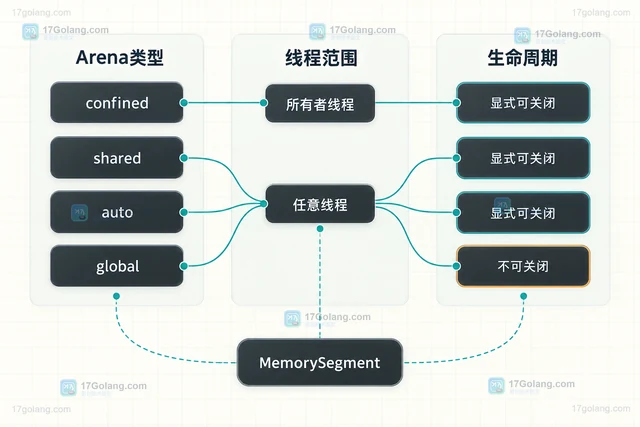
- Java MemorySegment 怎么限制跨线程访问范围
- 132浏览 收藏
-
- 文章 · java教程 | 15小时前 | Java · Java 24 Java Class-File API CodeTransform ClassTransform CodeAttribute
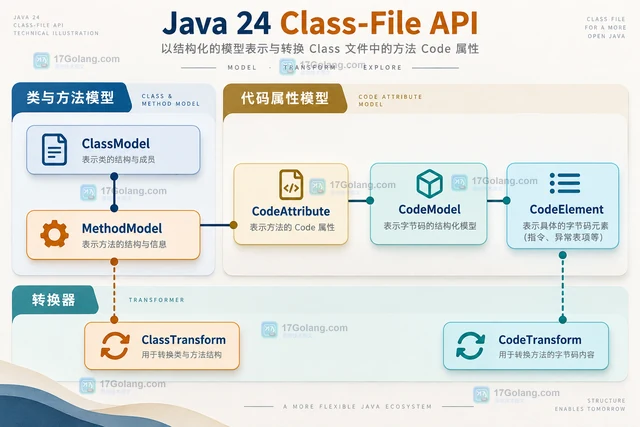
- Java Class-File API 怎么转换方法代码属性
- 199浏览 收藏
-
- 文章 · java教程 | 17小时前 | Java · Stream · java Stream Gatherer Integrator.Greedy
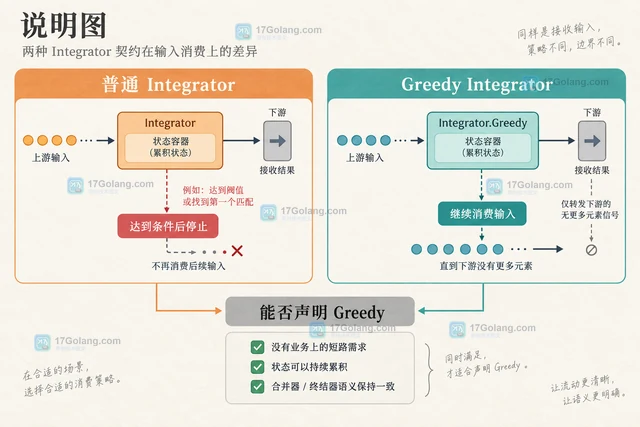
- Java Gatherer Integrator.Greedy 什么时候可以声明贪婪处理
- 112浏览 收藏
-
- 文章 · java教程 | 19小时前 |
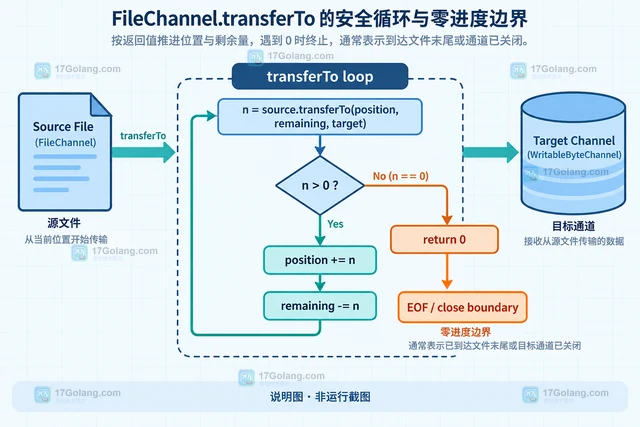
- Java FileChannel transferTo 为什么可能只传输部分字节
- 229浏览 收藏
-
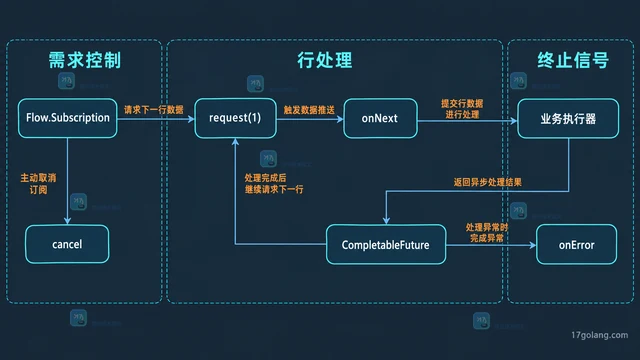
- 文章 · java教程 | 22小时前 | Java · 异步编程 · Java HttpClient BodyHandlers.fromLineSubscriber Flow.Subscriber 异步响应 按行消费
- Java HttpClient 怎么把响应体按行异步消费
- 433浏览 收藏
-
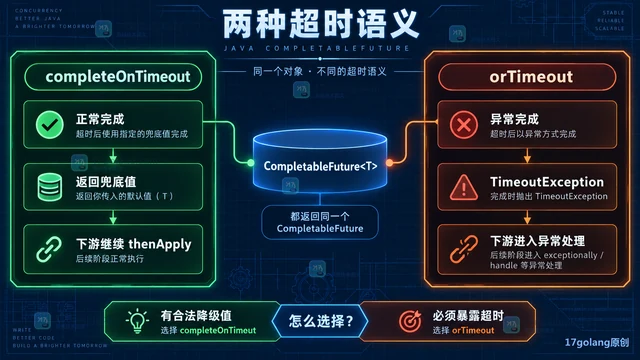
- 文章 · java教程 | 1天前 | 并发 · 超时控制 · 异步编程 · Java教程 · CompletableFuture · java completablefuture TimeoutException orTimeout completeOnTimeout
- Java completeOnTimeout 和 orTimeout 怎么选择
- 152浏览 收藏
查看更多
课程推荐
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
查看更多
AI推荐
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 363次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 419次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 433次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 385次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 210次使用
查看更多
相关文章
-
- Java try-with-resources 多个资源关闭顺序是什么
- 2026-09-10 501浏览
-
- 矩阵主副对角线快速定位技巧
- 2026-05-31 501浏览
-
- Java多态优化流程代码与行为分发改进
- 2026-05-26 501浏览
-
- JVM 类元数据双亲委派链表深度解析
- 2026-05-21 501浏览
-
- 反射异常处理:InvocationTargetException解析与应用
- 2026-05-16 501浏览


