
Pythoncaplog获取错误日志详解
本文深入解析了 pytest 中 caplog fixture 的正确使用方法,揭示其默认仅捕获 WARNING 及以上日志的“隐藏规则”,强调必须显式调用 caplog.set_level() 才能可靠捕获 DEBUG/INFO 等低级别日志;同时指出应摒弃对易失、非结构化的 caplog.text 的依赖,转而利用 caplog.records 提供的完整 LogRecord 对象,通过 levelno、levelname、msg、args 和 getMessage() 等字段进行精准、健壮的日志断言——涵盖日志来源(record.name)、级别、格式化参数甚至异常上下文,避免因字符串匹配、大小写敏感或拼接混乱导致的脆弱测试,并提醒开发者警惕 conftest.py 中全局配置的 scope 陷阱,真正掌握日志测试中“该出现的没出现”与“不该出现的出现了”的关键分辨能力。

caplog fixture 默认只捕获 WARNING 及以上级别日志
pytest 的 caplog fixture 默认不会记录 DEBUG 或 INFO 级别的日志,哪怕你代码里写了 logging.debug("xxx"),caplog.records 里也看不到——这不是 bug,是 pytest 的默认配置。它模仿了生产环境日志级别习惯,但写测试时往往需要更细粒度的观察。
- 必须显式设置日志级别,比如在测试函数开头加
caplog.set_level(logging.DEBUG) - 也可以在
pytest.ini或pyproject.toml中全局配置:log_cli_level = DEBUG,但注意这会影响所有测试,可能掩盖真实问题 - 如果用
@pytest.mark.parametrize多次运行同一测试,每次都要重新调用set_level(),因为caplog是 function-scoped fixture,每次执行都是干净实例
怎么拿到完整日志信息流(含 levelno、levelname、msg、args)
caplog.records 返回的是 logging.LogRecord 实例列表,每个 record 都带原始结构化字段,不是拼好的字符串。很多人直接 print caplog.text 就以为“看到日志了”,其实丢掉了关键上下文。
caplog.records[0].levelno是整数(10=DEBUG, 20=INFO),比字符串判断更可靠caplog.records[0].levelname是字符串("DEBUG"),适合断言可读性caplog.records[0].msg是原始格式字符串(如"User %s logged in from %s"),不包含.args展开后的值- 要检查最终输出内容,得用
caplog.records[0].getMessage(),它等价于record.msg % record.args - 别用
caplog.text做精确匹配——它是所有日志按\n拼接的字符串,换行/空格不可控,且丢失 record 元数据
测试中 assert 日志输出时容易漏掉的三个条件
光看有没有某条日志远远不够。日志是否在正确时机触发、是否来自预期模块、是否带预期参数,都得验证。否则改个 logger = logging.getLogger(__name__) 到 getLogger("root") 就让测试失效。
- 检查
record.name字段,确认来源 logger 名(比如"myapp.auth"而不是"root") - 用
record.levelno == logging.ERROR断言级别,避免字符串比较("ERROR" vs "error" 或大小写敏感问题) - 如果日志用了 lazy formatting(如
logger.info("user=%s", user_obj)),record.args是元组,要检查len(record.args) == 1且isinstance(record.args[0], User),而不是硬 match 字符串
caplog 在 conftest.py 里复用时的 scope 陷阱
有人把 caplog.set_level(logging.DEBUG) 写进 conftest.py 的 pytest_configure,结果部分测试还是捕不到 INFO 日志——因为 caplog fixture 本身是 function-scoped,它的状态(比如当前 level)不会跨测试函数继承。
- 不能靠全局配置“一次设置,处处生效”;每个测试函数内必须显式调用
caplog.set_level(...) - 如果想减少重复,可以封装一个 fixture:
@pytest.fixture(autouse=True)+def set_caplog_level(caplog): caplog.set_level(logging.DEBUG),但要注意 autouse 会影响所有测试,慎用 - 更稳妥的做法:在每个需要日志断言的测试函数第一行写
caplog.set_level(logging.DEBUG),清晰、可控、无副作用
日志测试真正的难点不在捕获,而在区分“该出现的没出现”和“不该出现的出现了”。record 对象的字段越多,越容易写出脆弱断言——比如过度依赖 getMessage() 而忽略格式化失败场景。留心 args 和 exc_info 是否为空,比死盯 message 字符串有用得多。
今天关于《Pythoncaplog获取错误日志详解》的内容介绍就到此结束,如果有什么疑问或者建议,可以在golang学习网公众号下多多回复交流;文中若有不正之处,也希望回复留言以告知!
 微博转载权限设置方法详解
- 上一篇
- 微博转载权限设置方法详解
- 下一篇
- CSS伪元素多重边框实现方法
-
- 文章 · python教程 | 1天前 | 线程池 · Python 线程池 concurrent.futures 任务取消 Future.cancel
- Python concurrent.futures.Future.cancel 怎样判断任务能否取消
- 143浏览 收藏
-
- 文章 · python教程 | 1天前 | 标准库 · HTTP服务 · 多线程 · Python教程 · Python 并发请求 http.server ThreadingHTTPServer ThreadingMixIn BaseHTTPRequestHandler
- Python http.server ThreadingHTTPServer 怎样处理并发请求
- 481浏览 收藏
-
- 文章 · python教程 | 1天前 |
- Python tarfile.TarInfo.replace 怎样复制归档成员属性
- 308浏览 收藏
-
- 文章 · python教程 | 1天前 | 并发编程 · Python教程 · Python 多进程 multiprocessing forkserver 启动上下文
- Python multiprocessing forkserver 怎样处理进程启动上下文
- 232浏览 收藏
-
- 文章 · python教程 | 1天前 | 标准库 · 异步编程 · Python教程 · Python asyncio StreamReader readexactly IncompleteReadError 异步流
- Python asyncio.StreamReader.readexactly 怎样处理不足长度的输入
- 427浏览 收藏
-
- 文章 · python教程 | 1天前 |
- Python operator.length_hint 怎样为未知长度迭代器设置估计值
- 336浏览 收藏
-
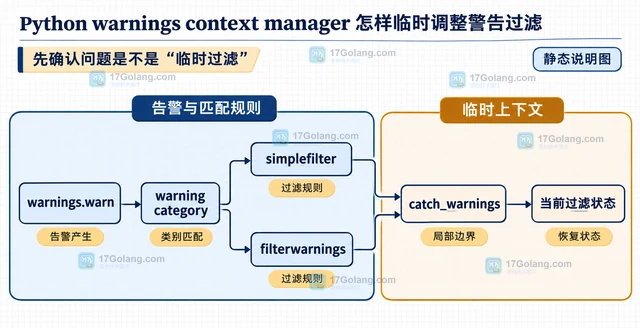
- 文章 · python教程 | 1天前 | 标准库 · Python教程 · Python warnings catch_warnings simplefilter filterwarnings 警告过滤
- Python warnings context manager 怎样临时调整警告过滤
- 255浏览 收藏
-
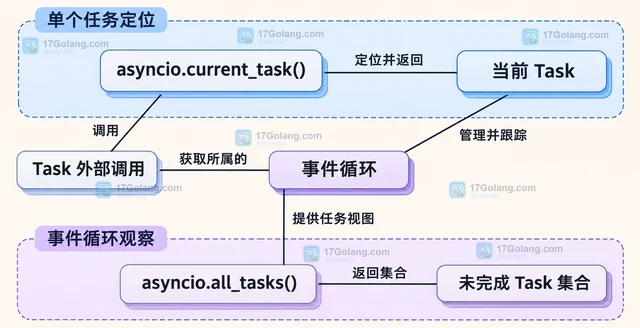
- 文章 · python教程 | 1天前 | 调试 · python · 异步编程 · Python asyncio introspection current_task all_tasks
- Python asyncio introspection 怎样定位当前任务
- 120浏览 收藏
-
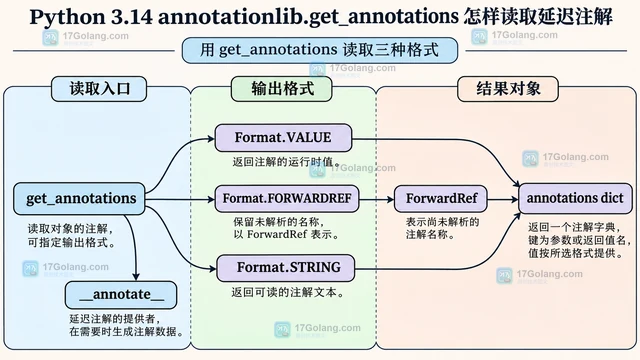
- 文章 · python教程 | 1天前 | 标准库 · Python教程 · Python 类型注解 Python 3.14 annotationlib get_annotations ForwardRef 延迟注解
- Python 3.14 annotationlib.get_annotations 怎样读取延迟注解
- 423浏览 收藏
-
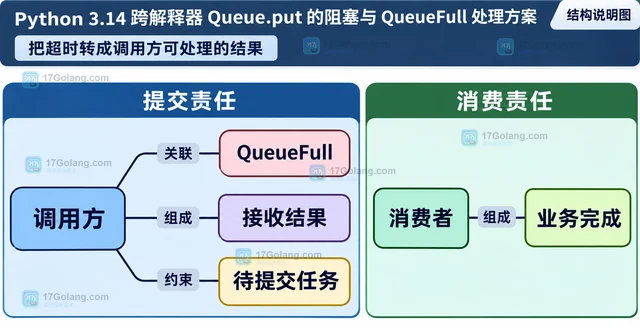
- 文章 · python教程 | 1天前 |
- Python 3.14 跨解释器 Queue.put 的阻塞与 QueueFull 处理方案
- 157浏览 收藏
-
- 文章 · python教程 | 2天前 | xml · python · Python xml xml.etree.ElementTree canonicalize C14N
- Python xml.etree.ElementTree.canonicalize 怎样生成稳定的 XML 文本
- 151浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 1172次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 1154次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 1337次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 1280次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 1138次使用
-
- Python TaskGroup 怎样让子任务失败统一收敛
- 2026-11-12 501浏览
-
- Python xml.dom.minidom.unlink 怎样释放不再使用的 DOM 树引用
- 2026-10-27 501浏览
-
- Python typing 怎样用 TypeIs 缩小类型
- 2026-10-24 501浏览
-
- Python sqlite3 Connection serialize 怎么导出数据库快照:备份窗口、内存占用与恢复校验
- 2026-08-26 501浏览
-
- Python监控网页状态:requests异常处理实战
- 2026-05-29 501浏览


