
提高储存引擎的吞吐量:MaxScale在MySQL中的应用案例
珍惜时间,勤奋学习!今天给大家带来《提高储存引擎的吞吐量:MaxScale在MySQL中的应用案例》,正文内容主要涉及到等等,如果你正在学习数据库,或者是对数据库有疑问,欢迎大家关注我!后面我会持续更新相关内容的,希望都能帮到正在学习的大家!
提高储存引擎的吞吐量:MaxScale在MySQL中的应用案例
引言:
在当前大数据和高并发的环境下,如何提高数据库的吞吐量成为了许多企业和开发者面临的问题。MySQL作为一款常用的开源关系型数据库,其性能优化一直备受关注。本文将介绍一种通过使用MaxScale工具来提高MySQL数据库吞吐量的方法,以及具体的应用案例。
一、MaxScale简介
MaxScale是MariaDB公司推出的一款开源数据库代理工具,用于提高数据库的性能、可靠性和可扩展性。它可以作为数据库与客户端之间的中间层,负责分发和路由数据库的请求。MaxScale具有负载均衡、故障转移、缓存、查询路由和查询过滤等功能,可以在不修改应用程序的情况下提高数据库的吞吐量。
二、MaxScale在MySQL中的应用案例
假设我们有一个在线电商平台,每天有大量的用户在进行商品浏览、下单、付款等操作。由于数据库的读写压力较大,我们希望通过MaxScale工具来提高数据库的吞吐量。
- 安装MaxScale
首先,我们需要安装MaxScale。可以通过官方网站下载并安装MaxScale的最新版本。在安装过程中,需要按照提示进行配置,包括指定MySQL数据库的连接信息等。 - 配置MaxScale
配置文件位于MaxScale的安装目录下,默认为/etc/maxscale.cnf。打开文件后,我们需要进行一些配置,例如指定数据库的监听端口、设置用户认证信息等。以下是一个简单的配置示例:
[maxscale]
threads=4
log_info=1

[monitor]
module=mysqlmon
servers=primary,secondary
user=maxscale_user
passwd=maxscale_password

[listener]
type=server
service=db_service
protocol=MySQLClient
port=3306

[db_service]
type=service
router=readconnroute
servers=primary,secondary
user=db_user
passwd=db_password

[primary]
type=server
address=127.0.0.1
port=3306
protocol=MySQLBackend

[secondary]
type=server
address=127.0.0.2
port=3306
protocol=MySQLBackend
在配置文件中,我们首先定义了一个monitor模块,用于监控数据库的状态。然后定义了一个listener模块,监听数据库的连接请求。接着定义了一个db_service模块,用于定义数据库的相关参数和连接池信息。最后定义了两个server模块,分别对应主数据库和从数据库。根据实际情况修改相应的参数。
- 启动MaxScale
在完成配置后,我们可以通过执行以下命令来启动MaxScale:
maxscale -f /etc/maxscale.cnf
- 测试性能
完成上述步骤后,我们可以通过并发请求来测试MaxScale对数据库吞吐量的提升效果。以下是一个简单的测试代码示例:
import pymysql
import time
from concurrent.futures import ThreadPoolExecutor

def query_data():
    conn = pymysql.connect(host='127.0.0.1', user='maxscale_user', password='maxscale_password', database='test')
    cursor = conn.cursor()
    cursor.execute('SELECT * FROM table')
    rows = cursor.fetchall()
    conn.close()

def concurrent_test():
    start = time.time()
    executor = ThreadPoolExecutor(max_workers=100)
    futures = []

    for _ in range(1000):
        future = executor.submit(query_data)
        futures.append(future)

    executor.shutdown()

    for future in futures:
        result = future.result()

    end = time.time()
    print('Total time:', end - start)

if __name__ == '__main__':
concurrent_test()在上述代码中,我们使用了Python的concurrent.futures模块来实现并发请求。通过调整max_workers参数和循环次数,可以模拟不同并发量的情况。
通过测试,我们可以观察到在使用MaxScale之后,数据库的吞吐量相比之前有明显的提升。这是因为MaxScale可以自动将请求分发给不同的数据库节点,实现了负载均衡,从而提高了数据库的处理能力。
结论:
通过使用MaxScale工具,我们可以在不修改应用程序的情况下提高MySQL数据库的吞吐量。MaxScale具有负载均衡、故障转移、缓存、查询路由和查询过滤等功能,可以根据实际应用场景进行配置和调整。在高并发的环境下,合理地使用MaxScale可以帮助我们提高数据库的性能和可靠性。
参考资料:
- MaxScale官方网站:https://mariadb.com/products/skysql/maxscale
- MaxScale文档:https://mariadb.com/kb/en/mariadb-maxscale-21/
- MySQL官方网站:https://www.mysql.com/
理论要掌握,实操不能落!以上关于《提高储存引擎的吞吐量:MaxScale在MySQL中的应用案例》的详细介绍,大家都掌握了吧!如果想要继续提升自己的能力,那么就来关注golang学习网公众号吧!
 使用io/ioutil.ReadFile函数读取文件内容并返回字符串及错误信息
- 上一篇
- 使用io/ioutil.ReadFile函数读取文件内容并返回字符串及错误信息

- 下一篇
- 利用Federated引擎实现MySQL的分布式储存和查询:性能与扩展性分析
-
- 数据库 · MySQL | 20小时前 |
- MySQL 事务隔离级别下间隙锁影响范围的分析方法
- 390浏览 收藏
-
- 数据库 · MySQL | 3天前 |
- MySQL EXPLAIN ANALYZE定位排序临时表的排查方法
- 434浏览 收藏
-
- 数据库 · MySQL | 3天前 | MySQL · JSON ·
- MySQL JSON多值索引处理数组成员检索的设计要点
- 404浏览 收藏
-
- 数据库 · MySQL | 3天前 | MySQL · 数据库 · mysql SQL JSON JSON_TABLE
- MySQL JSON_TABLE为缺失字段提供默认值的映射方法
- 445浏览 收藏
-
- 数据库 · MySQL | 4天前 |
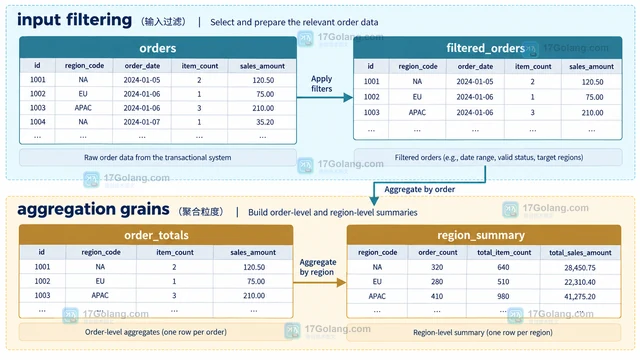
- MySQL CTE拆分多阶段聚合查询的维护方法
- 418浏览 收藏
-
- 数据库 · MySQL | 4天前 | MySQL · 数据库 · mysql 窗口函数 ROW_NUMBER RANK DENSE_RANK
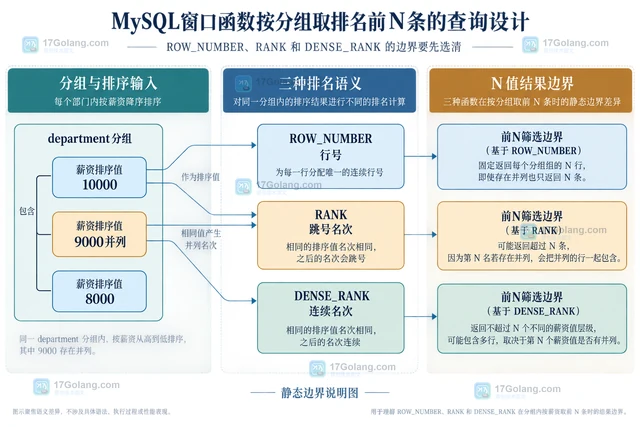
- MySQL窗口函数按分组取排名前N条的查询设计
- 465浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 196次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 252次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 207次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 190次使用
-

- CMMLU
- 深入了解CMMLU中文评估基准,涵盖67个学科主题,提供数据集下载、Zero-shot/Five-shot评估方法及排行榜,助力优化中文语言模型性能。
- 182次使用
-
- MySQL JSON_TABLE 展开数组时如何保留缺失字段
- 2026-09-10 501浏览
-
- MySQL 分区表怎么处理跨分区唯一键:分区列约束与建表取舍
- 2026-08-30 501浏览
-
- MySQL权限管理设置全攻略
- 2026-03-29 501浏览
-
- MySQL分片实现方法及常见方案解析
- 2025-06-24 501浏览
-
- MySQL表空间碎片怎么清理?超详细优化教程
- 2025-06-13 501浏览


