
GitHub 代码复现教程怎么做?项目复现完整流程讲解
想在本地顺利跑通GitHub上的开源项目却总被环境配置、依赖冲突或数据路径问题卡住?这篇教程手把手带你走完从零复现的完整闭环:先精准识别项目可复现性与关键文档,再用pyenv/conda搭建严丝合缝的隔离环境,接着按规范下载并安放数据与模型,然后调试启动脚本攻克首屏报错,最后通过指标比对确认结果真实复现——每一步都直击新手痛点,帮你把“代码下载了但跑不起来”变成“论文结果稳稳复现”。

如果您希望在本地成功运行 GitHub 上的开源项目,但遇到环境配置失败、依赖安装报错或代码无法启动等问题,则可能是由于缺少标准化的复现步骤或环境信息不完整。以下是完成 GitHub 项目代码复现的完整流程:
一、确认项目可复现性与基础信息收集
复现的前提是项目本身具备可复现条件,包括明确的运行环境说明、完整的依赖列表和可执行的入口脚本。需优先检查仓库根目录下的关键文件,以判断是否满足基本复现要求。
1、打开 GitHub 项目主页,浏览 README.md 文件,重点关注 “Installation”、“Requirements”、“Quick Start” 或 “Usage” 章节。
2、检查是否存在 requirements.txt、environment.yml、Dockerfile、setup.py 或 pyproject.toml 等依赖声明文件。
3、查看 .gitignore 文件中是否排除了关键配置或数据文件(如 config.yaml、data/ 目录),若存在,需手动补充或按文档说明下载。
二、搭建隔离且匹配的运行环境
避免系统全局 Python 环境污染及版本冲突,必须为每个项目创建独立环境,并严格对齐作者使用的语言版本与关键库版本。
1、根据 README 或配置文件中声明的 Python 版本(如 Python 3.8),使用 pyenv 或 conda 安装并激活对应版本。
2、若存在 environment.yml,执行:conda env create -f environment.yml;若存在 requirements.txt,执行:python -m venv venv && source venv/bin/activate(Linux/macOS)或 venv\Scripts\activate.bat(Windows) && pip install -r requirements.txt。
3、验证核心依赖是否安装成功:运行 python -c "import torch; print(torch.__version__)"(以 PyTorch 为例),确保输出版本与项目文档一致。
三、获取并组织项目所需资源文件
许多 GitHub 项目依赖外部数据集、预训练模型权重或私有配置,这些通常不会直接托管在仓库中,需按作者指引单独获取并放置到指定路径。
1、查找 README 或 docs/ 目录中关于 “Download dataset”、“Pretrained models” 或 “Prepare data” 的说明段落。
2、使用作者提供的脚本(如 scripts/download_data.sh)或命令(如 gdown --id XXXXXXXX)下载资源。
3、将下载的文件解压后,严格按项目预期路径存放,例如放入 ./data/cifar10/ 或 ./checkpoints/resnet50.pth;路径错误会导致运行时报 FileNotFoundError。
四、执行代码并调试首次运行
在环境与资源就绪后,通过标准入口启动项目,观察日志输出,定位首屏报错原因,这是复现中最关键的调试阶段。
1、查找项目根目录下常见的启动文件,如 train.py、main.py、run.sh 或 notebooks/train.ipynb。
2、在已激活的虚拟环境中,执行启动命令,例如:python train.py --config configs/default.yaml;若为 Jupyter Notebook,需确保内核已切换至当前环境。
3、若报错提示 “ModuleNotFoundError”,检查是否遗漏 pip install -e .(存在 setup.py 时);若报错 “CUDA out of memory”,尝试添加 --batch-size 4 降低显存占用。
五、验证结果一致性
成功运行不等于复现完成,必须比对关键输出指标(如 loss 曲线、准确率、生成图像)是否与作者公开结果一致,以确认复现有效性。
1、运行作者提供的评估脚本(如 python eval.py --checkpoint checkpoints/best.pth),记录 top-1 accuracy 或 mAP 数值。
2、对比 README 或论文附录中公布的基准结果,允许 ±0.5% 以内的浮动(受随机种子、硬件精度差异影响)。
3、若差异显著,检查是否遗漏 --seed 42、--deterministic 或 CUDA_LAUNCH_BLOCKING=1 等控制随机性与调试的参数。
今天关于《GitHub 代码复现教程怎么做?项目复现完整流程讲解》的内容介绍就到此结束,如果有什么疑问或者建议,可以在golang学习网公众号下多多回复交流;文中若有不正之处,也希望回复留言以告知!
 探索文心一言AI入口 文心一言网页版免费使用入口
- 上一篇
- 探索文心一言AI入口 文心一言网页版免费使用入口
- 下一篇
- 如何通过css调整元素padding和margin组合
-
- 文章 · 软件教程 | 1小时前 | github · 软件教程 · GitHub Pull Request CODEOWNERS 代码评审
- GitHub 怎么用 CODEOWNERS 自动请求评审
- 437浏览 收藏
-
- 文章 · 软件教程 | 8小时前 | 软件教程 · VS Code 全局搜索 Search Editor code-search
- VS Code 怎么把搜索结果保存到编辑器标签页
- 204浏览 收藏
-
- 文章 · 软件教程 | 1天前 |
- Chrome DevTools Coverage定位未使用CSS并验证删除风险
- 417浏览 收藏
-
- 文章 · 软件教程 | 3天前 |
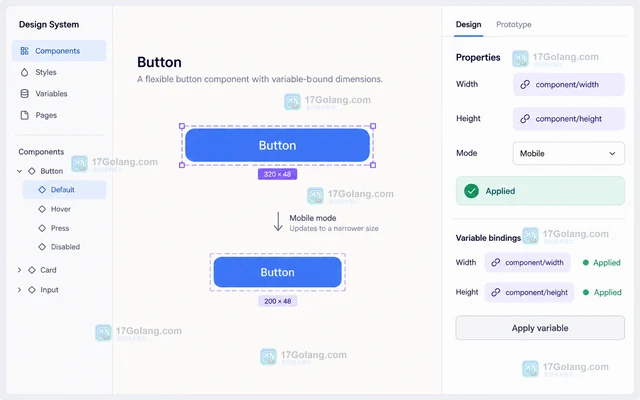
- Figma变量绑定组件尺寸并保持设计令牌一致的方法
- 189浏览 收藏
-
- 文章 · 软件教程 | 6天前 | 商汤Seko批量产出抽样验收 短剧批量制作质检方法 首件全检操作规范 短视频批量抽检策略 内容工作室交付复核流程
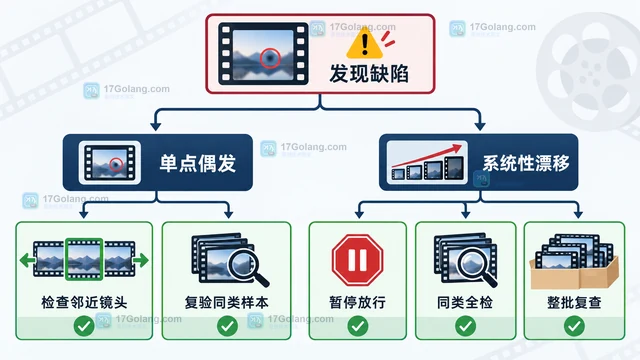
- 商汤Seko批量产出怎么做抽样验收?首件全检、过程抽检与批尾复核
- 337浏览 收藏
-
- 文章 · 软件教程 | 6天前 | 商汤Seko批量产出顺序 短剧批量内容排产方法 高复用镜头优先处理技巧 Seko短剧生成教程 内容工作室批量生产流程
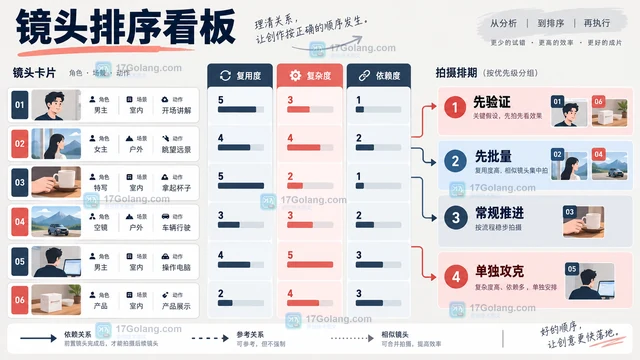
- 商汤Seko批量产出怎么安排先后顺序?先做高复用镜头再处理特殊镜头
- 109浏览 收藏
-
- 文章 · 软件教程 | 6天前 | 商汤Seko批量生成漏镜头 短剧镜头核对方法 AI视频批量补单技巧 短视频工作室生产流程 短剧批量产出效率优化
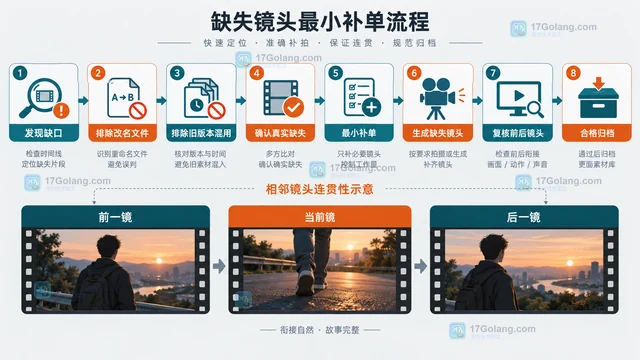
- 商汤Seko批量产出总有镜头漏生成怎么办?清单核对与补单方法
- 150浏览 收藏
-
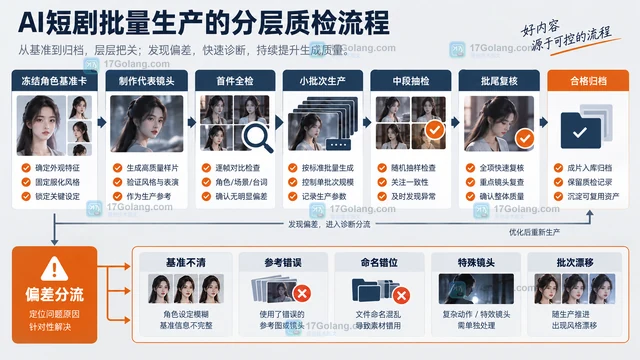
- 文章 · 软件教程 | 6天前 | 商汤Seko批量产出角色统一 Seko短剧角色一致性方法 AI生成角色基准卡搭建 短剧工作室批量素材管理 AI短剧分层抽检实操
- 商汤Seko批量产出怎么保持角色统一?模板、命名与抽检方法
- 111浏览 收藏
-
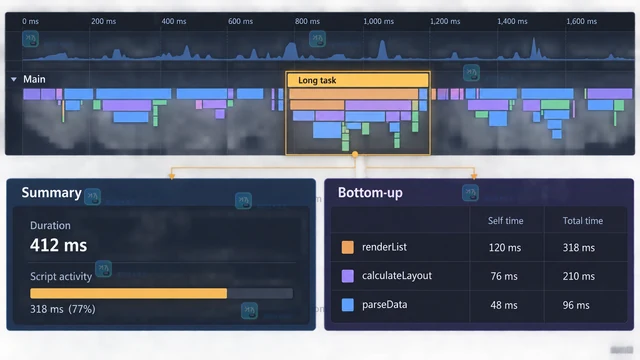
- 文章 · 软件教程 | 6天前 |
- Chrome DevTools Performance用Main线程火焰图定位脚本耗时
- 388浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 229次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 275次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 241次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 222次使用
-
- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 21次使用
-
- VS Code 怎么给 Go 项目配置测试任务:tasks.json 运行与结果验收
- 2026-07-09 501浏览
-
- Windows 11 如何开启 HEIF 图片支持
- 2026-05-31 501浏览
-
- TikTok用户画像与付费订阅变现方法
- 2026-05-27 501浏览
-
- 学信网学历翻译件申请方法
- 2026-05-27 501浏览
-
- Windows 11 24H2 更新失败0x80070005解决方法
- 2026-05-26 501浏览