
驼峰拆分技巧:前三字母切分,后续按大小写分
本文揭秘了处理特殊驼峰命名字符串(如“FORfirstUpload”)的两种高效拆分技巧:一种是融合固定长度前瞻断言的单正则多条件匹配,简洁但稍显晦涩;另一种是逻辑清晰、易于理解与维护的两步法——先精准提取前三字母前缀,再对剩余部分进行标准驼峰分词,完美解决API字段、协议标识等场景中“大写前缀强制单字符化+后续驼峰自然切分”的双重需求,兼顾准确性与工程可读性。

本文介绍两种可靠方法,将类似 "FORfirstUpload" 的字符串拆解为 ['F','O','R','first','Upload']:一种是单正则多条件匹配(含固定长度前瞻断言),另一种是更清晰、可维护的两步法(前缀提取 + 驼峰分词)。
本文介绍两种可靠方法,将类似 "FORfirstUpload" 的字符串拆解为 ['F','O','R','first','Upload']:一种是单正则多条件匹配(含固定长度前瞻断言),另一种是更清晰、可维护的两步法(前缀提取 + 驼峰分词)。
在处理 API 响应字段名、协议标识符或自定义编码格式时,常遇到一类特殊命名模式:前缀为固定数量(如 3 个)的大写字母,后续部分遵循驼峰命名规则(如 firstUpload → first, Upload)。标准驼峰分割(如 re.findall(r'[A-Z][a-z]*|[a-z]+', s))无法满足“前三字母强制单字符拆分”的需求,需定制化逻辑。
✅ 方法一:单正则多分支匹配(适用于简单场景)
该方案使用一个正则表达式,通过显式枚举前三位大写字母的位置关系,并结合单词边界(\b)与固定长度正向回顾((?<=...))实现精准定位:
import re

def split_special_camel(s: str) -> list:
    pattern = r'\b[A-Z]|(?<=\b[A-Z])[A-Z]|(?<=\b[A-Z]{2})[A-Z]|[a-z]+|[A-Z][a-z]*'
    return re.findall(pattern, s)

# 示例
print(split_special_camel("FORfirstUpload"))  # ['F', 'O', 'R', 'first', 'Upload']
print(split_special_camel("ABnextPartXYZtest")) # ['A', 'B', 'next', 'Part', 'XYZtest'] ❌ 不符合预期
⚠️ 注意:此正则依赖 \b 定位单词起始,且仅对恰好以连续大写字母开头、且前缀不超过 3 位的字符串有效。若输入为 "ABnextPart"(仅两位前缀),它会错误地将 'AB' 拆成 'A', 'B',但后续 'nextPart' 仍被正确分为 'next', 'Part';而 "XYZtest" 中的 'XYZ' 会被整体匹配为 'XYZtest'(因不满足“大写+小写”结构),因此该方案隐含前提:前缀严格为 1–3 个大写字母,且第 4 字符起必须是小写字母(即驼峰起始)。
✅ 方法二:清晰两步法(推荐用于生产环境)
将问题解耦为两个语义明确的步骤:先提取前缀(最多 3 个大写字母),再对剩余部分执行标准驼峰分词。逻辑直观、易于调试和扩展:
import re

def split_special_camel_v2(s: str) -> list:
    # 步骤1:提取开头最多3个连续大写字母作为前缀
    match = re.match(r'^([A-Z]{0,3})(.*)', s)
    if not match:
        return list(s)  # 降级处理:全字符拆分

    prefix, rest = match.groups()

    # 步骤2:对 rest 执行驼峰分词 —— 匹配"首字符+后续小写字母"或单独小写序列
    # 注意:此处使用 [A-Z][a-z]* 匹配大驼峰词(如 Upload),[a-z]+ 匹配小驼峰词(如 first)
    camel_parts = re.findall(r'[A-Z][a-z]*|[a-z]+', rest)

    return list(prefix) + camel_parts

# 测试用例
print(split_special_camel_v2("FORfirstUpload"))    # ['F', 'O', 'R', 'first', 'Upload']
print(split_special_camel_v2("ABnextPart"))        # ['A', 'B', 'next', 'Part']
print(split_special_camel_v2("Xsimple"))          # ['X', 'simple']
print(split_special_camel_v2("NoPrefixHere"))     # ['', 'No', 'Prefix', 'Here'] → 注意:prefix为空,结果以驼峰为主
✅ 优势总结:
- 鲁棒性强:能优雅处理前缀不足 3 位(如 "Xsimple")、无前缀(如 "simpleTest")等边界情况;
- 可读性高:每步意图清晰,便于团队协作与后期维护;
- 易扩展:如需支持数字后缀("FOR123upload")、下划线兼容等,可在 rest 处理阶段灵活增强。
? 最终建议
- 若处理数据格式高度统一(如固定 3位大写+驼峰 的协议字段),可选用方法一以减少函数调用开销;
- 绝大多数场景下,强烈推荐方法二——它将复杂逻辑分解为原子操作,符合 Python “显式优于隐式” 和 “可读性至上” 的设计哲学,且避免了正则中难以调试的回顾断言陷阱。同时,可通过封装为工具函数并添加类型注解与文档字符串,进一步提升工程可用性。
今天带大家了解了的相关知识,希望对你有所帮助;关于文章的技术知识我们会一点点深入介绍,欢迎大家关注golang学习网公众号,一起学习编程~
 JavaScript单例模式详解与实现方法
- 上一篇
- JavaScript单例模式详解与实现方法

- 下一篇
- 拼多多2025双11红包领取攻略
-
- 文章 · python教程 | 23小时前 |
- Python logging lastResort 怎样处理没有配置 handler 的日志
- 289浏览 收藏
-
- 文章 · python教程 | 23小时前 | 并发编程 · Python教程 · Python logging 后台线程 logging.handlers.QueueListener 日志关闭
- Python logging.handlers.QueueListener 怎样优雅停止后台日志线程
- 143浏览 收藏
-
- 文章 · python教程 | 23小时前 |
- Python tomllib 怎样读取二进制 TOML
- 114浏览 收藏
-
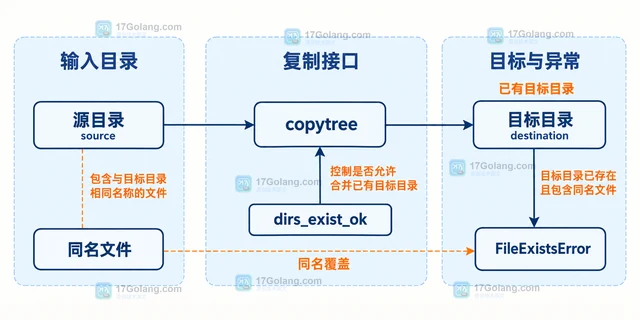
- 文章 · python教程 | 23小时前 | 文件处理 · Python教程 · Python 目录复制 shutil.copytree dirs_exist_ok 文件覆盖
- Python shutil.copytree 怎样合并已有目标目录
- 165浏览 收藏
-
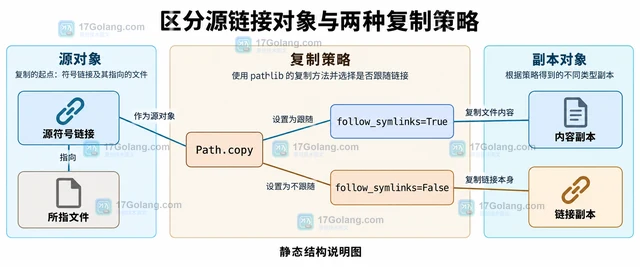
- 文章 · python教程 | 23小时前 |
- Python pathlib 复制文件时怎样控制符号链接
- 478浏览 收藏
-
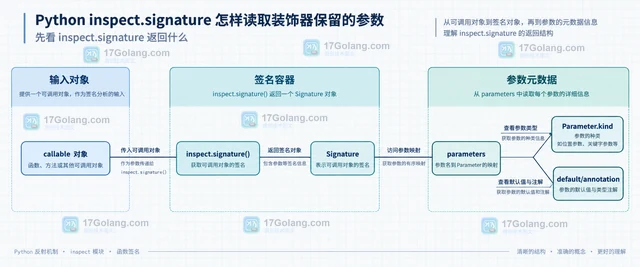
- 文章 · python教程 | 23小时前 |
- Python inspect.signature 怎样读取装饰器保留的参数
- 298浏览 收藏
-
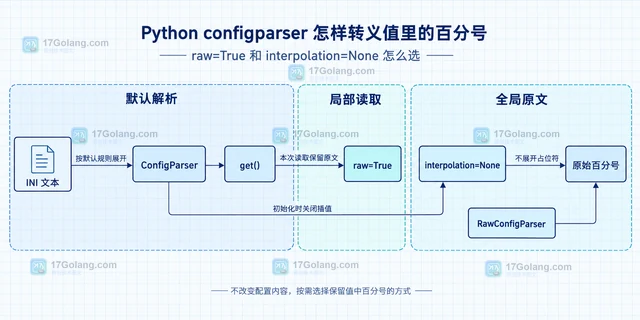
- 文章 · python教程 | 23小时前 |
- Python configparser 怎样转义值里的百分号
- 393浏览 收藏
-
- 文章 · python教程 | 1天前 |
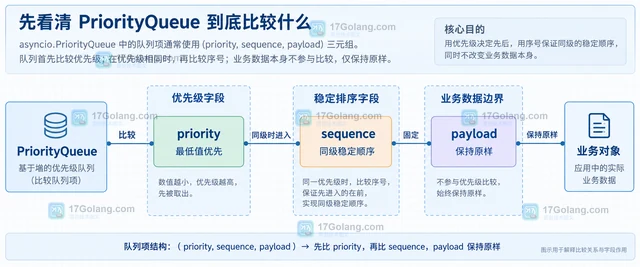
- Python asyncio.PriorityQueue 怎样保持相同优先级的稳定顺序
- 306浏览 收藏
-
- 文章 · python教程 | 1天前 |
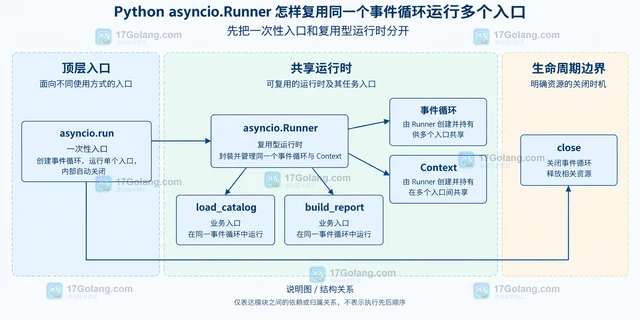
- Python asyncio.Runner 怎样复用同一个事件循环运行多个入口
- 204浏览 收藏
-
- 文章 · python教程 | 1天前 |
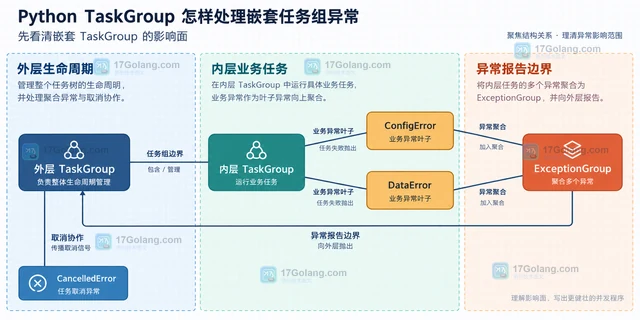
- Python TaskGroup 怎样处理嵌套任务组异常
- 319浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 487次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 542次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 563次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 520次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 333次使用
-
- Python sqlite3 Connection serialize 怎么导出数据库快照:备份窗口、内存占用与恢复校验
- 2026-08-26 501浏览
-
- Python监控网页状态:requests异常处理实战
- 2026-05-29 501浏览
-
- TensorFlow模型部署为API的TF Serving方法
- 2026-05-26 501浏览
-
- Python字符串编码转换:encode与decode详解
- 2026-05-16 501浏览
-
- TensorFlow裁剪无用算子方法详解
- 2026-05-15 501浏览