
LaravelScout搜索性能评测分析
2026-02-18 22:12:49
0浏览
收藏
Laravel Scout 并非开箱即用的搜索引擎,而是一个高度灵活却“不带引擎”的搜索抽象层,其实际能力完全取决于你选择的驱动——MySQL 驱动仅是 FULLTEXT 的轻量封装,中文支持差、功能简陋;MeiliSearch 凭借开箱中文分词、纠错、低运维成本和良好 Scout 兼容性,成为中小项目的最优解;Algolia 和 Elasticsearch 虽功能强大,却分别受限于费用、数据隐私与部署复杂度;真正决定搜索质量的,往往不是驱动本身,而是开发者对 `toSearchableArray()` 的精准把控——字段筛选、内容清洗、格式统一,稍有不慎就会导致索引静默失败或搜索效果断崖式下滑。
Laravel Scout 本身不提供搜索能力,它只是一个搜索抽象层,强不强,完全取决于你选的驱动。
直接说结论:Scout 的集成能力很强,但“搜索强不强”是假问题——它像 USB 接口,插 SSD 还是 U 盘,性能天差地别。关键在驱动选得对不对、配得稳不稳。
MySQL 驱动真能搜?别被名字骗了
MySQL 驱动(database)本质是用 MATCH ... AGAINST + FULLTEXT 索引,不是“全文搜索引擎”,而是 MySQL 原生功能的轻量封装。
- ✅ 适合小到中型项目:博客文章、商品简要描述、后台管理搜索
- ❌ 不支持模糊匹配、拼音搜索、同义词、分词权重、高亮等高级特性
- ⚠️ 容易踩坑:
- 表引擎必须是
MyISAM或InnoDB(5.6+),且字段需显式加FULLTEXT索引 - 中文搜索基本失效(MySQL 原生 FULLTEXT 对中文支持极弱,除非用 ngram 插件且配置
ft_min_word_len=1) scout:import导入时若字段含 NULL,可能静默跳过整条记录
- 表引擎必须是
-- 检查是否已建 FULLTEXT 索引(以 posts 表为例)
SHOW INDEX FROM posts WHERE Key_name = 'fulltext_title_content';
-- 若无,需手动添加(Scout 不自动建)
ALTER TABLE posts ADD FULLTEXT(title, content);
MeiliSearch 是当前最平衡的选择
2026 年初,meilisearch/meilisearch-php v1.10+ 已深度适配 Scout v10+,是中小型 Laravel 项目事实上的默认推荐。
- ✅ 开箱即用的中文分词(基于
tantivy引擎)、拼写纠错、同义词、过滤、排序、分页 - ✅ 启动快、内存占用低,Docker 一条命令就能跑:
docker run -d -p 7700:7700 -v $(pwd)/data.ms:/data.ms getmeili/meilisearch - ⚠️ 注意兼容性陷阱:
SCOUT_QUEUE=true必须开启,否则新增/更新模型时索引不同步(Scout 默认同步调用,而 MeiliSearch SDK 的批量操作是异步的)toSearchableArray()返回的字段类型必须是字符串或标量;返回数组或对象会触发JSON encode failed错误- 删除模型后,
scout:flush不清空 MeiliSearch 索引,得手动调用MeiliSearchClient::index('posts')->deleteAllDocuments()
Algolia 和 Elasticsearch:强但有代价
Algolia:搜索体验最强(实时、AI 建议、A/B 测试),但属于 SaaS,2026 年免费额度缩至每月 1 万次操作,超出后按 $0.99/万次计费。适合 ToC 产品,不适合内部系统或数据敏感场景。Elasticsearch:功能最全,但 Scout 官方不维护 ES 驱动,社区包(如babenkoalex/laravel-scout-elasticsearch)维护滞后,v8.x 兼容性常出问题;Java 进程吃内存,部署运维成本高。
两者共性风险:
- 模型变更后,
scout:import可能因字段映射不一致导致索引失败,错误日志藏在队列失败任务里(failed_jobs表),不易发现 search()方法链式调用(如->where('status', 1)->paginate())在 Algolia 中有效,在 ES 驱动中部分条件可能被忽略——因为底层 API 语义不统一
toSearchableArray() 不只是“选字段”,它是搜索质量的开关
这个方法决定什么进索引、以什么形式进,直接影响召回率和准确率。
- ❌ 错误写法:
return $this->toArray();—— 把所有字段(含 JSON、时间戳、关联 ID)塞进去,浪费空间、拖慢搜索、干扰相关性 - ✅ 推荐做法:
- 只保留用户真正搜索的字段(
title,content,tags) - 预处理:把
tags数组 implode 成字符串;把 HTML 内容 strip_tags() - 加权字段:MeiliSearch 支持
searchableAttributes排序,把标题放前面,内容放后面
- 只保留用户真正搜索的字段(
public function toSearchableArray()
{
    return [
        'title' => $this->title,
        'summary' => strip_tags($this->excerpt),
        'content' => strip_tags($this->content),
        'tags' => implode(' ', $this->tagNames()),
    ];
}
真正容易被忽略的是:Scout 不校验字段内容合法性。比如你传了个 null 或 resource 进去,某些驱动(尤其是 MeiliSearch)会在导入时静默丢弃整条记录,而控制台毫无提示——必须查队列失败任务或启用 Scout 日志(scout.log)。
以上就是《LaravelScout搜索性能评测分析》的详细内容,更多关于的资料请关注golang学习网公众号!
 优酷关闭自动播放设置教程
- 上一篇
- 优酷关闭自动播放设置教程
- 下一篇
- HTML5聊天窗口嵌入教程详解
查看更多
最新文章
-
- 文章 · php教程 | 2小时前 |
- PHP Fiber 中异常抛出与 finally 清理顺序
- 441浏览 收藏
-
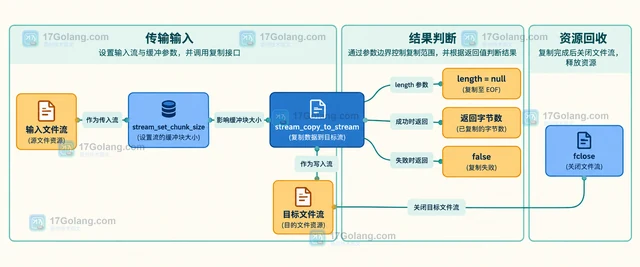
- 文章 · php教程 | 2小时前 | 性能 · PHP · php 大文件传输 stream_set_chunk_size
- PHP stream_set_chunk_size 对大文件传输的缓冲影响
- 288浏览 收藏
-
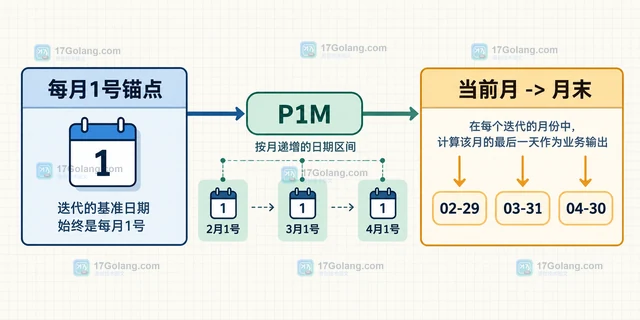
- 文章 · php教程 | 2小时前 | php教程 · php DateInterval 月末日期 DatePeriod 按月迭代
- PHP DatePeriod 按月迭代时怎样避免月末日期漂移
- 109浏览 收藏
-
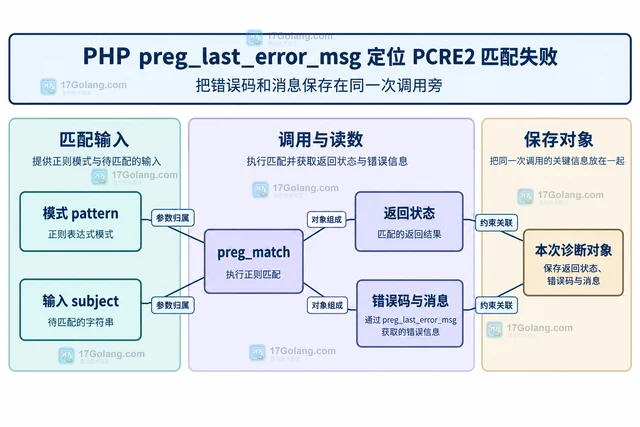
- 文章 · php教程 | 2小时前 |
- PHP preg_last_error_msg 定位 PCRE2 匹配失败
- 492浏览 收藏
-
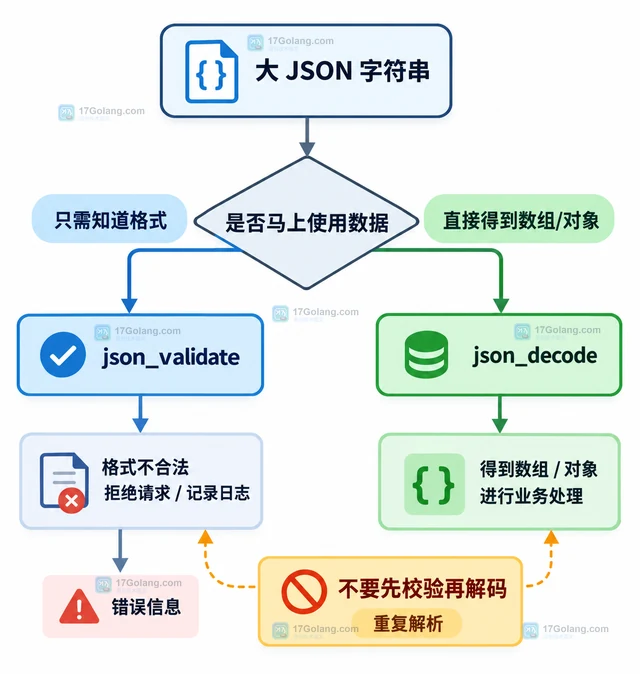
- 文章 · php教程 | 2小时前 |
- PHP json_validate 预检大 JSON 字符串的内存边界
- 299浏览 收藏
-
- 文章 · php教程 | 2小时前 | 反射 · PHP ·
- PHP ReflectionProperty::isInitialized 怎么避免读取未初始化属性
- 372浏览 收藏
-
- 文章 · php教程 | 3小时前 | 异常处理 · PHP ·
- PHP match 表达式未命中时的异常处理
- 113浏览 收藏
-
- 文章 · php教程 | 3小时前 | 数据类型 · 数据库 · php pdo 数据库映射 枚举 backed enum
- PHP 枚举 backed value 与数据库字段映射方案
- 452浏览 收藏
-
- 文章 · php教程 | 3小时前 |
- PHP PharData::compressFiles 怎样批量压缩归档文件
- 365浏览 收藏
-
- 文章 · php教程 | 3小时前 | 反射 · 枚举 · php教程 · php backed enum ReflectionEnum::getBackingType 枚举反射 ReflectionNamedType
- PHP ReflectionEnum::getBackingType 怎样区分 backed enum
- 166浏览 收藏
-
- 文章 · php教程 | 3小时前 |
- PHP fputcsv 怎样让带换行的字段保持一列
- 410浏览 收藏
查看更多
课程推荐
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
查看更多
AI推荐
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 821次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 813次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 904次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 874次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 696次使用
查看更多
相关文章
-
- PHP fgetcsv escape 参数显式设置与 RFC 4180 兼容处理
- 2026-10-26 501浏览
-
- PHP JSON_THROW_ON_ERROR 抛错后怎么保留原始字段位置
- 2026-09-09 501浏览
-
- PHP 8.5 array_last() 怎么处理空数组:从 null 结果到兼容旧版本的 Polyfill
- 2026-08-16 501浏览
-
- 宝塔配置Ruby环境:RVM+Nginx反代教程
- 2026-05-29 501浏览
-
- unset函数作用范围详解
- 2026-05-29 501浏览


