
图书管理系统设计:ListMap实战应用
本文深入剖析了图书管理系统开发中List与Map两大核心集合的实际应用策略,从ArrayList为何比LinkedList更适合图书列表、HashMap自定义key的正确实现要点、遍历Map时entrySet()对性能的关键提升,到多层嵌套集合中null安全的优雅处理,全程紧扣真实业务场景(如尾部批量增删、ISBN快速查询、按用户/年份归类借阅记录),破除“链表适合增删”的机械认知误区,直击开发者易踩的性能陷阱与空指针雷区,提供兼具可读性、健壮性与高效率的Java集合实战指南。
为什么用 ArrayList 而不是 LinkedList 存图书列表
图书管理系统里,图书增删集中在尾部(比如批量导入、新书上架),查询多于插入中间位置。这时候 ArrayList 的随机访问 O(1) 和缓存友好性明显胜出;LinkedList 的每个节点指针开销反而拖慢遍历和迭代——尤其当图书对象本身不大时,指针成本占比更高。
常见错误是看到“链表适合频繁增删”就直接套用,但没注意增删位置:图书列表极少在中间插入(比如第 37 本前插一本),真要那样,不如先用 ArrayList + add(index, element),再观察性能瓶颈是否真的来自这一步。
- 新增图书一律用
list.add(book),别写list.add(list.size(), book)—— 效果一样,后者多一次计算还干扰阅读 - 避免在 for 循环里反复调用
list.size()判断长度,JVM 一般会优化,但明确写成int n = list.size(); for (int i = 0; i 更稳 - 如果后期真需要按 ISBN 快速查某本书,别硬扛着遍历
ArrayList,立刻补一层Map,键用book.getIsbn()
HashMap 的 key 为什么必须重写 hashCode() 和 equals()
图书借阅模块常用 Map 按作者归类,或 Map 按 ISBN 查书。一旦 key 是自定义对象(比如用 BookId 类封装 ISBN),不重写这两个方法,get() 就永远返回 null——因为默认的 hashCode() 返回的是内存地址哈希,两次 new 出来的对象哪怕内容相同,哈希值也不同。
典型报错现象:map.put(new BookId("978-7-02-000000-0"), book); 之后 map.get(new BookId("978-7-02-000000-0")) 拿不到值,调试发现 size 是 1,但 get 失败。
- IDE 自动生成的
hashCode()/equals()只要覆盖所有参与逻辑相等判断的字段(比如 ISBN 字符串)就行,别漏掉 null 检查 - 别用可变字段做 key 的计算依据(例如把
Book.title当 key 字段又允许改标题),否则 map 内部桶位置错乱,数据就丢了 - 如果 key 纯是字符串(如直接用
isbn当 key),不用额外处理——String已经重写好了
遍历借阅记录 Map 时,该用 entrySet() 还是 keySet()
展示“张三借了哪些书”这类功能,代码常写成 for (String userId : borrowMap.keySet()) { List。这看起来自然,但每次 get() 都是一次哈希查找,时间复杂度从 O(n) 变成 O(n × 平均查找耗时),数据量大时肉眼可感卡顿。
真实场景中,借阅记录 Map 可能有上千个用户,每个用户平均借 3–5 本书。用 entrySet() 直接拿到键值对,既少一次哈希定位,又避免重复构造 Iterator。
- 优先写
for (Map.Entry,然后用entry.getKey()和entry.getValue() - 如果只用 value(比如统计所有借出图书总数),用
values()最干净:int total = borrowMap.values().stream().mapToInt(List::size).sum(); - 千万别在循环里修改正在遍历的 map(比如边查边删过期记录),会抛
ConcurrentModificationException;要删得先收集 key,再统一removeAll()
List 和 Map 嵌套太深时,怎么避免 NullPointerException
Map 这种三层结构很常见(用户 → 年份 → 图书列表),但每层都可能为 null:用户没借过书、某年没借书、甚至年份 key 根本不存在。直接链式调用 userBooksByYear.get(userId).get("2024").size() 必崩。
不是靠一堆 if 判断,而是用“容器即空值”的思维:让每一层缺失时返回空集合,而不是 null。Java 8+ 推荐用 computeIfAbsent() 初始化,比手写 if-null-put 清晰得多。
- 初始化嵌套 map:
userBooksByYear.computeIfAbsent(userId, k -> new HashMap<>()).computeIfAbsent("2024", k -> new ArrayList<>()).add(book); - 读取时仍要防第一层 null:
Map后加一句if (yearMap == null) return Collections.emptyList(); - 别依赖 IDE 自动补全的
Objects.requireNonNull(),它只是提前报错,没解决空值语义问题
嵌套越深,初始化责任越往前移——不是等用到才检查,而是在第一次 put 时就确保路径畅通。这点容易被忽略,直到线上查半天才发现某类用户数据根本进不了第三层。
终于介绍完啦!小伙伴们,这篇关于《图书管理系统设计:ListMap实战应用》的介绍应该让你收获多多了吧!欢迎大家收藏或分享给更多需要学习的朋友吧~golang学习网公众号也会发布文章相关知识,快来关注吧!
 联想主机电源故障0x0000007F怎么解决
- 上一篇
- 联想主机电源故障0x0000007F怎么解决
- 下一篇
- Win10U盘不关机设置教程
-
- 文章 · java教程 | 12小时前 | Java · java peek xml StAX XMLEventReader nextEvent
- Java XMLEventReader 的peek与nextEvent有什么区别
- 266浏览 收藏
-
- 文章 · java教程 | 12小时前 |
- Java CardLayout 怎样按名称切换容器中的卡片
- 435浏览 收藏
-
- 文章 · java教程 | 13小时前 |
- Java XMLStreamWriter 为什么不能自动修复所有XML结构错误
- 317浏览 收藏
-
- 文章 · java教程 | 13小时前 | Java · xml · java StAX XML命名空间 XMLStreamWriter writeNamespace
- Java XMLStreamWriter 怎样写入带命名空间的元素
- 204浏览 收藏
-
- 文章 · java教程 | 15小时前 |
- Java XMLEventReader 怎样逐事件读取XML
- 287浏览 收藏
-
- 文章 · java教程 | 16小时前 | Java ·
- Java StringCharacterIterator 的结束哨兵为什么不是null
- 331浏览 收藏
-
- 文章 · java教程 | 16小时前 |
- Java StringCharacterIterator 怎样限定字符遍历区间
- 246浏览 收藏
-
- 文章 · java教程 | 17小时前 |
- Java JMOD与模块化JAR的用途有什么区别
- 368浏览 收藏
-
- 文章 · java教程 | 18小时前 |
- Java jmod 怎样列出模块归档中的文件
- 401浏览 收藏
-
- 文章 · java教程 | 20小时前 |
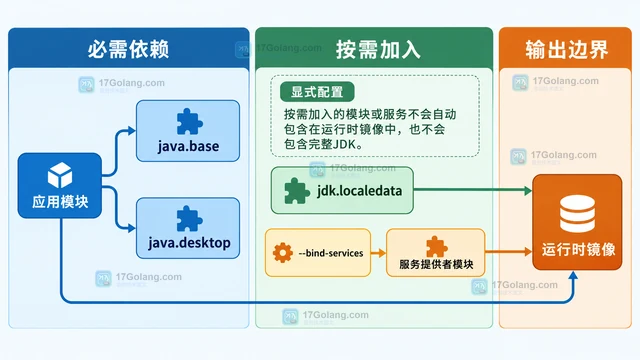
- Java jlink 运行时镜像为什么不包含完整JDK
- 500浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 816次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 807次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 898次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 869次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 693次使用
-
- Java 时间格式兼容多个输入格式的方法
- 2026-10-18 501浏览
-
- Java try-with-resources 多个资源关闭顺序是什么
- 2026-09-10 501浏览
-
- 矩阵主副对角线快速定位技巧
- 2026-05-31 501浏览
-
- Java多态优化流程代码与行为分发改进
- 2026-05-26 501浏览
-
- JVM 类元数据双亲委派链表深度解析
- 2026-05-21 501浏览


