
Pandas末尾标点处理方法解析
2026-02-16 15:12:44
0浏览
收藏
本文揭秘了如何用Pandas几行代码高效实现“标点行自动复制+去标点生成”——精准识别以问号、句号或感叹号结尾的文本行,并批量创建其无标点副本,整个过程完全向量化、零循环,兼顾速度与简洁性;无论是为NLP模型构建带/不带标点的平行训练数据,还是在文本预处理中增强语料多样性,这一技巧都能显著提升数据准备效率,尤其适合处理大规模文本数据集。

本文介绍如何使用 Pandas 高效识别并复制以问号、句号或感叹号结尾的行,同时生成对应无标点的副本,适用于文本预处理、数据增强等场景。
本文介绍如何使用 Pandas 高效识别并复制以问号、句号或感叹号结尾的行,同时生成对应无标点的副本,适用于文本预处理、数据增强等场景。
在自然语言处理或文本分析任务中,常需对带标点的句子进行数据扩充——例如,将 "Hi!" 同时保留原样和去标点形式 "Hi",以增强模型对句式变体的鲁棒性。Pandas 提供了简洁高效的向量化操作来实现这一需求,无需循环,全程基于布尔索引与字符串方法。
核心思路分三步:
- 筛选目标行:使用 .str.endswith() 检测 msg 列是否以 '?'、'.' 或 '!' 结尾(注意:该方法接受元组作为参数,支持多字符匹配);
- 构造副本:对筛选出的子集,用 .str[:-1] 移除末尾单个字符(假设仅末尾存在一个标点,且无空格干扰);
- 合并结果:通过 pd.concat() 将原始 DataFrame 与处理后的副本纵向拼接,保持原有索引并自动重排。
以下是完整可运行示例:
import pandas as pd

# 构造示例数据
df = pd.DataFrame({
    'msg': ['hello', 'hi!', 'What?', 'OK.', 'test'],
    'label': [1, 0, 2, 3, 4]
})

# 步骤1:筛选以 ?, ., ! 结尾的行
mask = df['msg'].str.endswith(('?', '.', '!'))
punc_rows = df[mask].copy()  # 显式 copy 避免 SettingWithCopyWarning

# 步骤2:移除末尾标点(安全起见,推荐使用 str.rstrip() 或正则更健壮)
punc_rows['msg'] = punc_rows['msg'].str[:-1]

# 步骤3:合并原始数据与新增副本
result = pd.concat([df, punc_rows], ignore_index=True)

print(result)
输出:
     msg  label
0  hello      1
1    hi!      0
2  What?      2
3    OK.      3
4   test      4
5     hi      0
6   What      2
7     OK      3
✅ 注意事项与优化建议:
- .str.endswith(('?', '.', '!')) 比链式调用 .str.endswith('?') | ... 更高效且可读;
- 若字符串末尾可能存在空格(如 "hi! "),.str[:-1] 会误删空格而非标点,此时应改用正则:
punc_rows['msg'] = punc_rows['msg'].str.replace(r'[?.!]$', '', regex=True)
- 使用 ignore_index=True 可重置索引,避免重复索引影响后续操作;
- 对于大规模数据,该方案时间复杂度为 O(n),远优于 apply() + lambda 循环。
掌握此技巧,你就能在数据清洗阶段快速构建带/不带标点的平行语料,为下游任务提供更丰富的训练样本。
本篇关于《Pandas末尾标点处理方法解析》的介绍就到此结束啦,但是学无止境,想要了解学习更多关于文章的相关知识,请关注golang学习网公众号!
 HTML5插入缩略图预览方法
- 上一篇
- HTML5插入缩略图预览方法

- 下一篇
- Win11外接显示器无声音解决方法
查看更多
最新文章
-
- 文章 · python教程 | 30分钟前 | python · decimal · 数值计算 · context Python Decimal quantize localcontext
- Python decimal 局部精度和全局上下文如何隔离
- 346浏览 收藏
-
- 文章 · python教程 | 20小时前 | csv · python · csv DictReader restkey restval
- csv DictReader 缺列怎么配置或排查
- 434浏览 收藏
-
- 文章 · python教程 | 21小时前 | 包管理 · python · 排错 · Python版本 pyproject.toml importlib.metadata
- importlib.metadata 版本怎么配置或排查
- 287浏览 收藏
-
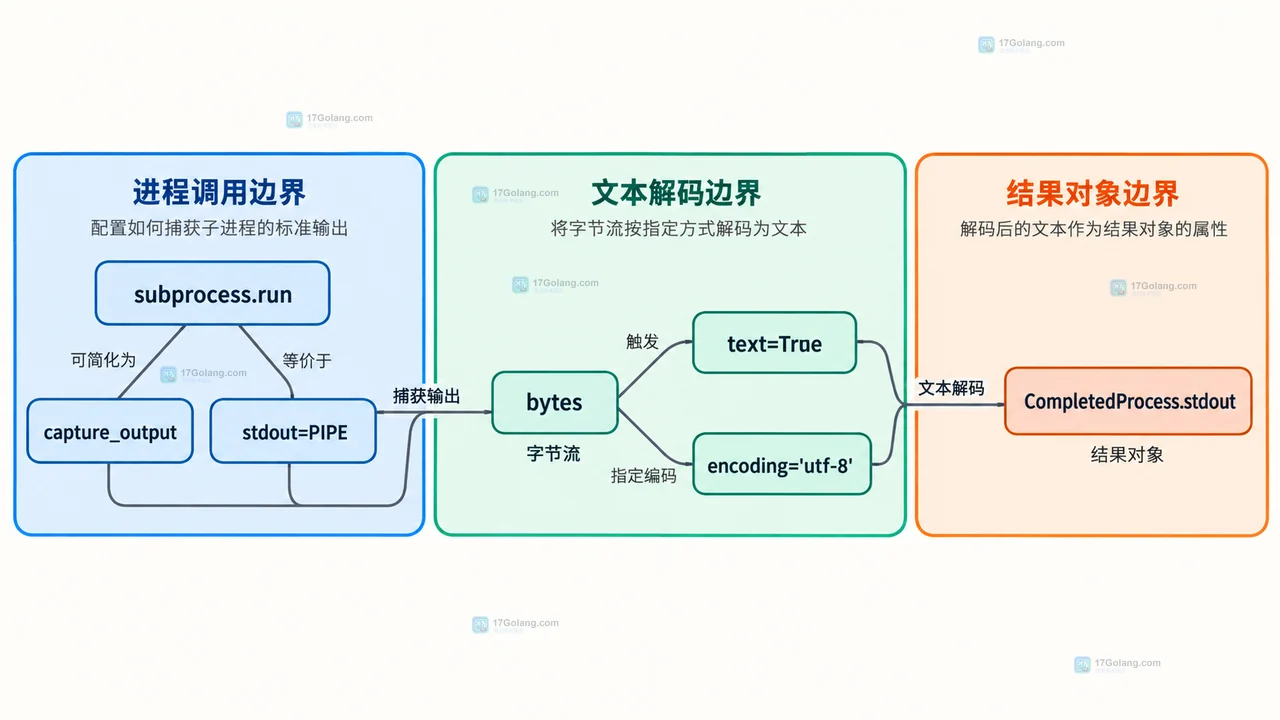
- 文章 · python教程 | 22小时前 | 命令行 · 编码 · python · subprocess · encoding subprocess TEXT stdout stderr
- subprocess 文本输出怎么配置或排查
- 444浏览 收藏
-
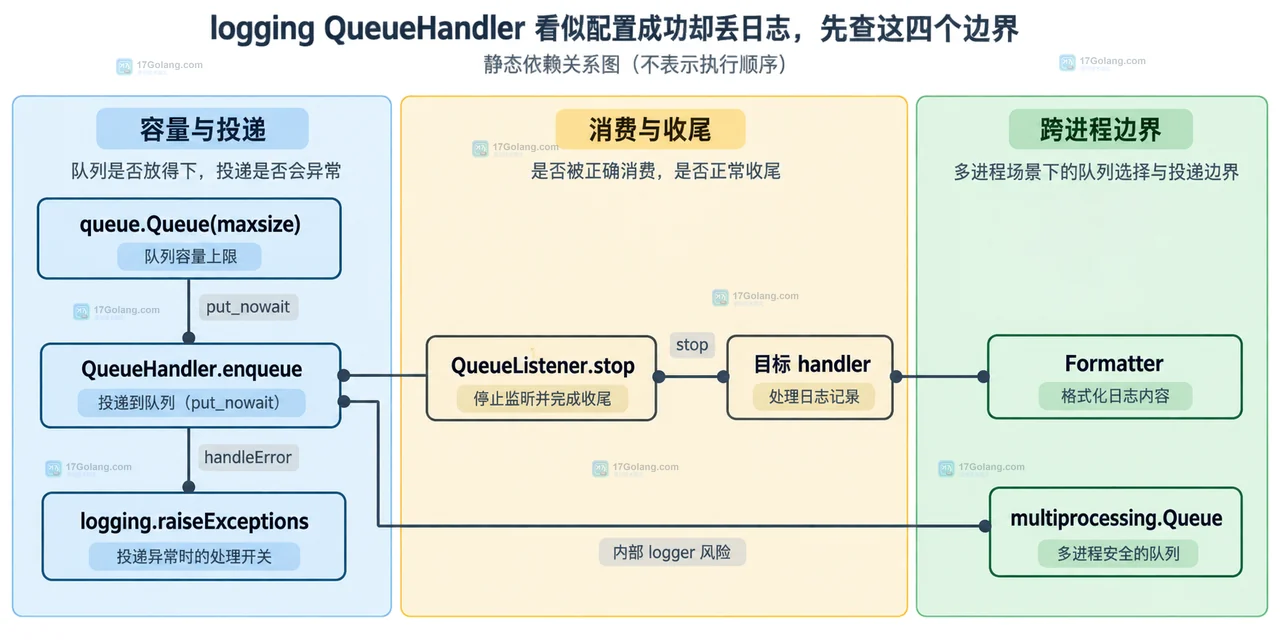
- 文章 · python教程 | 1天前 | python · logging · QueueListener · QueueHandler ·
- logging QueueHandler怎么配置或排查
- 303浏览 收藏
-
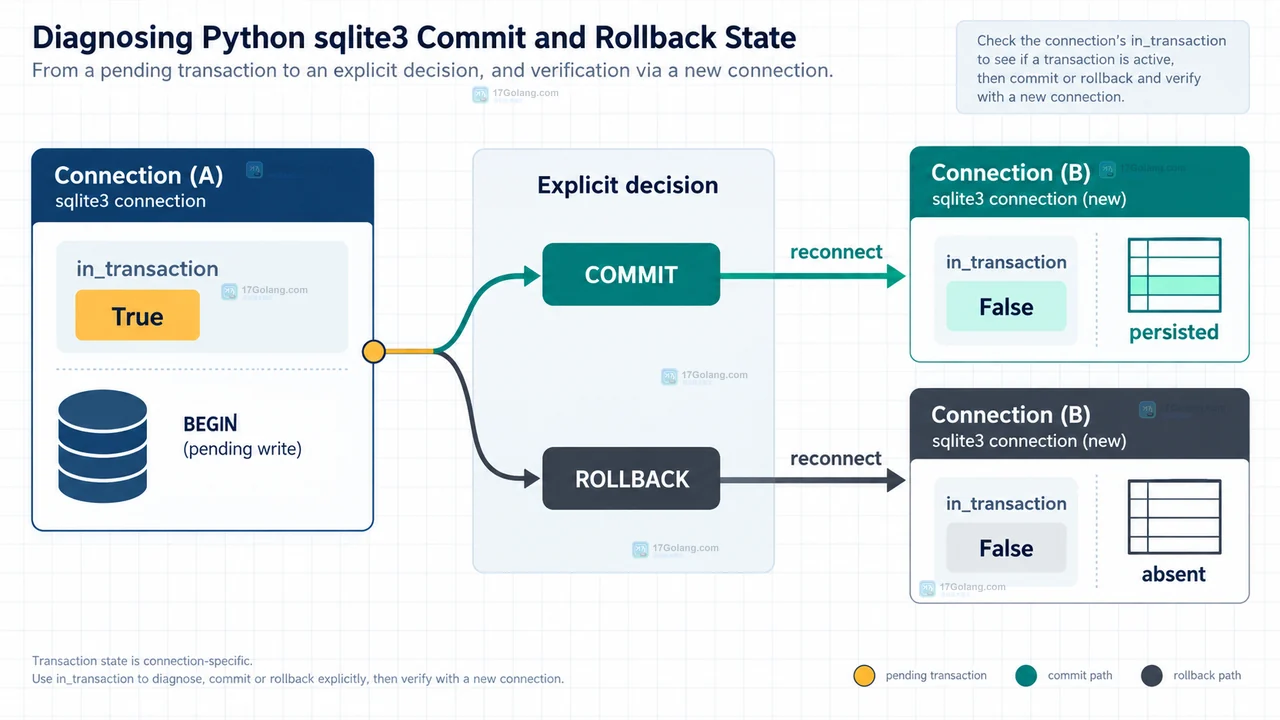
- 文章 · python教程 | 1天前 |
- sqlite3 autocommit怎么配置或排查
- 488浏览 收藏
-
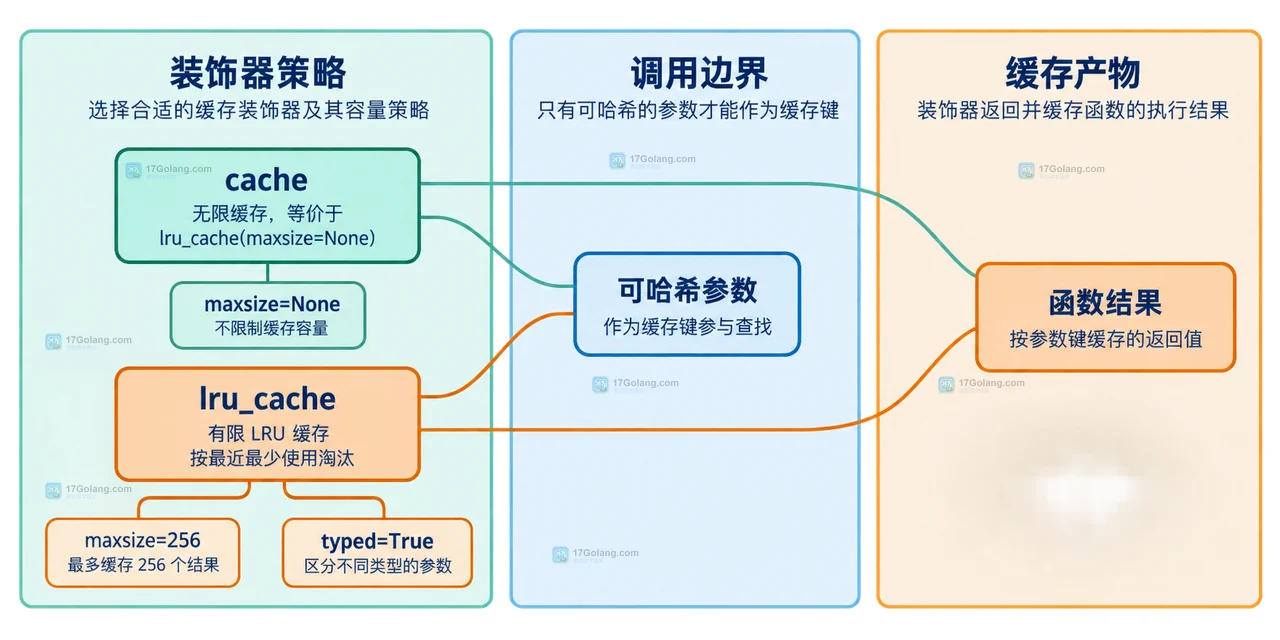
- 文章 · python教程 | 1天前 |
- cache 与 lru_cache怎么配置或排查
- 377浏览 收藏
-
- 文章 · python教程 | 1天前 |
- enum.StrEnum 值怎么配置或排查
- 298浏览 收藏
-
- 文章 · python教程 | 1天前 |
- dataclasses.replace怎么配置或排查
- 282浏览 收藏
-
- 文章 · python教程 | 1天前 |
- ExitStack 资源怎么配置或排查
- 411浏览 收藏
查看更多
课程推荐
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
查看更多
AI推荐
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 11次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 125次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 49次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 17次使用
-

- OpenCompass
- OpenCompass是上海AI实验室推出的开源大模型评测平台,提供CompassKit、CompassHub和CompassRank三大核心组件,支持LLM及多模态模型的一站式标准化评估与排行榜查询。
- 68次使用
查看更多
相关文章
-
- Python sqlite3 Connection serialize 怎么导出数据库快照:备份窗口、内存占用与恢复校验
- 2026-08-26 501浏览
-
- Python监控网页状态:requests异常处理实战
- 2026-05-29 501浏览
-
- TensorFlow模型部署为API的TF Serving方法
- 2026-05-26 501浏览
-
- Python字符串编码转换:encode与decode详解
- 2026-05-16 501浏览
-
- TensorFlow裁剪无用算子方法详解
- 2026-05-15 501浏览


