
HTML5读取嵌套XML结构方法解析
在文章实战开发的过程中,我们经常会遇到一些这样那样的问题,然后要卡好半天,等问题解决了才发现原来一些细节知识点还是没有掌握好。今天golang学习网就整理分享《HTML5读取嵌套XML结构详解》,聊聊,希望可以帮助到正在努力赚钱的你。
XMLHttpRequest 的 responseXML 为空或 null 的根本原因是响应头 Content-Type 未设为 application/xml 或 text/xml;此时应改用 DOMParser 解析 responseText,并检查 parsererror;本地 file:// 协议下推荐用 fetch 替代。

XMLHttpRequest 加载 XML 后,responseXML 为空或 null 怎么办
根本原因通常是响应未被正确识别为 XML 类型。浏览器不会自动将文本内容解析成 DOM 树,除非响应头 Content-Type 是 application/xml、text/xml 或类似值;否则 responseXML 会是 null,只能靠 responseText + DOMParser 手动解析。
- 服务端没设对
Content-Type?直接在前端补救:const parser = new DOMParser(); const xmlDoc = parser.parseFromString(xhr.responseText, "text/xml");
- 解析失败时
xmlDoc.querySelector("parsererror")会存在,务必检查:if (xmlDoc.querySelector("parsererror")) { console.error("XML 解析失败:", xmlDoc.querySelector("parsererror").textContent); } - 本地文件(
file://协议)下XMLHttpRequest通常被 CORS 阻止,改用fetch+Response.text()更稳妥
用 getElementsByTagName 和 querySelector 混用导致节点层级错乱
两者行为差异极大:getElementsByTagName 返回实时的 HTMLCollection(后续 DOM 变更会反映其中),而 querySelector 返回静态快照。嵌套遍历时若混用,容易漏节点或重复处理。
- 统一用
querySelectorAll获取全部匹配节点,再逐个处理:const books = xmlDoc.querySelectorAll("book"); books.forEach(book => { const title = book.querySelector("title")?.textContent; const author = book.querySelector("author")?.textContent; const chapters = book.querySelectorAll("chapter"); }); - 父子关系别硬猜索引,用
parentNode或closest回溯:const chapter = someNode.closest("chapter"); const parentBook = chapter?.closest("book"); - 避免
childNodes—— 它包含空白文本节点,用children只取元素节点
处理带命名空间的 XML(如 SVG、SOAP)时 getElementsByTagNameNS 必须指定前缀
如果 XML 声明了命名空间(例如 getElementsByTagName("item") 查不到任何节点 —— 浏览器把它当“无命名空间”处理,而实际节点属于该 URI 空间。
- 先获取根节点命名空间:
const ns = xmlDoc.documentElement.namespaceURI;
- 所有查询必须带命名空间参数:
const items = xmlDoc.getElementsByTagNameNS(ns, "item"); // 或用 querySelectorAll(需在选择器中写完整前缀,但浏览器不支持通配前缀,得先绑定) const parser = new DOMParser(); const xmlDoc = parser.parseFromString(xmlStr, "application/xml"); xmlDoc.documentElement.setAttribute("xmlns:ns", "http://purl.org/rss/1.0/"); const items = xmlDoc.querySelectorAll("ns|item"); // 注意竖线分隔 - 若无法修改 XML,用
*通配标签名再过滤本地名:Array.from(xmlDoc.getElementsByTagName("*")) .filter(el => el.localName === "item");
深层嵌套结构下递归遍历易栈溢出或逻辑失控
XML 层级过深(比如 20+ 层)时,纯递归函数可能触发浏览器调用栈限制;更常见的是业务逻辑把“父→子→孙”路径和数据提取耦合太紧,一改结构就得重写逻辑。
- 改用显式栈模拟递归,可控且易中断:
const stack = [{ node: xmlDoc.documentElement, level: 0 }]; while (stack.length > 0) { const { node, level } = stack.pop(); console.log(" ".repeat(level), node.nodeName); Array.from(node.children).forEach(child => { stack.push({ node: child, level: level + 1 }); }); } - 提取数据优先按语义路径,而非物理嵌套深度。例如:
"book > author > name"比 “第 3 层的第 2 个子元素” 更可靠 - 对重复结构(如多个
chapter下都有section),先用querySelectorAll("chapter section")扁平化获取,再用section.closest("chapter")关联回父级
responseXML 的空值条件、命名空间的隐式绑定,或者把 DOM 遍历写成了依赖文档顺序的脆弱逻辑。多打一行 console.dir(node),比查十次文档更快。以上就是《HTML5读取嵌套XML结构方法解析》的详细内容,更多关于的资料请关注golang学习网公众号!
 “节”从哪来?船速单位全解析
- 上一篇
- “节”从哪来?船速单位全解析

- 下一篇
- 12306联系人删除步骤详解
-
- 文章 · 前端 | 12小时前 |
- ARIA live 怎样播报异步状态变化
- 261浏览 收藏
-
- 文章 · 前端 | 12小时前 | html · 可访问性 焦点管理 HTML inert 模态框背景禁用
- HTML inert 怎样暂时禁用背景区域交互
- 153浏览 收藏
-
- 文章 · 前端 | 12小时前 | css · 表单 · 表单布局 CSS field-sizing 文本框自适应 textarea 自动高度
- CSS field-sizing 怎样让文本框高度随内容变化
- 328浏览 收藏
-
- 文章 · 前端 | 12小时前 | css ·
- CSS 容器查询怎样按组件宽度切换布局
- 330浏览 收藏
-
- 文章 · 前端 | 12小时前 |
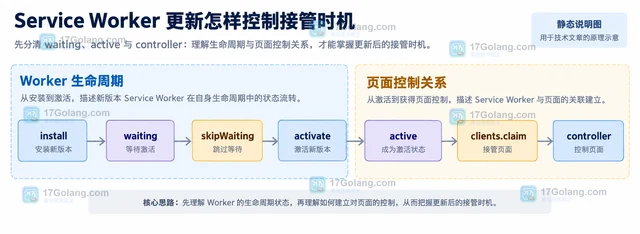
- Service Worker 更新怎样控制接管时机
- 486浏览 收藏
-
- 文章 · 前端 | 12小时前 | 前端 · javascript · request Cache API Cache.match Vary
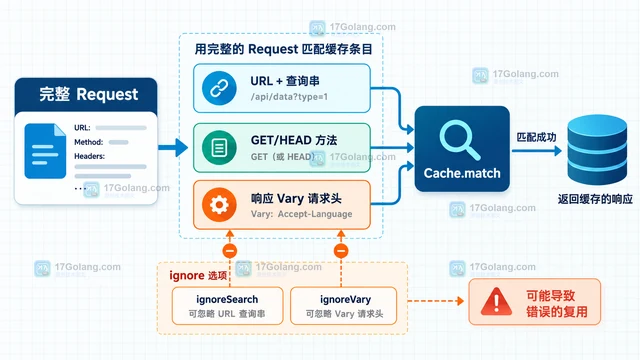
- Cache API 怎样用完整请求区分缓存条目
- 432浏览 收藏
-
- 文章 · 前端 | 12小时前 |
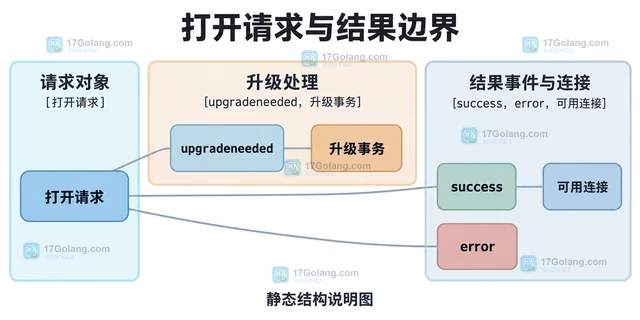
- IndexedDB 数据库升级怎样处理版本变更
- 483浏览 收藏
-
- 文章 · 前端 | 12小时前 |
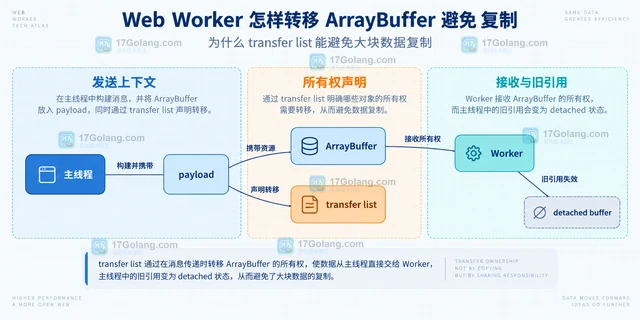
- Web Worker 怎样转移 ArrayBuffer 避免复制
- 408浏览 收藏
-
- 文章 · 前端 | 12小时前 | 前端 · javascript · AbortController ReadableStream Streams API
- ReadableStream 取消后怎样释放请求
- 203浏览 收藏
-
- 文章 · 前端 | 12小时前 | javascript · 前端工程 · ReadableStream 流式响应 TransformStream pipeThrough Streams API
- ReadableStream 怎样用 TransformStream 转换数据
- 151浏览 收藏
-
- 文章 · 前端 | 12小时前 |
- Fetch 怎样用 AbortSignal.timeout 设置请求超时
- 166浏览 收藏
-
- 文章 · 前端 | 12小时前 |
- Fetch keepalive 适合发送哪些小请求
- 397浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 483次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 540次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 562次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 514次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 331次使用
-
- JavaScript函数定义及示例详解
- 2025-05-11 502浏览
-
- 智能体安全引领产业升级——国内AI安全产品市场深度分析
- 2026-08-21 501浏览
-
- CSS变量简化按钮悬停效果技巧
- 2026-05-31 501浏览
-
- JavaScript符号类型详解与应用
- 2026-05-31 501浏览
-
- HTML剪贴板复制粘贴怎么用
- 2026-05-26 501浏览