
HTML转PDF增量方案解析
golang学习网今天将给大家带来《HTML增量转PDF实现方案详解》,感兴趣的朋友请继续看下去吧!以下内容将会涉及到等等知识点,如果你是正在学习文章或者已经是大佬级别了,都非常欢迎也希望大家都能给我建议评论哈~希望能帮助到大家!
HTML增量转PDF无原生支持,因PDF是静态格式、浏览器工具每次全量渲染;可行方案需自行实现HTML差异识别、DOM-PDF位置映射与局部替换,如前端标记法结合PyPDF2页级替换。
HTML 增量转 PDF 在标准工具链中**没有原生支持**——wkhtmltopdf、pdfkit、playwright 或 puppeteer 都是“全量渲染”,即每次调用都从头生成完整 PDF。所谓“增量”,必须由你自行设计状态管理与差异比对逻辑。
为什么浏览器系 PDF 工具不支持增量?
PDF 是静态页面描述格式,不带 DOM 或状态;而 HTML 是动态可变的文档对象模型。浏览器在生成 PDF 时,本质是「对当前快照做光栅化/向量化输出」,不会保留上一次的布局、页码、书签或已渲染内容。即使两次 HTML 只改了一个 文字,底层仍会重排、重绘、重分页。
playwright.pdf()和puppeteer.pdf()每次都是全新Page实例,无跨次上下文wkhtmltopdf不保存中间状态,也无 API 查询「第3页第2段对应源 HTML 的哪个节点」- PDF 标准(ISO 32000)本身不定义「增量更新」语义;PDF/A 或增量保存(
%PDF-1.7\n%âãÏÓ\n后追加对象)是底层二进制追加,与内容逻辑无关
可行的「伪增量」实现路径
所谓“增量转 PDF”,实际是指:给定旧 HTML + 旧 PDF + 新 HTML,输出一个「视觉上仅更新变化部分」的新 PDF。这需要你拆解并接管三件事:HTML 差异识别、DOM 到 PDF 位置映射、PDF 局部替换。目前只有组合方案可落地:
- 前端标记法:在 HTML 中用唯一
data-pdf-id标记可变区块(如...),每次只重渲染该区块为独立 PDF 片段,再用PyPDF2或pypdf替换原 PDF 对应页- 服务端快照比对法:用
diff-match-patch计算新旧 HTML 字符串 diff,提取变更的 DOM 路径;结合预渲染的 PDF 页面尺寸与 CSS layout 估算(需固定字体、字号、行高),定位到目标页+区域;最后用pdf-lib绘制文字覆盖层- 基于 Chromium 的定制方案:用
puppeteer打开旧 PDF 的 base64 数据 URL(需先转为 HTML 预览页),注入 JS 获取各区块 bounding rect;再加载新 HTML,对比相同data-pdf-id元素的getBoundingClientRect(),仅对位置/尺寸/内容变化的区块触发重绘并 patch最简可用示例(前端标记 + PyPDF2 替换)
适用场景:报表类 HTML,每节有稳定 ID,且变化仅限文字/数字,不涉及分页偏移。
from pypdf import PdfReader, PdfWriter from io import BytesIO from playwright.sync_api import sync_playwright
def html_to_pdf_page(html: str) -> bytes: with sync_playwright() as p: browser = p.chromium.launch() page = browser.new_page() page.set_content(html, wait_until="networkidle") pdf_bytes = page.pdf(format="A4", print_background=True) browser.close() return pdf_bytes
def replace_section_in_pdf(old_pdf_path: str, section_id: str, new_html: str, output_path: str):
1. 提取旧 PDF 所有页
reader = PdfReader(old_pdf_path) writer = PdfWriter() # 2. 找到对应 section 的页码(需你事先维护映射表,例如 {"summary": 2, "chart": 3}) section_page_map = {"summary": 2} # 实际需从 HTML 解析或配置文件读取 target_page_idx = section_page_map.get(section_id) # 3. 渲染新 HTML 为单页 PDF new_page_bytes = html_to_pdf_page(f"<div style='padding:20px'>{new_html}</div>") new_reader = PdfReader(BytesIO(new_page_bytes)) # 4. 替换指定页 for i in range(len(reader.pages)): if i == target_page_idx: writer.add_page(new_reader.pages[0]) else: writer.add_page(reader.pages[i]) with open(output_path, "wb") as f: writer.write(f)注意:
target_page_idx必须准确——如果新 HTML 长度导致分页变化(比如 summary 从 1 页变 2 页),此方案直接失效。此时必须回归全量渲染,或引入weasyprint+ 自定义分页断点控制。真正难的不是生成 PDF,而是定义清楚「什么算增量」:是 DOM 节点级?文本字符级?还是视觉像素级?选错粒度,所有优化都会在第一次分页变动时崩溃。
今天关于《HTML转PDF增量方案解析》的内容就介绍到这里了,是不是学起来一目了然!想要了解更多关于的内容请关注golang学习网公众号!
 Python监控内存使用与泄漏检测方法
- 上一篇
- Python监控内存使用与泄漏检测方法
- 下一篇
- Ludwig快速训练AI大模型技巧
- 服务端快照比对法:用
-
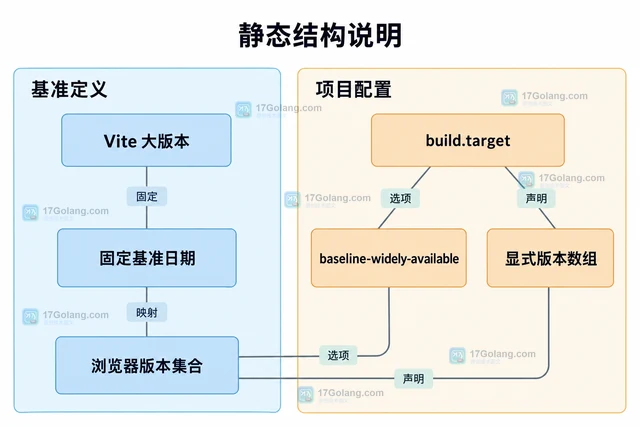
- 文章 · 前端 | 17小时前 | vite 浏览器兼容 前端构建 Baseline build.target
- Vite 怎样设置 Baseline 浏览器构建目标
- 366浏览 收藏
-
- 文章 · 前端 | 17小时前 |
- CSS view-transition-name 怎样连接页面状态切换
- 263浏览 收藏
-
- 文章 · 前端 | 19小时前 | 前端 · JSON · javascript · JavaScript JSON.stringify 超大整数 JSON.rawJSON
- JSON.rawJSON 怎么在序列化时保留超大整数文本
- 442浏览 收藏
-
- 文章 · 前端 | 19小时前 |
- CSS nesting 怎样组织组件内嵌套规则
- 227浏览 收藏
-
- 文章 · 前端 | 19小时前 |
- Fetch priority 怎样提示浏览器资源优先级
- 208浏览 收藏
-
- 文章 · 前端 | 20小时前 | 前端 · JSON · javascript · JavaScript vite json模块 ES module import attributes with type=json
- JavaScript import attributes 怎样加载 JSON 模块
- 406浏览 收藏
-
- 文章 · 前端 | 20小时前 | 前端 · 性能优化 · javascript · 浏览器API · IntersectionObserver rootMargin threshold Intersection Observer API unobserve 前端懒加载
- IntersectionObserver 怎样按可见性加载内容
- 182浏览 收藏
-
- 文章 · 前端 | 20小时前 | 前端 · css · 浏览器兼容 · anchor-name position-area CSS anchor positioning position-anchor position-try 下拉菜单定位
- CSS anchor positioning 怎样让下拉菜单跟随触发按钮并自动避让边缘
- 161浏览 收藏
-
- 文章 · 前端 | 21小时前 | 前端 · css · 可访问性 · CSS 滚动容器 overflow: clip overflow: hidden 键盘聚焦
- CSS overflow: clip 怎样在裁剪内容时不产生滚动条
- 252浏览 收藏
-
- 文章 · 前端 | 22小时前 | 前端 · css · CSS 组件样式 @scope scope root scope limit :scope
- CSS @scope 怎样限制组件样式不越过容器边界
- 208浏览 收藏
-
- 文章 · 前端 | 2天前 | 并发控制 · 前端 Query Web Locks API LockManager 多标签页同步
- 前端 Web Locks 怎样查询当前持有者
- 284浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 587次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 625次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 660次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 628次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 444次使用
-
- JavaScript函数定义及示例详解
- 2025-05-11 502浏览
-
- 智能体安全引领产业升级——国内AI安全产品市场深度分析
- 2026-08-21 501浏览
-
- CSS变量简化按钮悬停效果技巧
- 2026-05-31 501浏览
-
- JavaScript符号类型详解与应用
- 2026-05-31 501浏览
-
- HTML剪贴板复制粘贴怎么用
- 2026-05-26 501浏览


