
后缀表达式求值方法及实现步骤详解
2026-02-01 08:36:42
0浏览
收藏
小伙伴们有没有觉得学习文章很有意思?有意思就对了!今天就给大家带来《后缀表达式求值方法详解与实现步骤》,以下内容将会涉及到,若是在学习中对其中部分知识点有疑问,或许看了本文就能帮到你!

本文详解 Python 中后缀表达式求值函数的常见错误与修复方法,涵盖栈操作逻辑、数据类型转换、运算符处理及边界校验,帮助初学者写出健壮、可运行的 postfix 求值代码。
后缀表达式(也称逆波兰表达式,RPN)是一种无需括号即可明确运算顺序的数学表达式表示法,例如 "1 2 3 * +" 表示 1 + (2 * 3) = 7。其求值核心依赖栈结构:从左到右扫描 token,遇到数字则入栈,遇到运算符则弹出栈顶两个操作数(注意顺序:先弹出的是右操作数,后弹出的是左操作数),计算后将结果压回栈中。最终栈中应仅剩一个元素——即表达式的值。
原代码存在多处关键性逻辑错误,下面逐项说明并给出修正后的完整实现:
? 主要问题与修复说明
- 错误拆分方式:for ch in expr_str: 会按字符遍历(如 "12" → '1', '2'),破坏多位数;应使用 expr_str.split() 按空格切分为 token 列表(如 "12 3 +" → ['12', '3', '+'])。
- 类型混淆:ch.isdigit() 仅对纯数字字符串有效(如 '123' ✅,但 '-5' ❌),且入栈时未转为 int/float,导致后续算术运算失败。需调用 int(ch) 或更鲁棒的 float(ch)。
- 运算符逻辑错位:除法分支误写为 op_1 - op_2,乘法分支误用 /;且缺少对幂、取模等扩展运算符的考虑(本例聚焦四则运算)。
- 冗余与错误操作:if ch not in op: 判断无意义(ch 是列表);mystack.append(mystack) 导致栈污染;末尾 ''.join(mystack) 对数值列表无效,应直接返回 mystack[0](并确保栈长为 1)。
✅ 修复后的完整代码(含基础错误检查)
def postfix(expr_str: str) -> float:
    if not expr_str.strip():
        raise ValueError("Empty expression")

    mystack = []
    tokens = expr_str.split()

    for token in tokens:
        if token.replace('.', '', 1).lstrip('-').isdigit():  # 支持负数和浮点数(简化版)
            mystack.append(float(token))
        elif token in ['+', '-', '*', '/']:
            if len(mystack) < 2:
                raise ValueError(f"Not enough operands for '{token}'")
            op2 = mystack.pop()  # 注意:后入先出,op2 是右操作数
            op1 = mystack.pop()
            if token == '+':
                result = op1 + op2
            elif token == '-':
                result = op1 - op2
            elif token == '*':
                result = op1 * op2
            elif token == '/':
                if op2 == 0:
                    raise ZeroDivisionError("Division by zero")
                result = op1 / op2
            mystack.append(result)
        else:
            raise ValueError(f"Invalid token: '{token}'")

    if len(mystack) != 1:
        raise ValueError(f"Invalid expression: {len(mystack)} values left on stack")

    return mystack[0]
? 使用示例与验证
print(postfix("1 2 3 * +"))    # → 7.0
print(postfix("10 2 / 3 -"))   # → 2.0
print(postfix("5 1 2 + 4 * + 3 -"))  # → 14.0 (即 5 + ((1+2)*4) - 3)
⚠️ 注意事项与进阶建议
- 数字识别增强:上述 token.replace(...).isdigit() 仅覆盖简单浮点/负数;生产环境推荐用 try: float(token) except ValueError: 更可靠。
- 整数 vs 浮点返回:函数签名声明 -> float,故统一用 float(token) 入栈,避免整数除法歧义(如 Python 2 中 3/2=1)。
- 栈操作顺序至关重要:减法与除法不满足交换律,务必保证 op1(左)op2(右)顺序,即 op1 - op2,而非反向。
- 错误防御:添加空输入、操作数不足、非法 token、除零、最终栈长度异常等检查,大幅提升鲁棒性。
- 扩展性提示:如需支持 ^(幂)、%(取模)或函数(如 sin),只需在 elif 链中追加分支,并确保对应操作数个数匹配。
通过理解栈的 LIFO 特性、严格区分 token 类型与数值类型、并辅以必要的异常处理,你就能写出清晰、正确、可维护的后缀表达式求值器。
好了,本文到此结束,带大家了解了《后缀表达式求值方法及实现步骤详解》,希望本文对你有所帮助!关注golang学习网公众号,给大家分享更多文章知识!
 Python对象ID与内存地址详解
- 上一篇
- Python对象ID与内存地址详解

- 下一篇
- JaegerOTLP通信故障排查指南
查看更多
最新文章
-
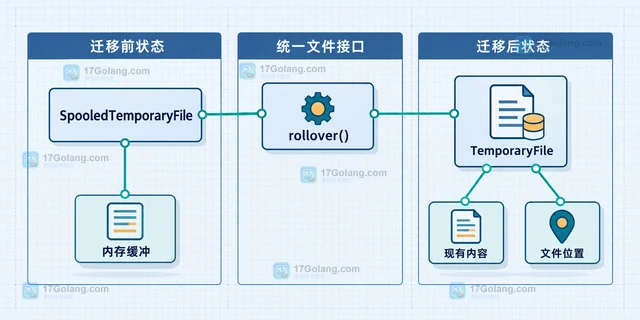
- 文章 · python教程 | 3小时前 | 文件处理 · python · Python TempFile 临时文件 SpooledTemporaryFile rollover
- Python SpooledTemporaryFile 怎么手动触发写入磁盘
- 307浏览 收藏
-
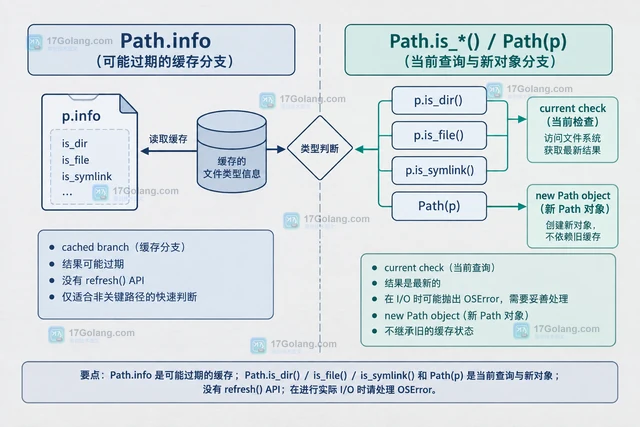
- 文章 · python教程 | 6小时前 |
- Python Path.info 缓存的文件类型信息什么时候会过期
- 438浏览 收藏
-
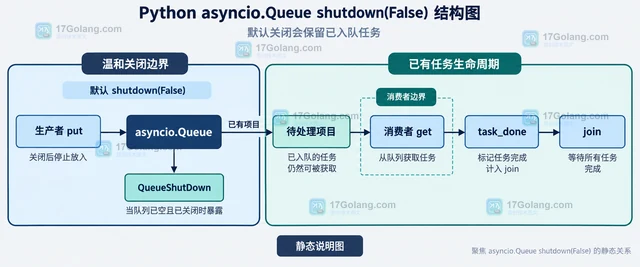
- 文章 · python教程 | 9小时前 |
- Python asyncio.Queue shutdown 后等待者会收到什么
- 124浏览 收藏
-
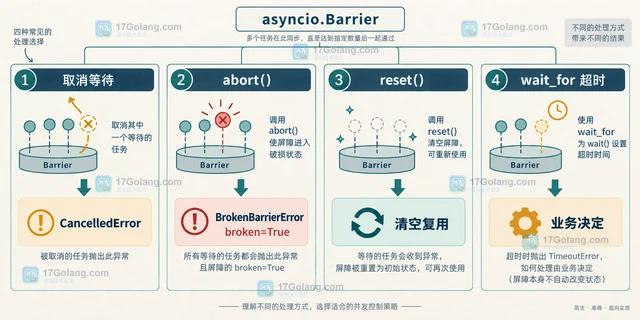
- 文章 · python教程 | 14小时前 |
- Python asyncio.Barrier 等待任务被取消后会怎样
- 166浏览 收藏
-
- 文章 · python教程 | 17小时前 |
- Python TaskGroup 怎么主动终止整组任务
- 242浏览 收藏
-
- 文章 · python教程 | 23小时前 | SQLite · 数据一致性 · Python教程 · Python SQLite 数据库备份 sqlite3.Connection.backup
- Python sqlite3.Connection.backup 怎么在线复制数据库
- 264浏览 收藏
-
- 文章 · python教程 | 1天前 | python · Python zip zipfile zipfile.Path
- Python zipfile.Path 怎么像目录一样遍历压缩包
- 370浏览 收藏
-
- 文章 · python教程 | 1天前 | 内存优化 · Python教程 · Python 大数组 PickleBuffer pickle协议5
- Python PickleBuffer 怎么减少大数组复制
- 207浏览 收藏
-
- 文章 · python教程 | 1天前 | 标准库 · Python教程 · Python Traversable importlib.resources zipimport
- Python importlib.resources.files 怎么访问压缩包内资源
- 143浏览 收藏
-
- 文章 · python教程 | 1天前 | 标准库 · python · 进程管理 · Python subprocess.Popen pipesize
- Python subprocess.Popen pipesize 什么时候有效
- 187浏览 收藏
-
- 文章 · python教程 | 1天前 | python · 异步编程 · Python 资源清理 异步生成器 contextlib aclosing
- Python contextlib.aclosing 怎么确保异步生成器退出
- 369浏览 收藏
查看更多
课程推荐
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
查看更多
AI推荐
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 343次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 405次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 404次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 364次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 186次使用
查看更多
相关文章
-
- Python sqlite3 Connection serialize 怎么导出数据库快照:备份窗口、内存占用与恢复校验
- 2026-08-26 501浏览
-
- Python监控网页状态:requests异常处理实战
- 2026-05-29 501浏览
-
- TensorFlow模型部署为API的TF Serving方法
- 2026-05-26 501浏览
-
- Python字符串编码转换:encode与decode详解
- 2026-05-16 501浏览
-
- TensorFlow裁剪无用算子方法详解
- 2026-05-15 501浏览


