
当前位置:首页 > 文章列表 > 文章 > 前端 > BeautifulSoup提取嵌套span标签文本的方法如下:✅步骤说明:导入库首先确保已安装beautifulsoup4和requests(用于获取网页内容)。frombs4importBeautifulSoupimportrequests获取网页内容使用requests.get()获取目标网页的HTML内容。url='https://example.com'response=requests.
BeautifulSoup提取嵌套span标签文本的方法如下:✅步骤说明:导入库首先确保已安装beautifulsoup4和requests(用于获取网页内容)。frombs4importBeautifulSoupimportrequests获取网页内容使用requests.get()获取目标网页的HTML内容。url='https://example.com'response=requests.
各位小伙伴们,大家好呀!看看今天我又给各位带来了什么文章?本文标题是《如何用 BeautifulSoup 提取嵌套 span 文本》,很明显是关于文章的文章哈哈哈,其中内容主要会涉及到等等,如果能帮到你,觉得很不错的话,欢迎各位多多点评和分享!

本文介绍如何利用 BeautifulSoup 的 `contents` 属性,精准提取外层 `` 中不包含子元素的直接文本节点(如“Felix Wong”),避免 `get_text()` 返回嵌套子元素内容的问题。
在网页解析中,常遇到类似如下结构的 HTML:
Felix Wong +3 drivers若直接调用 .get_text(),会合并所有后代文本,返回 "Felix Wong +3 drivers" —— 这通常不符合需求,尤其当只需提取父级标签中的直接文本节点(即不被子标签包裹的部分)时。
此时应改用 .contents 属性:它返回一个包含所有直接子节点(包括字符串节点和标签节点)的列表。其中,纯文本内容作为 NavigableString 对象位于索引 0(前提是文本出现在子标签之前),而 则是索引 1 的 Tag 对象。
✅ 正确做法:
from bs4 import BeautifulSoup

html = '''Felix Wong +3 drivers'''
soup = BeautifulSoup(html, 'html.parser')

# 获取第一个直接子节点(即" Felix Wong ",含前后空格)
raw_text = soup.select_one('span').contents[0]

# 推荐:strip() 去除首尾空白,确保结果干净
name = raw_text.strip()  # 输出: "Felix Wong"
print(name)
⚠️ 注意事项:
- .contents[0] 仅在目标文本位于子标签之前时有效。若 HTML 为 +3 driversFelix Wong,则文本在索引 1,需先遍历 .contents 并筛选 isinstance(node, str) 的字符串节点。
- 更健壮的写法(兼容任意位置):
parent = soup.select_one('span') name = ''.join([str(s) for s in parent.contents if isinstance(s, str)]).strip() - 始终指定解析器(如 'html.parser'),避免警告;生产环境推荐 'lxml'(需安装)以提升性能与容错性。
总结:.get_text() 适用于获取全部可见文本,而 .contents 是精准控制文本来源层级的关键工具——掌握其节点类型区分(str vs Tag),即可灵活应对复杂嵌套文本提取场景。
今天关于《BeautifulSoup提取嵌套span标签文本的方法如下:✅步骤说明:导入库首先确保已安装beautifulsoup4和requests(用于获取网页内容)。frombs4importBeautifulSoupimportrequests获取网页内容使用requests.get()获取目标网页的HTML内容。url='https://example.com'response=requests.get(url)html=response.text解析HTML用BeautifulSoup解析HTML内容。soup=BeautifulSoup(html,'html.parser')提取嵌套span文本如果你只需要所有span标签内的文本,可以使用find_all('span'),然后遍历提取文本。如果需要提取特定层级的span(如嵌套在某个父标签下的span),可以通过find()或select()定位。🔍示例代码情况一:提取所有span的文本forspaninsoup.find_all('span'):print(span.get_text(strip=True))情况二:提取嵌套在`》的内容介绍就到此结束,如果有什么疑问或者建议,可以在golang学习网公众号下多多回复交流;文中若有不正之处,也希望回复留言以告知!
 岚图港股上市获批,东风私有化接近尾声
- 上一篇
- 岚图港股上市获批,东风私有化接近尾声
- 下一篇
- JavaScript闭包原理与作用域详解
-
- 文章 · 前端 | 53分钟前 | React useTransition startTransition 并发渲染
- React useTransition 区分交互更新与后台渲染
- 112浏览 收藏
-
- 文章 · 前端 | 3小时前 | vite 前端缓存 Vite依赖预构建 optimizeDeps node_modules/.vite
- Vite 依赖预构建缓存失效时的排查步骤
- 451浏览 收藏
-
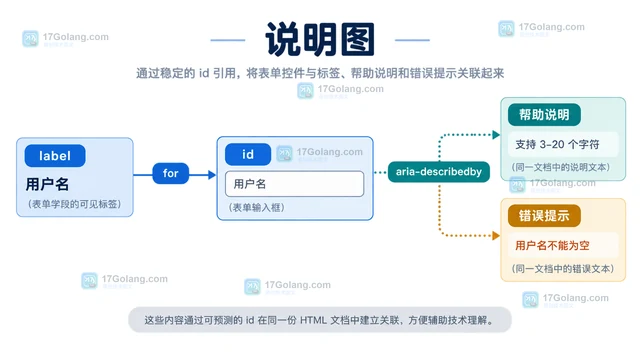
- 文章 · 前端 | 1天前 |
- 表单 aria-describedby 关联错误提示的可访问设计
- 349浏览 收藏
-
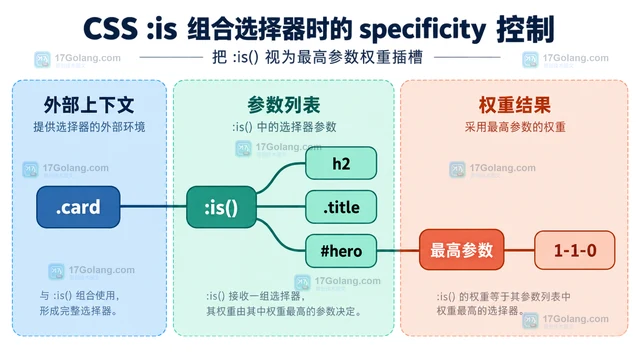
- 文章 · 前端 | 1天前 | 前端 · css · 组合选择器 CSS :is specificity :where 级联层
- CSS :is 组合选择器时的 specificity 控制
- 327浏览 收藏
-
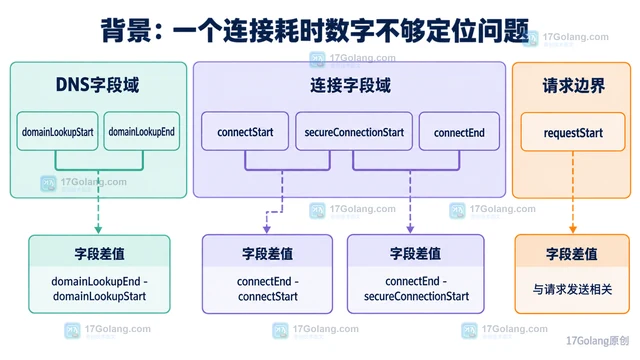
- 文章 · 前端 | 2天前 | javascript · DNS耗时 PerformanceResourceTiming TLS耗时
- PerformanceResourceTiming 拆分 DNS 与 TLS 耗时
- 108浏览 收藏
-
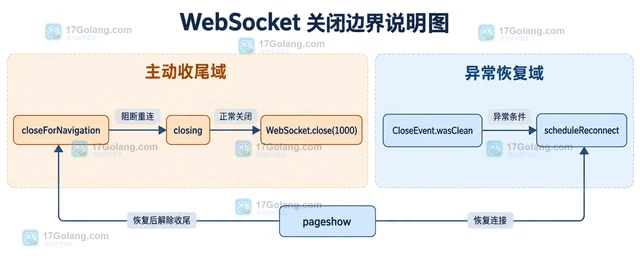
- 文章 · 前端 | 4天前 | 前端 · websocket ·
- WebSocket 重连退避与页面卸载的收尾
- 381浏览 收藏
-
- 文章 · 前端 | 4天前 |
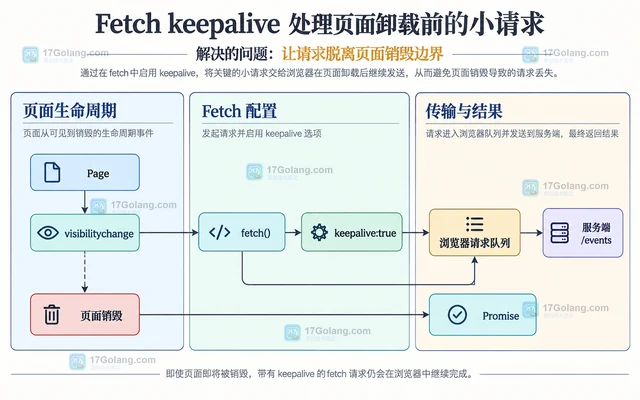
- Fetch keepalive 处理页面卸载前的小请求
- 291浏览 收藏
-
- 文章 · 前端 | 4天前 |
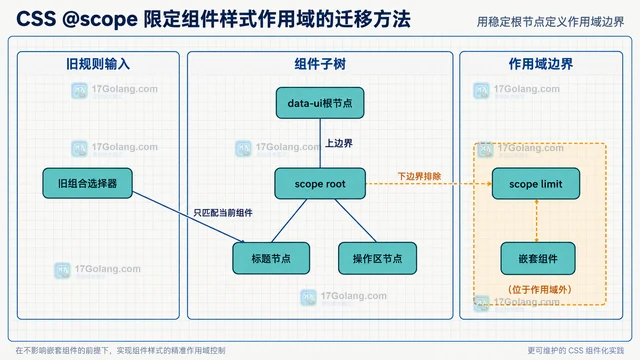
- CSS @scope 限定组件样式作用域的迁移方法
- 294浏览 收藏
-
- 文章 · 前端 | 5天前 |
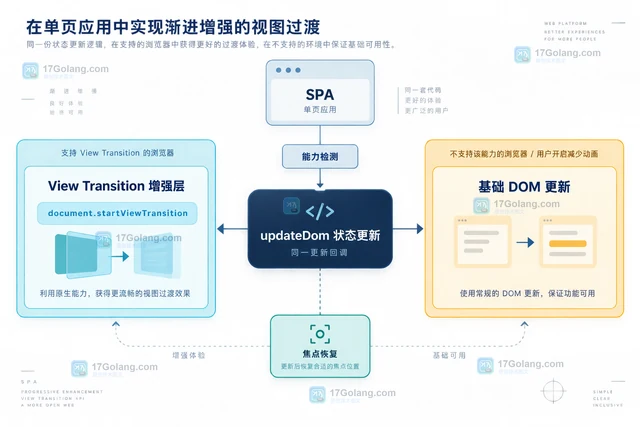
- View Transition API 在 SPA 状态切换中的降级方案
- 142浏览 收藏
-
- 文章 · 前端 | 5天前 | javascript · 表单 · FormData FormDataEvent formdata事件 原生表单
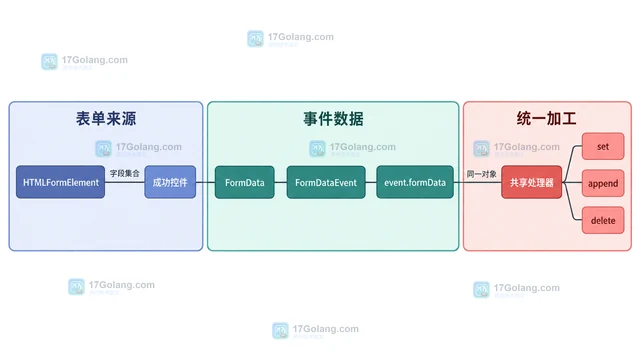
- FormDataEvent 统一拦截原生表单数据的实现
- 288浏览 收藏
-
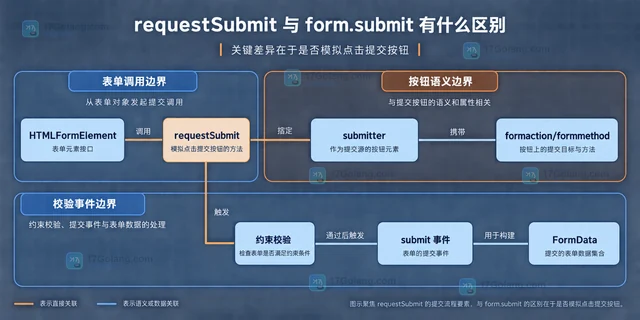
- 文章 · 前端 | 5天前 | html · javascript · 表单 · requestSubmit form.submit HTML表单校验
- requestSubmit 与 form.submit 有什么区别
- 392浏览 收藏
-
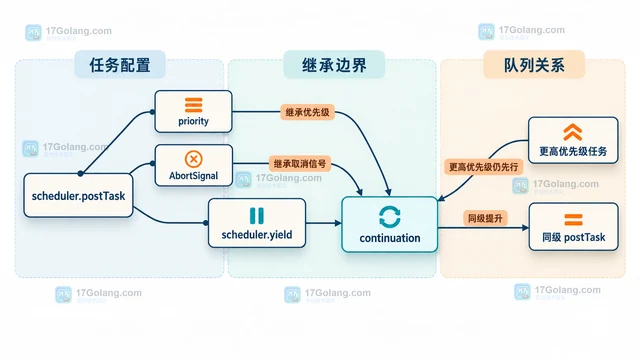
- 文章 · 前端 | 5天前 |
- scheduler.yield 怎么把长任务拆开又保持优先级
- 110浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 318次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 374次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 371次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 337次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 162次使用
-
- JavaScript函数定义及示例详解
- 2025-05-11 502浏览
-
- 智能体安全引领产业升级——国内AI安全产品市场深度分析
- 2026-08-21 501浏览
-
- CSS变量简化按钮悬停效果技巧
- 2026-05-31 501浏览
-
- JavaScript符号类型详解与应用
- 2026-05-31 501浏览
-
- HTML剪贴板复制粘贴怎么用
- 2026-05-26 501浏览


