
30码裤子腰围多少,L码有多大
怎么入门文章编程?需要学习哪些知识点?这是新手们刚接触编程时常见的问题;下面golang学习网就来给大家整理分享一些知识点,希望能够给初学者一些帮助。本篇文章就来介绍《30码裤子腰围多少,L码又有多大》,涉及到,有需要的可以收藏一下
裤子30码对应腰围76.2厘米(约76–77厘米),L码则因性别而异:男裤通常82–86厘米,女裤多为74–78厘米,需以具体三围数据为准,不可仅凭字母码互换。

一、裤子尺码30对应的腰围数值
裤子标注的“30码”采用的是英寸制腰围单位,即指腰围为30英寸。该数值需换算为公制单位才能准确匹配实际测量结果。换算依据为1英寸=2.54厘米,因此30英寸对应精确腰围为76.2厘米。国内市面常见标称多取整为76cm或77cm,部分品牌因版型差异可能标注为75–78cm区间。
1、用软尺水平绕脐上2–3厘米处一圈,保持自然呼吸,测得净腰围;
2、若实测腰围为75–77cm,可优先试穿30码;
3、若腰围接近78cm且偏好合身效果,建议选择31码或关注弹性面料款。
二、裤子L码对应的标准腰围范围
L码属于国标(GB/T 2668–2017)服装号型体系中的通用尺码,其具体腰围不固定,需结合性别、品类及品牌定位综合判断。男裤L码通常适配腰围82–86厘米,女裤L码则多对应74–78厘米,存在明显性别分野。
1、查看吊牌或商品页明确标注的“腰围/臀围/裤长”三围数据,而非仅依赖L/XL等字母码;
2、男装L码牛仔裤常见腰围为84cm,对应身高170–175cm、体重65–75kg体型;
3、女装L码休闲裤若标注“腰围76cm”,实际与男裤30码(76.2cm)数值重叠,但臀围与裤型结构差异显著,不可直接互换。
文中关于的知识介绍,希望对你的学习有所帮助!若是受益匪浅,那就动动鼠标收藏这篇《30码裤子腰围多少,L码有多大》文章吧,也可关注golang学习网公众号了解相关技术文章。
 Python装饰器原理与使用技巧
- 上一篇
- Python装饰器原理与使用技巧
- 下一篇
- Java类型转换异常解决与原因剖析
-
- 文章 · 常见问题 | 24分钟前 |
- qooapp是游戏平台还是资讯社区?游戏商店、媒体与玩家功能边界说明
- 447浏览 收藏
-
- 文章 · 常见问题 | 35分钟前 |
- 78动漫单品页怎么看?产品条目、图片信息与评论入口说明
- 156浏览 收藏
-
- 文章 · 常见问题 | 45分钟前 |
- bangumi关于页面怎么看?项目历史、数据贡献与社区角色说明
- 368浏览 收藏
-
- 文章 · 常见问题 | 55分钟前 |
- 蛙蛙漫画下载显示维护中怎么办?小米应用商店状态与入口说明
- 163浏览 收藏
-
- 文章 · 常见问题 | 1小时前 |
- Lanerc动漫评论怎么用?评论、点赞与消息通知功能边界说明
- 304浏览 收藏
-
- 文章 · 常见问题 | 1小时前 |
- 人类基准反应测试的数据安全吗?网页版入口与移动端声明说明
- 254浏览 收藏
-
- 文章 · 常见问题 | 1小时前 |
- artworkout隐私和数据安全怎么看?官网政策与使用边界说明
- 421浏览 收藏
-
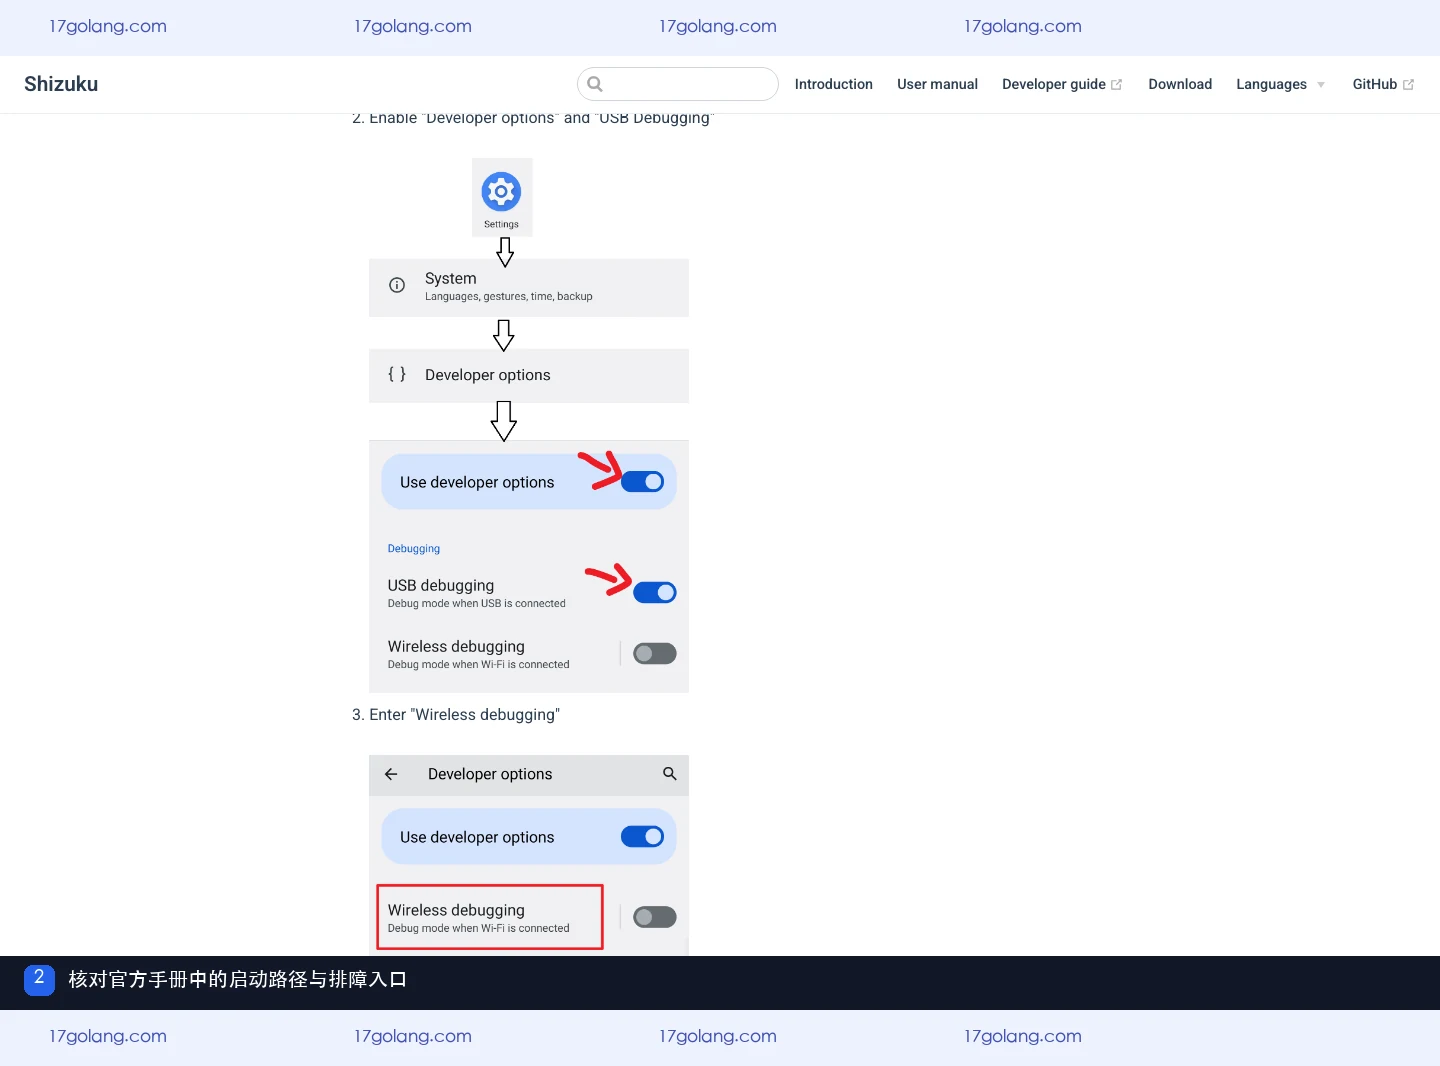
- 文章 · 常见问题 | 2小时前 |
- shizuku遇到问题怎么反馈?版本、启动模式与日志整理说明
- 110浏览 收藏
-
- 文章 · 常见问题 | 2小时前 |
- 米坛社区知识库普通用户和开发者怎么选?教程入口与发布边界说明
- 362浏览 收藏
-
- 文章 · 常见问题 | 2小时前 |
- 爱玩机工具箱文件目录在哪?主文件、下载文件与数据安全提醒
- 171浏览 收藏
-
- 文章 · 常见问题 | 2小时前 |
- 甲壳虫ADB助手能一键激活Shizuku吗?ADB授权与工具边界说明
- 377浏览 收藏
-
- 文章 · 常见问题 | 3小时前 |
- 画质怪兽官网的“无病毒”宣传能当安全保证吗?页面文案与核对边界
- 410浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 321次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 377次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 374次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 337次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 163次使用
-
- 新能源汽车充电站日常巡检如何记录枪口、计费和告警状态
- 2026-09-16 501浏览
-
- age动漫APP怎么下载?安卓与iOS入口、下载页和安全核对说明
- 2026-09-05 501浏览
-
- 攀岩馆举办公开攀岩赛,哪些情形需要申请高危险性体育赛事活动许可
- 2026-08-30 501浏览
-
- 2026年秋季开学时间怎么查:全国统一吗、家长看哪份通知
- 2026-08-26 501浏览
-
- 单射满射图像特征及水平线测试法解析
- 2026-05-29 501浏览