
JavaScript语音识别实现与兼容性分析
IT行业相对于一般传统行业,发展更新速度更快,一旦停止了学习,很快就会被行业所淘汰。所以我们需要踏踏实实的不断学习,精进自己的技术,尤其是初学者。今天golang学习网给大家整理了《JavaScript语音识别实现与Web Speech API兼容性分析》,聊聊,我们一起来看看吧!
JavaScript语音识别主要依赖Web Speech API的SpeechRecognition接口,但仅Chromium系浏览器(Chrome、Edge、Opera)稳定支持,Firefox、Safari及多数国产浏览器不支持,且须HTTPS环境(localhost除外)。

JavaScript 实现语音识别主要依靠 Web Speech API 中的 SpeechRecognition 接口(现多称 SpeechRecognition 或 Chrome 下的 webkitSpeechRecognition),但它不是全平台可用的标准 API,兼容性有明显局限。
当前主流浏览器支持情况
截至 2024 年,仅 Chromium 内核浏览器(Chrome、Edge、Opera)稳定支持语音识别功能,且需 HTTPS 环境(localhost 除外)。Firefox、Safari、Samsung Internet 均未实现该接口,调用会直接报错或返回 undefined。
- ✅ Chrome 25+(需
webkitSpeechRecognition前缀) - ✅ Edge 79+(Chromium 版,支持标准
SpeechRecognition) - ❌ Firefox:无实现,
window.SpeechRecognition为undefined - ❌ Safari:不支持,iOS/macOS 全系不可用
- ❌ 部分国产浏览器(如微信内置浏览器、QQ 浏览器 X5 内核)也不支持
基础使用方式(以 Chrome 为例)
需先检测 API 是否可用,再创建实例并配置行为:
if ('webkitSpeechRecognition' in window) {
  const recognition = new webkitSpeechRecognition();
  recognition.continuous = false;    // 识别一次后停止
  recognition.interimResults = true;  // 返回中间结果
  recognition.lang = 'zh-CN';         // 设置中文

  recognition.onresult = (event) => {
    const transcript = Array.from(event.results)
      .map(result => result[0].transcript)
      .join('');
    console.log('识别结果:', transcript);
  };

  recognition.onerror = (event) => {
    console.error('语音识别出错:', event.error);
  };

  recognition.start(); // 触发麦克风权限请求并开始识别
} else {
  console.warn('当前浏览器不支持语音识别');
}
关键限制与注意事项
即使在支持的浏览器中,也有几个无法绕过的核心限制:
- 必须 HTTPS(或 localhost):HTTP 页面会静默失败,控制台可能无提示
- 用户需主动授权麦克风:首次调用
start()才触发权限弹窗,拒绝后需手动开启 - 无后台持续识别能力:页面失焦或切换标签页时,识别常被中断
- 无离线识别支持:所有音频上传至 Google 服务器处理(隐私敏感场景需谨慎)
- 无官方 TypeScript 类型定义:需手动声明或引入社区类型包(如
@types/web-speech-api)
替代方案建议
若需更广兼容性或更高可控性,可考虑以下路径:
- WebRTC + 第三方 ASR 服务:用
MediaRecorder录制音频,转成 Blob 后上传至阿里云语音识别、腾讯云 ASR、Azure Speech 等 API - Electron / Tauri 桌面应用:通过 Node.js 调用系统级语音工具(如 Windows SAPI、macOS SpeechRecognizer)
- 移动端混合开发:在 React Native 或 Flutter 中调用原生语音识别模块(Android SpeechRecognizer / iOS SFSpeechRecognizer)
Web Speech API 的语音识别能力实用但脆弱,适合实验性项目或 Chrome 内部工具;生产环境建议优先评估兼容性需求,再决定是否降级为录音上传方案。
好了,本文到此结束,带大家了解了《JavaScript语音识别实现与兼容性分析》,希望本文对你有所帮助!关注golang学习网公众号,给大家分享更多文章知识!
 MidjourneyZoomOut教程:图片无限扩展技巧
- 上一篇
- MidjourneyZoomOut教程:图片无限扩展技巧

- 下一篇
- Win11关闭透明效果设置教程
-
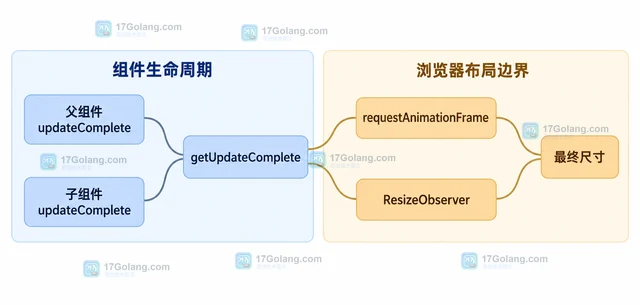
- 文章 · 前端 | 5小时前 | 前端 · Web Components LiT 响应式更新 前端组件 updateComplete
- Lit updateComplete怎样等待组件更新结束
- 425浏览 收藏
-
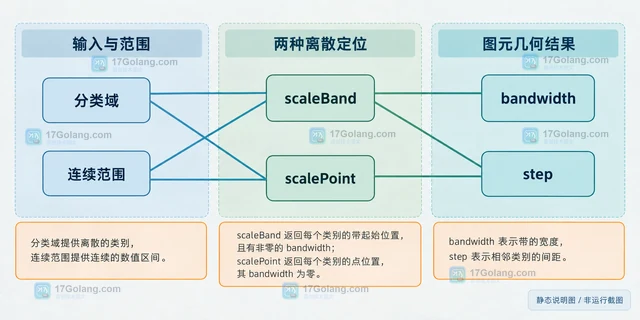
- 文章 · 前端 | 8小时前 | D3 scaleBand scalePoint d3-scale
- D3 scaleBand与scalePoint适用场景有什么区别
- 271浏览 收藏
-
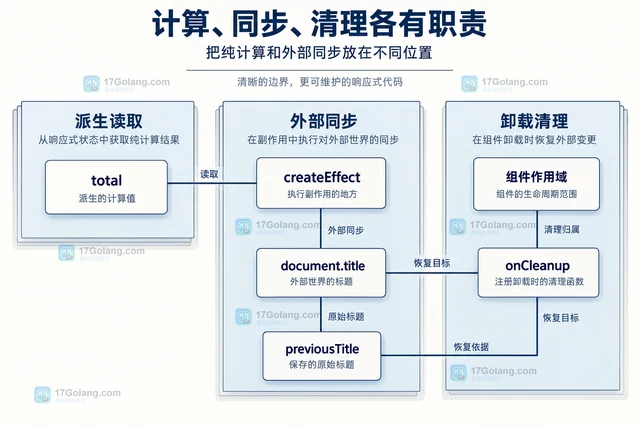
- 文章 · 前端 | 8小时前 | 响应式 副作用 SolidJS createMemo createEffect
- SolidJS createMemo为什么不适合执行副作用
- 308浏览 收藏
-
- 文章 · 前端 | 8小时前 |
- SolidJS store嵌套字段怎样局部更新
- 130浏览 收藏
-
- 文章 · 前端 | 9小时前 |
- XState父状态机怎样向子actor发送事件
- 191浏览 收藏
-
- 文章 · 前端 | 9小时前 |
- Alpine.js $nextTick怎样等待DOM更新
- 367浏览 收藏
-
- 文章 · 前端 | 9小时前 |
- htmx局部替换时怎样保留指定元素状态
- 241浏览 收藏
-
- 文章 · 前端 | 9小时前 |
- htmx hx-sync怎样避免表单与字段请求竞争
- 390浏览 收藏
-
- 文章 · 前端 | 9小时前 | Property Web Components LiT Attribute 响应式属性
- Lit响应式属性怎样设置attribute与property的映射
- 429浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 465次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 527次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 545次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 495次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 314次使用
-
- JavaScript函数定义及示例详解
- 2025-05-11 502浏览
-
- 智能体安全引领产业升级——国内AI安全产品市场深度分析
- 2026-08-21 501浏览
-
- CSS变量简化按钮悬停效果技巧
- 2026-05-31 501浏览
-
- JavaScript符号类型详解与应用
- 2026-05-31 501浏览
-
- HTML剪贴板复制粘贴怎么用
- 2026-05-26 501浏览


