
Python爬虫抓取股票数据教程
文章不知道大家是否熟悉?今天我将给大家介绍《Python爬虫抓取股票行情数据教程》,这篇文章主要会讲到等等知识点,如果你在看完本篇文章后,有更好的建议或者发现哪里有问题,希望大家都能积极评论指出,谢谢!希望我们能一起加油进步!
首先推荐使用AKShare等开源库获取股票数据,以避免反爬问题;文中介绍了通过requests和BeautifulSoup抓取新浪财经网页数据的方法,但指出其易受网页结构变化影响;相比之下,AKShare提供稳定接口,支持A股实时行情和历史数据获取,建议控制请求频率并遵守网站协议,优先选择合规方式。

抓取股票行情数据是Python爬虫常见的应用场景之一。很多金融网站如新浪财经、东方财富网、Yahoo Finance等提供实时或延时的股票数据,通过编写爬虫程序可以自动化获取这些信息,用于分析、监控或可视化展示。下面介绍如何使用Python从公开金融网站获取股票数据。
选择合适的数据源
在开始前,先确定你要抓取的网站。国内常用的数据源包括:
- 新浪财经(https://finance.sina.com.cn):提供A股、港股、美股实时行情
- 东方财富网(https://www.eastmoney.com):数据全面,更新及时
- Tushare、AKShare 等开源库:非网页爬虫,但可直接获取结构化数据,推荐优先考虑
注意:部分网站有反爬机制,频繁请求可能被封IP,建议控制请求频率,并查看网站的robots.txt和用户协议是否允许爬取。
使用requests和BeautifulSoup抓取网页数据
以新浪财经的个股页面为例,比如获取贵州茅台(600519)的实时行情:
示例代码:import requests from bs4 import BeautifulSoup import timeurl = "https://finance.sina.com.cn/realstock/company/sh600519/nc.shtml" headers = { 'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0 Safari/537.36' }
response = requests.get(url, headers=headers) if response.status_code == 200: soup = BeautifulSoup(response.text, 'html.parser')
查找价格元素(需根据实际网页结构调整)
price_tag = soup.find('div', class_='price up') or soup.find('div', class_='price down') if price_tag: print("当前股价:", price_tag.get_text(strip=True)) else: print("未找到价格数据")else: print("请求失败,状态码:", response.status_code)
说明:这种方法依赖HTML结构,一旦网页改版就可能失效,适合学习,但不推荐用于长期运行。
调用公开API获取结构化数据(推荐方式)
相比解析网页,更稳定高效的方式是使用金融数据接口。例如:
- AKShare:专为中文金融数据设计的开源库,支持股票、基金、期货等
- Tushare:需要注册获取token,但数据质量高
import akshare as ak获取沪深A股实时行情
stock_zh_a_spot = ak.stock_zh_a_spot() print(stock_zh_a_spot[['symbol', 'name', 'price', 'change_percent']])
获取单只股票历史数据
stock_hist = ak.stock_zh_a_daily(symbol="sh600519") print(stock_hist.tail())
AKShare底层仍可能是爬虫,但它封装了逻辑,处理了反爬和格式转换,极大简化开发工作。
注意事项与合规提醒
编写爬虫时务必注意:
- 不要高频请求,建议间隔至少1-2秒
- 添加headers模拟浏览器访问
- 避免抓取受版权保护的深度数据(如F10、研报)
- 商业用途需获得授权
- 优先使用官方API或合规数据平台
基本上就这些。对于初学者,建议从AKShare入手,既能快速获取数据,又避免陷入复杂的反爬斗争。
终于介绍完啦!小伙伴们,这篇关于《Python爬虫抓取股票数据教程》的介绍应该让你收获多多了吧!欢迎大家收藏或分享给更多需要学习的朋友吧~golang学习网公众号也会发布文章相关知识,快来关注吧!
 Win8快速关机命令与技巧
- 上一篇
- Win8快速关机命令与技巧

- 下一篇
- node-oracledbThin模式报错0x939解决方法
-
- 文章 · python教程 | 27分钟前 |
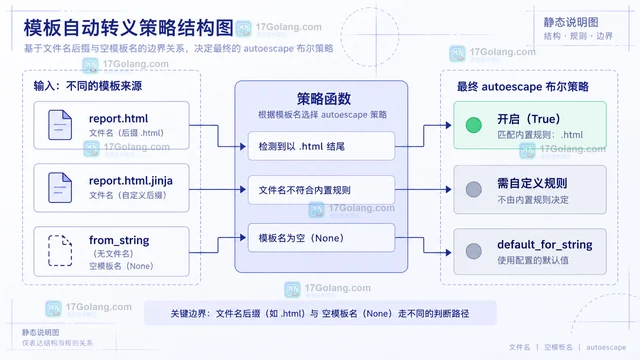
- Python Jinja按模板后缀开启自动转义怎么配置
- 320浏览 收藏
-
- 文章 · python教程 | 28分钟前 | Python 模板变量 Jinja StrictUndefined UndefinedError
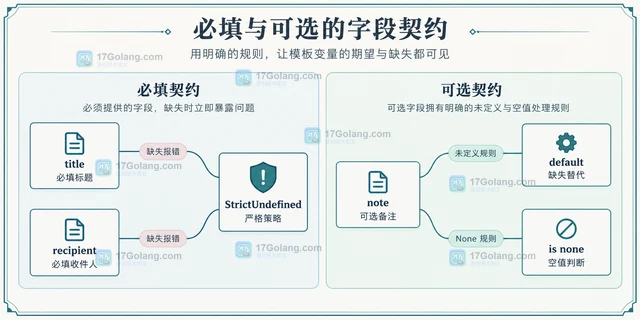
- Python Jinja StrictUndefined怎样暴露缺失模板变量
- 477浏览 收藏
-
- 文章 · python教程 | 31分钟前 | CLI · 命令行 · python · 命令行选项 list[str] Python Typer Typer重复参数 Typer列表参数 list[float]
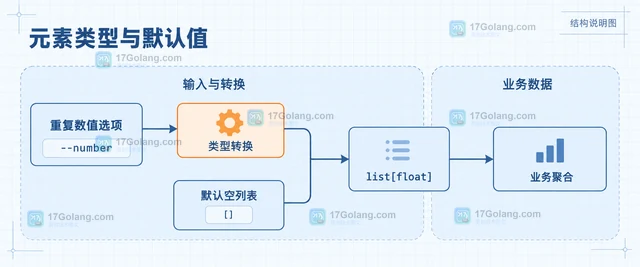
- Python Typer可重复参数怎样收集为列表
- 157浏览 收藏
-
- 文章 · python教程 | 34分钟前 | Python 后台任务 Worker Textual post_message
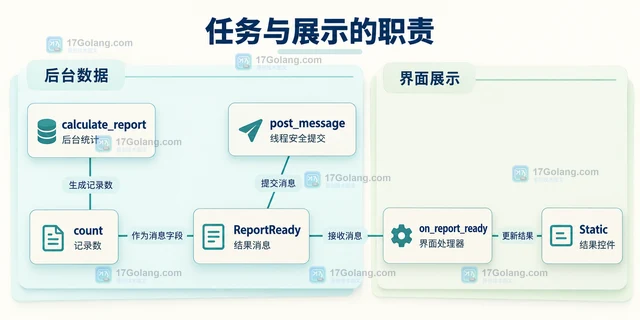
- Python Textual后台任务怎么把结果送回界面
- 317浏览 收藏
-
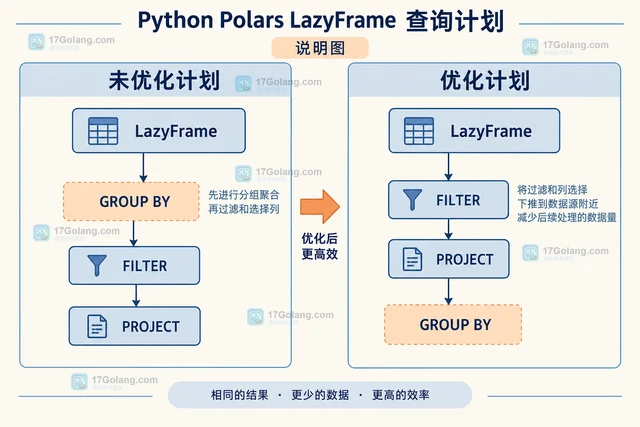
- 文章 · python教程 | 41分钟前 | 查询优化 · Python explain 查询计划 Polars LazyFrame show_graph
- Python Polars LazyFrame怎样查看查询计划
- 421浏览 收藏
-
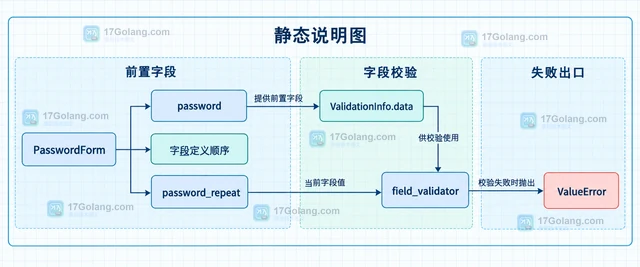
- 文章 · python教程 | 43分钟前 | 数据校验 · python · Python Pydantic field_validator model_validator 联合约束
- Python Pydantic怎样对多个字段实施联合约束
- 210浏览 收藏
-
- 文章 · python教程 | 45分钟前 | Python Pydantic After field_validator before
- Python Pydantic字段校验器before与after怎么选择
- 469浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 463次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 526次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 543次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 491次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 310次使用
-
- Python sqlite3 Connection serialize 怎么导出数据库快照:备份窗口、内存占用与恢复校验
- 2026-08-26 501浏览
-
- Python监控网页状态:requests异常处理实战
- 2026-05-29 501浏览
-
- TensorFlow模型部署为API的TF Serving方法
- 2026-05-26 501浏览
-
- Python字符串编码转换:encode与decode详解
- 2026-05-16 501浏览
-
- TensorFlow裁剪无用算子方法详解
- 2026-05-15 501浏览


