
MySQL中的自增主键怎么修改
大家好,今天本人给大家带来文章《MySQL中的自增主键怎么修改》,文中内容主要涉及到,如果你对数据库方面的知识点感兴趣,那就请各位朋友继续看下去吧~希望能真正帮到你们,谢谢!

一、自增值保存在哪儿?
不同的引擎对于自增值的保存策略不同
1.MyISAM引擎的自增值保存在数据文件中
2.InnoDB引擎的自增值,在MySQL5.7及之前的版本,自增值保存在内存里,并没有持久化。每次重启后,第一次打开表的时候,都会去找自增值的最大值max(id),然后将max(id)+步长作为这个表当前的自增值
select max(ai_col) from table_name for update;
在MySQL8.0版本,将自增值的变更记录在了redo log中,重启的时候依靠redo log恢复重启之前的值
二、自增值修改机制
如果字段id被定义为AUTO_INCREMENT,在插入一行数据的时候,自增值的行为如下:
1.如果插入数据时id字段指定为0、null或未指定值,那么就把这个表当前的AUTO_INCREMENT值填到自增字段
2.如果插入数据时id字段指定了具体的值,就直接使用语句里指定的值
假设,某次要插入的值是X,当前的自增值是Y
1.如果X 2.如果X>=Y,就需要把当前自增值修改为新的自增值 新的自增值生成算法是:从auto_increment_offset(初始值)开始,以auto_increment_increment(步长)为步长,持续叠加,直到找到第一个大于X的值,作为新的自增值 创建一个表t,其中id是自增主键字段、c是唯一索引,建表语句如下: 假设,表t里面已经有了(1,1,1)这条记录,这时再执行一条插入数据命令: 执行流程如下: 1.执行器调用InnoDB引擎接口写入一行,传入的这一行的值是(0,1,1) 2.InnoDB发现用于没有指定自增id的值,获取表t当前的自增值2 3.将传入的行的值改成(2,1,1) 4.将表的自增值改成3 5.继续执行插入数据操作,由于已经存在c=1的记录,所以报Duplicate key error(唯一键冲突),语句返回 对应的执行流程图如下: 唯一键冲突和事务回滚都会导致自增主键id不连续的情况 自增id锁并不是一个事务锁,而是每次申请完就马上释放,以便允许别的事务再申请 但在MySQL5.0版本的时候,自增锁的范围是语句级别。也就是说,如果一个语句申请了一个表自增锁,这个锁会等语句执行结束以后才释放 MySQL5.1.22版本引入了一个新策略,新增参数innodb_autoinc_lock_mode,默认值是1 1.这个参数设置为0,表示采用之前MySQL5.0版本的策略,即语句执行结束后才释放锁 2.这个参数设置为1 普通insert语句,自增锁在申请之后就马上释放 类似insert … select这样的批量插入数据的语句,自增锁还是要等语句结束后才被释放 3.这个参数设置为2,所有的申请自增主键的动作都是申请后就释放锁 为了数据的一致性,默认设置为1 sessionB先插入了两行数据(1,1,1)、(2,2,2) sessionA来申请自增id得到id=3,插入了(3,5,5) 之后,sessionB继续执行,插入两条记录(4,3,3)、(5,4,4) 当binlog_format=statement的时候,两个session是同时执行插入数据命令的,所以binlog里面对表t2的更新日志只有两种情况:要么先记sessionA的,要么先记录sessionB的。无论是哪一种,这个binlog拿到从库执行,或者用来恢复临时实例,备库和临时实例里面,sessionB这个语句执行出来,生成的结果里面,id都是连续的。这时,这个库就发生了数据不一致 解决这个问题的思路: 1)让原库的批量插入数据语句,固定生成连续的id值。所以,自增锁直到语句执行结束才释放,就是为了达到这个目的 2)在binlog里面把插入数据的操作都如实记录进来,到备库执行的时候,不再依赖于自增主键去生成。也就是把innodb_autoinc_lock_mode设置为2,同时binlog_format设置为row 如果有批量插入数据(insert … select、replace … select和load data)的场景时,从并发插入数据性能的角度考虑,建议把innodb_autoinc_lock_mode设置为2,同时binlog_format设置为row,这样做既能并发性,又不会出现数据一致性的问题 对于批量插入数据的语句,MySQL有一个批量申请自增id的策略: 1.语句执行过程中,第一次申请自增id,会分配1个 2.1个用完以后,这个语句第二次申请自增id,会分配2个 3.2个用完以后,还是这个语句,第三次申请自增id,会分配4个 4.依次类推,同一个语句去申请自增id,每次申请到的自增id个数都是上一次的两倍 insert … select,实际上往表t2中插入了4行数据。但是,这四行数据是分三次申请的自增id,第一次申请到了id=1,第二次被分配了id=2和id=3,第三次被分配到id=4到id=7 由于这条语句实际上只用上了4个id,所以id=5到id=7就被浪费掉了。之后,再执行 这是主键id出现自增id不连续的第三种原因 自增主键字段在达到定义类型上限后,再插入一行记录,则会报主键冲突的错误 第一个insert语句插入数据成功后,这个表的AUTO_INCREMENT没有改变(还是4294967295),就导致了第二个insert语句又拿到相同的自增id值,再试图执行插入语句,报主键冲突错误 到这里,我们也就讲完了《MySQL中的自增主键怎么修改》的内容了。个人认为,基础知识的学习和巩固,是为了更好的将其运用到项目中,欢迎关注golang学习网公众号,带你了解更多关于mysql的知识点!三、自增值的修改时机
CREATE TABLE `t` (
  `id` int(11) NOT NULL AUTO_INCREMENT,
  `c` int(11) DEFAULT NULL,
  `d` int(11) DEFAULT NULL,
  PRIMARY KEY (`id`),
  UNIQUE KEY `c` (`c`)
) ENGINE=InnoDB;
insert into t values(null, 1, 1);

在这之后,再插入新的数据行时,拿到的自增id就是3。出现了自增主键不连续的情况四、自增锁的优化

如果sessionB申请了自增值以后马上就释放自增锁,那么就可能出现这样的情况:insert into t values(null, 1,1);
insert into t values(null, 2,2);
insert into t values(null, 3,3);
insert into t values(null, 4,4);
create table t2 like t;
insert into t2(c,d) select c,d from t;
insert into t2 values(null, 5,5);
insert into t2 values(null, 5,5),实际上插入了的数据就是(8,5,5)五、自增主键用完了

CREATE TABLE t ( id INT UNSIGNED auto_increment PRIMARY KEY ) auto_increment = 4294967295;
INSERT INTO t VALUES(NULL);
INSERT INTO t VALUES(NULL);
 MySQL数据库之数据表怎么操作DDL数据定义语言
- 上一篇
- MySQL数据库之数据表怎么操作DDL数据定义语言

- 下一篇
- Linux下怎么查看MySql存储引擎
-
- 数据库 · MySQL | 9小时前 |
- MySQL EXPLAIN ANALYZE定位排序临时表的排查方法
- 434浏览 收藏
-
- 数据库 · MySQL | 10小时前 | MySQL · JSON ·
- MySQL JSON多值索引处理数组成员检索的设计要点
- 404浏览 收藏
-
- 数据库 · MySQL | 12小时前 | MySQL · 数据库 · mysql SQL JSON JSON_TABLE
- MySQL JSON_TABLE为缺失字段提供默认值的映射方法
- 445浏览 收藏
-
- 数据库 · MySQL | 13小时前 |
- MySQL CTE拆分多阶段聚合查询的维护方法
- 418浏览 收藏
-
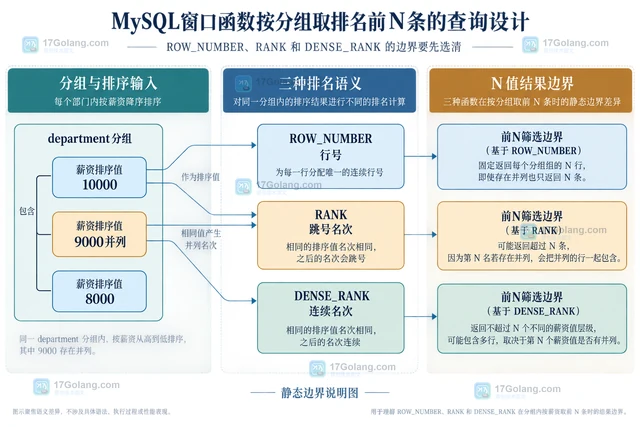
- 数据库 · MySQL | 14小时前 | MySQL · 数据库 · mysql 窗口函数 ROW_NUMBER RANK DENSE_RANK
- MySQL窗口函数按分组取排名前N条的查询设计
- 465浏览 收藏
-
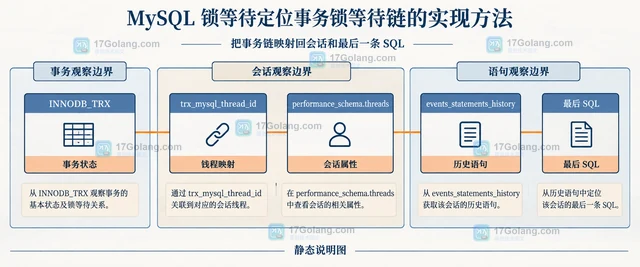
- 数据库 · MySQL | 18小时前 | MySQL · InnoDB · MySQL锁等待 performance_schema.data_lock_waits data_locks锁对象 InnoDB事务阻塞 锁等待链定位
- MySQL 锁等待定位事务锁等待链的实现方法
- 497浏览 收藏
-
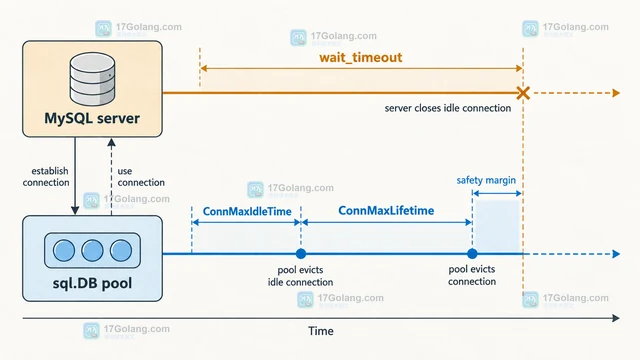
- 数据库 · MySQL | 19小时前 | MySQL · 连接池 · database/sql ·
- MySQL 连接池配置连接池避免拿到失效连接的实现方法
- 392浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 141次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 207次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 150次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 131次使用
-

- CMMLU
- 深入了解CMMLU中文评估基准,涵盖67个学科主题,提供数据集下载、Zero-shot/Five-shot评估方法及排行榜,助力优化中文语言模型性能。
- 120次使用
-
- MySQL JSON_TABLE 展开数组时如何保留缺失字段
- 2026-09-10 501浏览
-
- MySQL 分区表怎么处理跨分区唯一键:分区列约束与建表取舍
- 2026-08-30 501浏览
-
- MySQL权限管理设置全攻略
- 2026-03-29 501浏览
-
- MySQL分片实现方法及常见方案解析
- 2025-06-24 501浏览
-
- MySQL表空间碎片怎么清理?超详细优化教程
- 2025-06-13 501浏览


