
Golang错误处理与断言技巧解析
欢迎各位小伙伴来到golang学习网,相聚于此都是缘哈哈哈!今天我给大家带来《Golang错误断言与测试处理技巧》,这篇文章主要讲到等等知识,如果你对Golang相关的知识非常感兴趣或者正在自学,都可以关注我,我会持续更新相关文章!当然,有什么建议也欢迎在评论留言提出!一起学习!
答案:Golang测试中错误断言需结合t.Errorf与t.Fatalf选择、errors.Is类型判断、清晰错误信息输出,并借助testify等工具提升可读性与覆盖率,确保测试可靠性。

Golang测试中,错误断言的处理核心在于精准定位问题,并提供清晰的错误信息,以便快速修复。关键在于使用testing包提供的各种断言函数,并结合自定义的错误处理逻辑,确保测试的可靠性和可维护性。
解决方案
在Golang测试中,错误断言和处理并非一蹴而就,而是需要根据不同的测试场景选择合适的策略。最常用的就是testing包提供的断言函数,例如t.Errorf、t.Fatalf等。然而,仅仅依靠这些基础函数是不够的,我们需要更高级的技巧来应对复杂的测试需求。
首先,要明确的是,t.Errorf和t.Fatalf的区别在于,前者会继续执行后续的测试用例,而后者则会立即停止当前测试用例的执行。选择哪个取决于你的需求:如果一个断言失败不应该影响后续的测试,那么使用t.Errorf;反之,如果一个断言失败意味着整个测试用例都不可靠,那么使用t.Fatalf。
例如,假设我们要测试一个函数Add,它接受两个整数作为参数,并返回它们的和。一个简单的测试用例可能是这样的:
func TestAdd(t *testing.T) {
    result := Add(2, 3)
    expected := 5
    if result != expected {
        t.Errorf("Add(2, 3) = %d, expected %d", result, expected)
    }
}这段代码很简单,但它已经展示了基本的断言技巧。然而,如果Add函数可能会返回错误呢?例如,如果它处理了溢出情况,并返回一个错误。这时候,我们需要更复杂的断言逻辑。
func TestAddWithError(t *testing.T) {
    result, err := AddWithOverflowCheck(math.MaxInt64, 1)
    if err == nil {
        t.Fatalf("Expected error, but got nil")
    }

    if !errors.Is(err, ErrOverflow) { // 假设定义了ErrOverflow
        t.Errorf("Expected ErrOverflow, but got %v", err)
    }

    // 还可以检查错误信息是否符合预期
    if err.Error() != "integer overflow" {
        t.Errorf("Unexpected error message: %s", err.Error())
    }

    // 如果没有错误,则检查结果是否符合预期
    result, err = AddWithOverflowCheck(2, 3)
    if err != nil {
        t.Fatalf("Unexpected error: %v", err)
    }
    expected := 5
    if result != expected {
        t.Errorf("AddWithOverflowCheck(2, 3) = %d, expected %d", result, expected)
    }
}这里,我们不仅检查了返回值,还检查了错误。使用了errors.Is来判断错误类型,这比直接比较错误字符串更可靠。
如何编写可读性高的断言信息?
编写清晰的断言信息至关重要,它能帮助你快速定位问题。避免使用模糊不清的断言信息,例如t.Errorf("Something went wrong")。相反,应该提供足够的信息,包括输入值、实际输出值和期望输出值。
例如,t.Errorf("Add(%d, %d) = %d, expected %d", a, b, result, expected)就比t.Errorf("Add failed")更有用。
此外,可以考虑使用第三方库来简化断言过程。例如,testify库提供了更丰富的断言函数,可以减少样板代码。
如何处理复杂的测试场景?
对于复杂的测试场景,例如并发测试、性能测试等,需要更高级的技巧。例如,可以使用sync.WaitGroup来等待所有goroutine完成,或者使用testing.B来进行性能测试。
在并发测试中,需要特别注意竞态条件。可以使用go test -race命令来检测竞态条件。如果发现竞态条件,可以使用互斥锁(sync.Mutex)或其他同步机制来避免。
性能测试则需要关注CPU使用率、内存分配等指标。可以使用go tool pprof来分析性能瓶颈。
func BenchmarkAdd(b *testing.B) {
    for i := 0; i < b.N; i++ {
        Add(1, 1) // 假设 Add 函数没有副作用
    }
}这个简单的基准测试可以帮助你了解Add函数的性能。
如何提高测试覆盖率?
测试覆盖率是衡量测试质量的重要指标。高覆盖率并不意味着没有bug,但它可以提高你对代码的信心。可以使用go test -cover命令来查看测试覆盖率。
为了提高测试覆盖率,需要编写更多的测试用例,覆盖各种边界情况和异常情况。可以使用代码覆盖率工具来找出未覆盖的代码行,并编写相应的测试用例。
总而言之,Golang测试中的错误断言与处理是一个持续学习和实践的过程。需要不断探索新的技巧和工具,才能编写出高质量的测试代码。记住,好的测试代码不仅可以帮助你发现bug,还可以提高代码的可维护性和可读性。
今天关于《Golang错误处理与断言技巧解析》的内容就介绍到这里了,是不是学起来一目了然!想要了解更多关于golang,测试,errors.Is,错误断言,t.Errorf的内容请关注golang学习网公众号!
 Win10流量计费设置方法详解
- 上一篇
- Win10流量计费设置方法详解

- 下一篇
- 今日头条长视频观看技巧全解析
-
- Golang · Go教程 | 56分钟前 |
- 设计可重试错误与永久错误的稳定边界
- 263浏览 收藏
-
- Golang · Go教程 | 1小时前 |
- 用错误包装保留上下文并支持 errors.Is 分类判断
- 468浏览 收藏
-
- Golang · Go教程 | 1小时前 |
- 把 trace 标识贯穿日志上下文但不污染业务函数
- 256浏览 收藏
-
- Golang · Go教程 | 2小时前 |
- 用 slog 建立请求级字段并统一 JSON 日志输出
- 120浏览 收藏
-
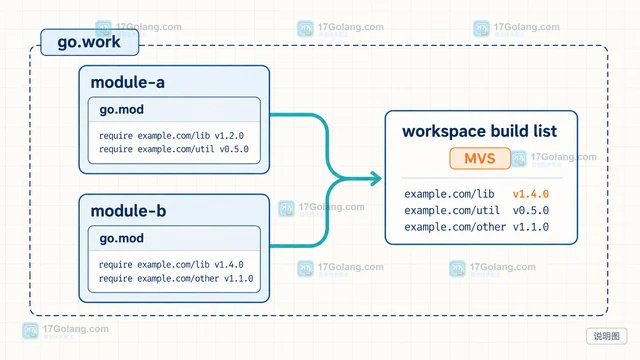
- Golang · Go教程 | 3小时前 |
- 通过 go work sync 对齐工作区构建列表与模块依赖
- 370浏览 收藏
-
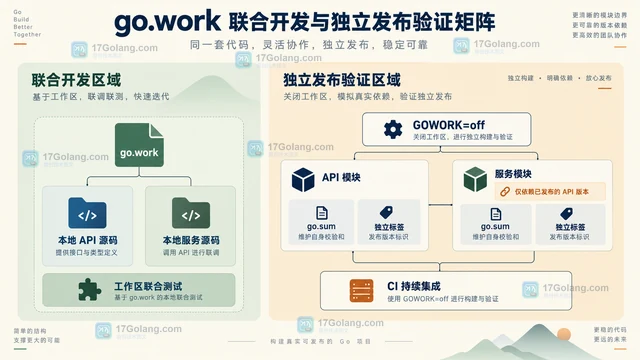
- Golang · Go教程 | 3小时前 | Go教程 · gowork go.work 多模块开发 Go Modules Go多模块工作区 独立发布
- 用 go.work 同时开发两个模块并保持各自发布独立
- 201浏览 收藏
-
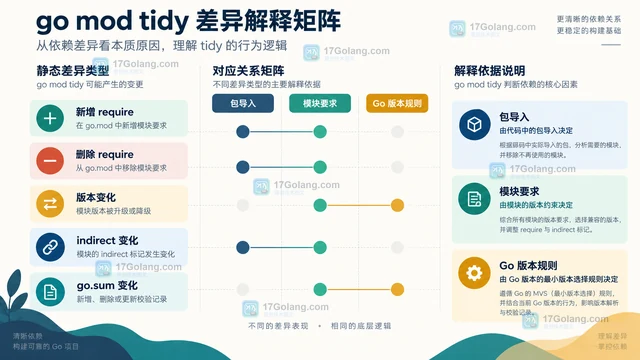
- Golang · Go教程 | 3小时前 | Go教程 · 工程实践 · go.mod go.sum 间接依赖 go mod tidy Go Modules 依赖整理
- 整理 go.mod 间接依赖并解释 tidy 的增删结果
- 247浏览 收藏
-
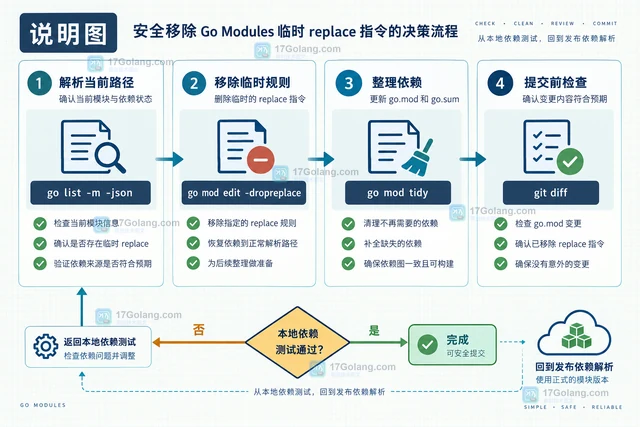
- Golang · Go教程 | 4小时前 |
- 通过 replace 临时联调本地依赖并在提交前移除替换
- 285浏览 收藏
-
- Golang · Go教程 | 4小时前 | Go教程 · 工程实践 · 语义化版本 go.work 依赖边界 多模块工作区 Go Modules
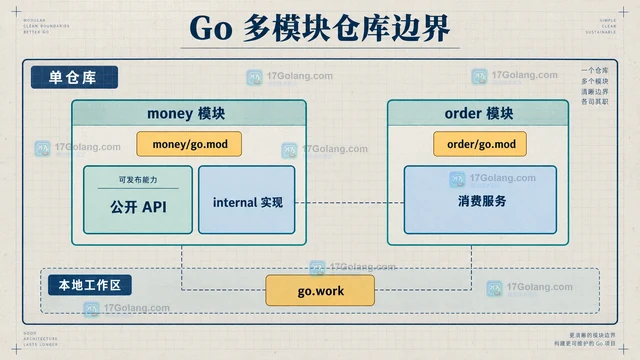
- 拆分内部模块并用语义化版本维护依赖边界
- 492浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 365次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 422次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 435次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 387次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 214次使用
-
- Java 性能优化上线清单:从定位、改造到灰度发布
- 2026-06-11 860浏览
-
- Spring Boot 压测验证:Gatling、JMeter 与性能回归门禁
- 2026-06-11 843浏览
-
- Java NMT 非堆内存排查:Direct Buffer、线程栈与 Metaspace 分析
- 2026-06-11 826浏览
-
- Spring Boot 容器内存优化:JVM 堆、非堆与 MaxRAMPercentage
- 2026-06-11 809浏览
-
- Tomcat 连接与线程参数调优:maxThreads、acceptCount 与 KeepAlive
- 2026-06-11 792浏览


