
Golang定时任务性能测试解析
**Golang定时任务性能基准测试解析:提升调度效率的关键** 在Go语言中,定时任务的性能至关重要。本文通过基准测试,深入解析Golang定时任务的性能瓶颈与优化策略。我们将探讨如何利用`go test -bench=.`命令量化不同调度方案的性能差异,例如延迟、吞吐量和内存消耗。文章将重点介绍标准库`time.Ticker`的基础用法,并通过示例展示如何测试其周期性任务的性能。同时,我们也会分析第三方库如`clockwork`在复杂调度场景下的适用性,并评估其可能引入的额外开销。此外,文章还将提供优化建议,包括复用定时器、防止goroutine泄漏、使用模拟时钟加速测试,以及精确控制测量范围,旨在帮助开发者选择最合适的定时任务方案,提升Go应用的整体性能。
Go语言基准测试可量化定时任务调度性能,通过go test -bench=.比较不同方案的延迟、吞吐量和内存开销。使用time.Ticker可测试基础周期任务,示例中每毫秒触发一次共100次,需调用ticker.Stop()避免资源泄漏;第三方库如clockwork适用于复杂调度,但需评估其抽象层带来的额外开销,可通过-benchmem分析内存分配。优化要点包括:复用定时器以减少GC压力、防止goroutine泄漏、使用模拟时钟加速高频测试、精确控制测量范围仅包含核心逻辑。合理设计基准测试能真实反映调度方案性能差异,指导技术选型与优化。

Go语言的基准测试(Benchmark)是评估代码性能的有效方式,尤其在测试定时任务调度这类对时间精度和资源消耗敏感的场景中非常实用。通过go test -bench=.命令,可以量化不同调度方案的性能差异,比如执行延迟、吞吐量和内存分配情况。
使用标准库 time.Ticker 进行基准测试
Go 的 time.Ticker 是实现周期性任务的基础工具。在基准测试中,可以通过模拟固定次数的任务触发,测量其平均耗时和内存开销。
示例代码:
func BenchmarkTicker_Schedule100(b *testing.B) {for i := 0; i < b.N; i++ {
ticker := time.NewTicker(1 * time.Millisecond)
count := 0
done := make(chan bool)
go func() {
for range ticker.C {
count++
if count >= 100 {
ticker.Stop()
done <- true
break
}
}
}()
<-done
}
}
该测试模拟每毫秒触发一次任务,共执行100次。b.N 控制整个过程重复多少轮,从而得出每次调度的平均开销。注意要调用 ticker.Stop() 防止资源泄漏,否则会影响结果准确性。
对比第三方调度库如 go-cron 或 clockwork
对于更复杂的调度逻辑(如按 cron 表达式运行),开发者常使用第三方库。基准测试可以帮助判断这些库是否引入过多开销。
以 clockwork 为例:
import "github.com/whiteShtef/clockwork"func BenchmarkClockwork_EverySecond(b *testing.B) {
for i := 0; i < b.N; i++ {
clock := clockwork.NewRealClock()
taskRan := make(chan struct{}, 1)
clock.Schedule().Every(1).Second().Do(func() {
taskRan <- struct{}{}
})
time.Sleep(1100 * time.Millisecond) // 等待至少一次执行
select {
case <-taskRan:
default:
b.Fatal("task did not run")
}
}
}
这类测试重点在于:相同频率下,与原生 time.Ticker 相比,额外抽象层带来的延迟和内存增长是否可接受。通常建议运行 benchmem 查看分配情况:
go test -bench=BenchmarkClockwork_EverySecond -benchmem优化调度性能的关键点
在高并发或高频调度场景中,以下几点直接影响性能表现:
- 避免频繁创建定时器:反复 new ticker 或 timer 会增加 GC 压力。尽量复用或使用调度池管理。
- 减少 goroutine 泄漏:每个调度任务若启动新 goroutine,必须确保能正确退出,否则会导致内存持续增长。
- 使用模拟时钟测试高频逻辑:在单元测试中使用 clockwork.SimulatedClock 或类似机制,跳过真实等待时间,加快测试速度同时保证精度。
- 控制测量粒度:只测量核心调度逻辑,不包含初始化或 setup 时间,确保数据反映真实调度效率。
基本上就这些。Go 的基准测试系统足够灵活,配合合理的测试设计,能清晰揭示不同定时任务方案的实际性能差异。关键是保持测试逻辑贴近真实使用场景,才能得出有指导意义的结果。
以上就是本文的全部内容了,是否有顺利帮助你解决问题?若是能给你带来学习上的帮助,请大家多多支持golang学习网!更多关于Golang的相关知识,也可关注golang学习网公众号。
 PHP自动加载原理与实现方式解析
- 上一篇
- PHP自动加载原理与实现方式解析

- 下一篇
- CRDT无冲突数据结构实现解析
-
- Golang · Go教程 | 30分钟前 | go · net/http ·
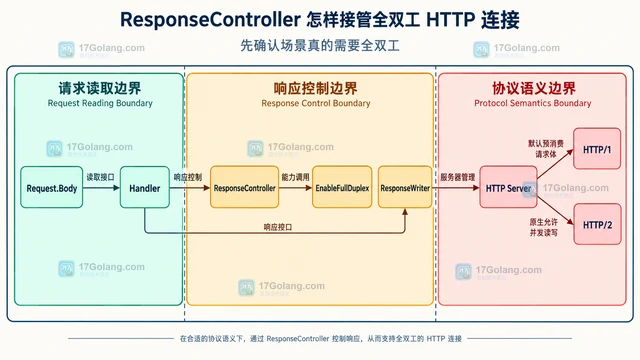
- ResponseController 怎样接管全双工 HTTP 连接
- 199浏览 收藏
-
- Golang · Go教程 | 48分钟前 | go · net/http ·
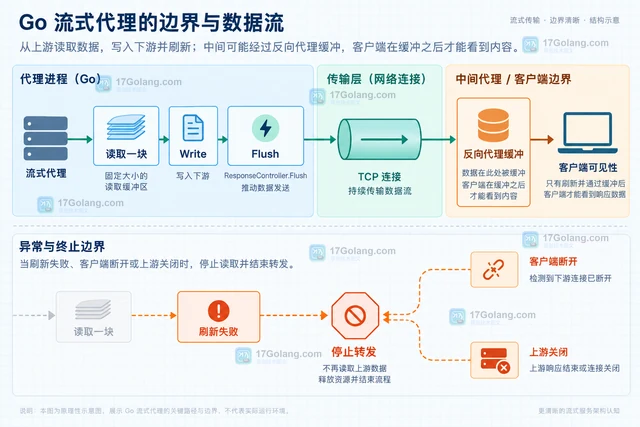
- 用 ResponseController 在代理中逐块刷新数据
- 491浏览 收藏
-
- Golang · Go教程 | 1小时前 | go · Go教程 · net/http · WriteTimeout SSE 流式响应 SetWriteDeadline Go ResponseController
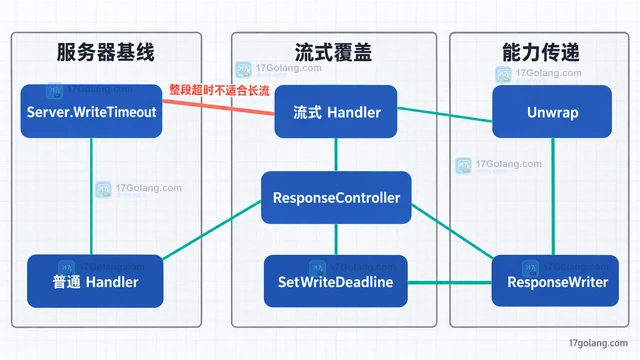
- ResponseController 如何为流式响应设置单独写超时
- 446浏览 收藏
-
- Golang · Go教程 | 1小时前 | go · 文件上传 · Go 临时文件 资源清理 mime/multipart multipart
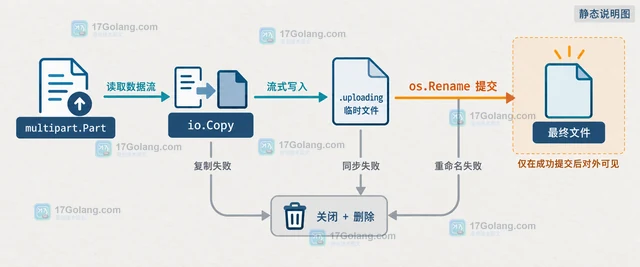
- multipart 上传失败后怎样及时清理临时资源
- 251浏览 收藏
-
- Golang · Go教程 | 1小时前 | 文件上传 · Go教程 · net/http · 接口安全 · MaxBytesReader io.LimitReader 流式上传 Go MultipartReader multipart字段限制
- 用 MultipartReader 限制每个表单字段的读取量
- 305浏览 收藏
-
- Golang · Go教程 | 2小时前 |
- OpenTelemetry Go 怎样处理乱序 Span 并还原服务调用关系
- 148浏览 收藏
-
- Golang · Go教程 | 3小时前 |
- slog 自定义 Handler 怎样批量提交结构化日志
- 240浏览 收藏
-
- Golang · Go教程 | 3小时前 | go · 错误排查 · 错误日志 Go slog HandlerOptions AddSource 调用位置
- 用 slog HandlerOptions 为错误日志补充调用位置
- 465浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 393次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 472次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 478次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 421次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 248次使用
-
- Java 性能优化上线清单:从定位、改造到灰度发布
- 2026-06-11 860浏览
-
- Spring Boot 压测验证:Gatling、JMeter 与性能回归门禁
- 2026-06-11 843浏览
-
- Java NMT 非堆内存排查:Direct Buffer、线程栈与 Metaspace 分析
- 2026-06-11 826浏览
-
- Spring Boot 容器内存优化:JVM 堆、非堆与 MaxRAMPercentage
- 2026-06-11 809浏览
-
- Tomcat 连接与线程参数调优:maxThreads、acceptCount 与 KeepAlive
- 2026-06-11 792浏览


