
生成器是什么?详解惰性求值机制
学习文章要努力,但是不要急!今天的这篇文章《生成器是什么?惰性求值详解》将会介绍到等等知识点,如果你想深入学习文章,可以关注我!我会持续更新相关文章的,希望对大家都能有所帮助!
生成器与传统数据结构的根本差异在于其惰性求值和按需生成的机制,1. 列表等传统结构会一次性将所有数据加载到内存,而生成器通过yield关键字实现函数执行的暂停与恢复,仅在需要时生成值;2. 这使得生成器内存占用极低,适合处理海量数据或无限序列;3. 生成器是一次性的,无法重复遍历,这是为内存效率做出的权衡;4. 在实际应用中,生成器可用于逐行读取大文件、批量加载机器学习数据以及生成无限序列等场景;5. 在Python中可通过定义含yield的函数或使用生成器表达式(用()包裹的推导式)来创建生成器,二者均利用惰性求值提升程序性能和资源利用率。

生成器本质上是一种特殊的迭代器,它的核心价值在于“惰性求值”。简单来说,它不会一次性把所有数据都准备好放在内存里,而是当你需要一个数据时,它才即时生成一个给你。这种按需生成数据的机制,极大地优化了内存使用,尤其是在处理海量数据或者无限序列时,简直是神器。
当我们谈论工作流程,尤其是数据处理的工作流程时,内存和效率往往是绕不过去的坎。传统的做法,比如构建一个庞大的列表,虽然直观,但当数据量大到一定程度,内存就成了瓶颈,程序可能直接崩溃,或者慢得让人抓狂。生成器就是来解决这个痛点的。
它的工作原理很巧妙。你不是一次性返回一个完整的数据集,而是通过yield关键字,暂停函数的执行,并返回一个值。下次你需要下一个值时,函数会从上次暂停的地方继续执行,而不是从头再来。这种“走一步看一步”的策略,意味着无论你的数据有多大,内存里始终只保留当前处理所需的那一点点信息。这不仅仅是节约内存,它还意味着更快的启动时间,因为你不需要等待所有数据都加载完毕。对于那些需要处理TB级日志文件、实时数据流,或者需要模拟无限序列的场景,生成器简直是性能和资源管理上的救星。它改变了我们思考数据流的方式,从“一次性全部拥有”变成了“需要时再获取”。
生成器与传统数据结构的根本差异在哪里?
提到生成器,很多人自然会把它和列表(list)或者普通的迭代器混淆。但它们之间有着本质的区别,理解这些差异,才能真正体会到生成器的魅力。列表,我的理解是“一次性生产,全部入库”的模式。你定义一个列表,Python就会把所有元素都计算出来,然后老老实实地放到内存里。这对于小数据集当然没问题,直观且方便。但想象一下,如果你要处理一个包含数亿条记录的文件,或者生成一个无穷数列,列表这种“全量存储”的策略立刻就暴露了它的短板:内存会瞬间爆炸。
而生成器呢,它更像是一个“按需生产,即时交付”的工厂。它不会预先生产所有的产品,而是当你有订单(也就是调用next()或者进行迭代)时,它才开始生产你需要的那个产品。一旦产品交付,它就会把生产线暂停,等待下一个订单。这意味着,无论你最终需要多少个产品,工厂里同时在生产的,永远只有那一个。这种“惰性求值”的特性,让生成器在处理大规模数据时,能够保持极低的内存占用。它实现了迭代器协议,所以你可以用for循环来遍历它,但它的内部机制决定了它是一次性的,遍历完就“空”了,不能像列表那样反复使用,除非你重新创建一个。这是它为了内存效率做出的权衡。
哪些真实场景下,生成器能发挥出惊人的效率?
生成器在很多“看似不可能”的任务中都能大放异彩。我个人觉得,它最能体现价值的,就是那些需要处理海量数据,或者数据源本身就是“流式”的场景。
比如说,你可能需要分析一个服务器的访问日志,这个日志文件可能有几十个G,甚至上百个G。如果尝试把整个文件读进内存,你的电脑多半会直接罢工。但如果用生成器,你可以一行一行地读取文件,每次只处理当前这一行,处理完就丢弃,然后读取下一行。这样,无论文件多大,内存占用始终保持在一个很小的水平。
再比如,在机器学习或深度学习领域,训练模型时经常需要处理巨大的数据集。如果数据集无法一次性载入内存,你就可以用生成器来批量(batch)加载数据。每次只加载一个批次的数据进行训练,训练完就释放,然后加载下一个批次。这种方式不仅节省内存,还能让你的模型训练过程更加流畅。
还有一些更有趣的场景,比如模拟无限序列。你想生成一个斐波那契数列,或者一个随机数流,这些序列理论上可以无限延伸。用列表当然不可能,但用生成器,你可以轻松地实现一个“永不枯竭”的数据源。它只有在你真正需要下一个数时,才计算并给出它。这在模拟、测试或者某些算法设计中非常有用。
在Python中如何优雅地构建和运用生成器?
在Python里,构建生成器其实非常直观,主要有两种方式,都围绕着一个核心概念:yield关键字。
最常见也是最强大的方式,是定义一个包含yield关键字的函数。当你调用这个函数时,它不会立即执行函数体内的代码,而是返回一个生成器对象。只有当你开始迭代这个生成器对象(比如通过for循环,或者手动调用next()),函数体内的代码才会开始执行,直到遇到第一个yield语句,它会暂停执行,并将yield后面的值返回。下次继续迭代时,函数会从上次暂停的地方继续执行,直到遇到下一个yield,或者函数执行完毕。
def my_generator_function():
    print("开始生成...")
    yield 1
    print("生成了1,继续...")
    yield 2
    print("生成了2,结束。")

# 使用生成器
gen = my_generator_function()
print(next(gen)) # 输出:开始生成... 1
print(next(gen)) # 输出:生成了1,继续... 2
# print(next(gen)) # 再次调用会抛出 StopIteration,因为已经没有更多值了
另一种更简洁的方式是使用“生成器表达式”(Generator Expression)。它看起来非常像列表推导式,只是把方括号[]换成了圆括号()。这种方式尤其适合创建简单的、一次性的生成器,代码非常紧凑。
# 列表推导式 (立即计算并存储所有结果)
squares_list = [x*x for x in range(5)] # [0, 1, 4, 9, 16]

# 生成器表达式 (惰性计算,按需生成)
squares_gen = (x*x for x in range(5))

print(next(squares_gen)) # 0
print(next(squares_gen)) # 1
# ...
无论哪种方式,核心都是利用了yield的暂停-恢复机制,实现了数据的惰性生成。掌握了这两种创建方式,你就能在Python中灵活地运用生成器,处理各种数据挑战,让你的程序既高效又节省资源。它确实是Python在处理大数据和流式数据时的一把利器,值得每个开发者深入理解和实践。
理论要掌握,实操不能落!以上关于《生成器是什么?详解惰性求值机制》的详细介绍,大家都掌握了吧!如果想要继续提升自己的能力,那么就来关注golang学习网公众号吧!
 Laravel验证邮箱真实性技巧
- 上一篇
- Laravel验证邮箱真实性技巧

- 下一篇
- 量子信号首现传统网络,光纤即可传输
-
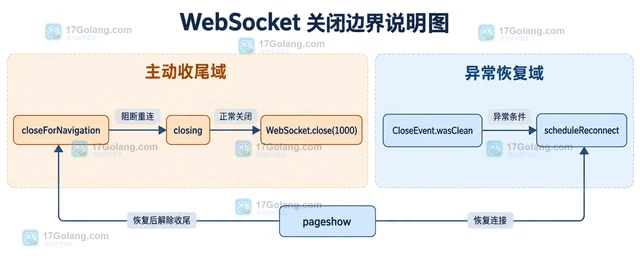
- 文章 · 前端 | 2天前 | 前端 · websocket ·
- WebSocket 重连退避与页面卸载的收尾
- 381浏览 收藏
-
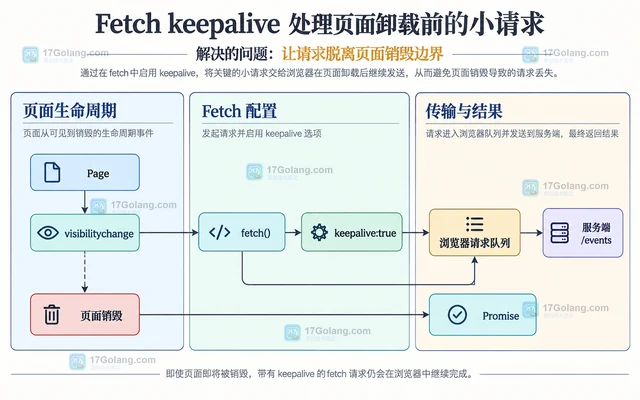
- 文章 · 前端 | 2天前 |
- Fetch keepalive 处理页面卸载前的小请求
- 291浏览 收藏
-
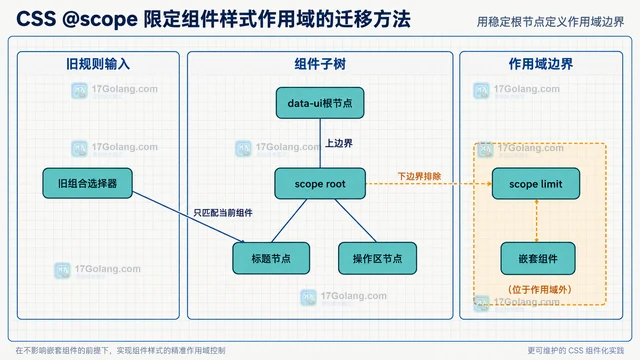
- 文章 · 前端 | 2天前 |
- CSS @scope 限定组件样式作用域的迁移方法
- 294浏览 收藏
-
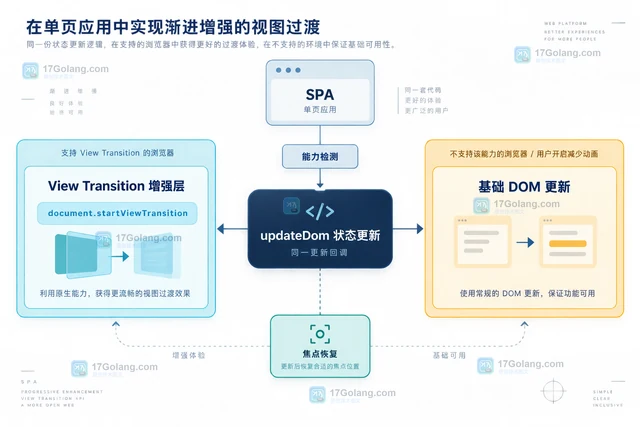
- 文章 · 前端 | 2天前 |
- View Transition API 在 SPA 状态切换中的降级方案
- 142浏览 收藏
-
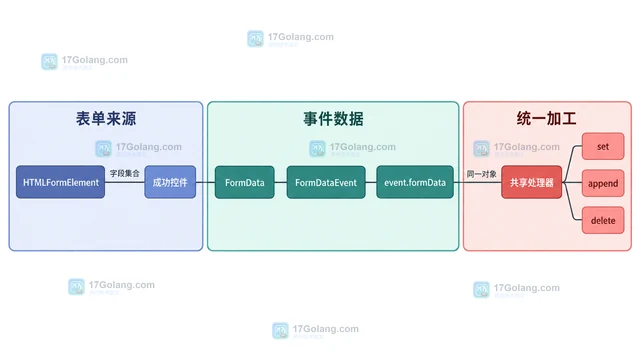
- 文章 · 前端 | 2天前 | javascript · 表单 · FormData FormDataEvent formdata事件 原生表单
- FormDataEvent 统一拦截原生表单数据的实现
- 288浏览 收藏
-
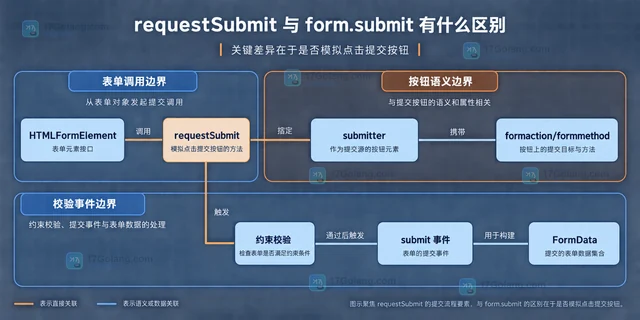
- 文章 · 前端 | 3天前 | html · javascript · 表单 · requestSubmit form.submit HTML表单校验
- requestSubmit 与 form.submit 有什么区别
- 392浏览 收藏
-
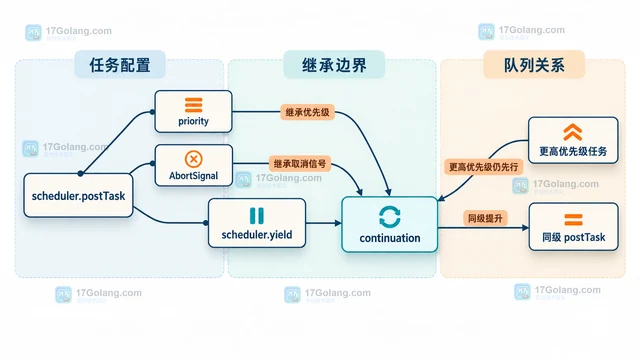
- 文章 · 前端 | 3天前 |
- scheduler.yield 怎么把长任务拆开又保持优先级
- 110浏览 收藏
-
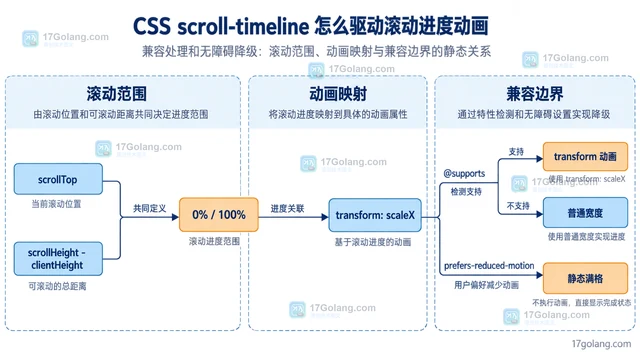
- 文章 · 前端 | 3天前 | CSS 滚动动画 animation-timeline scroll-timeline
- CSS scroll-timeline 怎么驱动滚动进度动画
- 251浏览 收藏
-
- 文章 · 前端 | 3天前 |
- IntersectionObserver scrollMargin 怎么处理嵌套滚动容器
- 380浏览 收藏
-
- 文章 · 前端 | 3天前 |
- dialog 的 closedby 属性怎么控制关闭方式
- 269浏览 收藏
-
- 文章 · 前端 | 3天前 |
- HTML popover 属性怎么管理轻量浮层
- 249浏览 收藏
-
- 文章 · 前端 | 4天前 |
- Navigation API 怎么拦截单页应用导航
- 167浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 287次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 340次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 342次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 306次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 129次使用
-
- JavaScript函数定义及示例详解
- 2025-05-11 502浏览
-
- 智能体安全引领产业升级——国内AI安全产品市场深度分析
- 2026-08-21 501浏览
-
- CSS变量简化按钮悬停效果技巧
- 2026-05-31 501浏览
-
- JavaScript符号类型详解与应用
- 2026-05-31 501浏览
-
- HTML剪贴板复制粘贴怎么用
- 2026-05-26 501浏览


