
Python图结构实现与关系建模详解
IT行业相对于一般传统行业,发展更新速度更快,一旦停止了学习,很快就会被行业所淘汰。所以我们需要踏踏实实的不断学习,精进自己的技术,尤其是初学者。今天golang学习网给大家整理了《Python图结构实现与复杂关系建模详解》,聊聊,我们一起来看看吧!
在Python中实现图结构并添加节点和边的属性,主要可通过三种方式:1. 使用字典模拟邻接列表,适用于无权图或简单连接;2. 采用面向对象方法,通过定义Node类和Edge类,灵活添加属性,适合复杂关系建模;3. 利用NetworkX库,提供丰富图算法和动态属性支持,适用于大多数通用场景。每种方式各有适用场景,简单性、功能性、性能需权衡选择。

在Python中实现图结构,核心在于如何表示节点(Vertex)和边(Edge)以及它们之间的连接关系。对于复杂的关系建模,我们通常会超越简单的邻接列表,转向更具表现力的对象模型或利用强大的图处理库。这不仅关乎数据存储,更在于如何有效地附加和管理节点与边的属性,从而捕捉现实世界中那些细微而重要的联系。

解决方案
实现图结构,Python提供了多种途径,每种都有其适用场景。
最基础的,我们可以用字典(Dictionary)来模拟邻接列表。字典的键是节点,值是其直接邻居的列表。例如:graph = {'A': ['B', 'C'], 'B': ['A', 'D'], 'C': ['A'], 'D': ['B']}。这种方式直观且易于实现,对于无权图或只有简单连接的图来说,效率也不错。但一旦涉及到节点或边的属性(比如边的权重、关系的类型,或者节点的年龄、角色等),这种纯字典的表示就开始显得捉襟见肘了。

为了处理更复杂的场景,尤其是当节点和边本身带有丰富信息时,面向对象(Object-Oriented)的方法就显得非常有优势。我们可以定义Node类和Edge类,它们各自可以拥有多个属性。Node实例代表图中的实体,Edge实例则表示实体间的特定关系。Graph类则负责管理这些节点和边,提供添加、删除、查找等操作。这种方式的优点是结构清晰,易于扩展,能很好地映射现实世界的复杂实体和关系。不过,它需要你手动实现图的基本操作,比如遍历算法等,这会增加一些开发成本。
而对于大多数实际的复杂关系建模任务,我个人倾向于直接使用NetworkX这样的专业图处理库。NetworkX是Python中一个非常成熟且功能强大的库,它提供了丰富的图数据结构(无向图、有向图、多图等)和大量的图算法。它允许你轻松地为节点和边添加任意数量的属性,无论是字符串、数字、列表还是字典,都能自然地存储。例如,你可以定义一个社交网络图,节点可以是用户,边是他们之间的“朋友”关系,而用户节点可以有“年龄”、“城市”等属性,朋友关系边可以有“认识时间”、“亲密度”等属性。NetworkX在处理这些复杂属性方面表现得非常出色,同时还内置了许多高级算法,比如最短路径、中心性分析、社区检测等,极大地简化了开发工作。说实话,除非是对性能有极致要求,或者项目规模非常小,否则NetworkX几乎是我的首选。

如何选择合适的图表示方法?
选择图的表示方法,说白了,就是要在简单性、功能性、性能之间找到一个平衡点。这真的不是一个“一刀切”的问题,很大程度上取决于你具体的需求和图的特性。
如果你的图非常小,节点和边都没有任何额外属性,仅仅是表示简单的连接关系,比如一个简单的任务依赖图,那么用Python的内置字典实现邻接列表无疑是最快最直接的。它易于理解和实现,对于稀疏图(边相对节点数量很少)来说,空间效率也挺好。但一旦图变得稍微大一点,或者你需要查询特定边的属性,比如“这条边代表的交通线路有多长?”,那字典结构就会开始变得笨拙,你可能需要用嵌套字典或者元组来模拟属性,代码可读性会下降。
当你的节点或边需要承载大量信息,或者关系本身有多种类型和属性时,比如构建一个知识图谱,每个节点代表一个概念,每条边代表一种语义关系,并且这些概念和关系都有各自的描述性属性,这时候,面向对象的自定义类结构就显得很有必要了。你可以清晰地定义Person、Company等节点类,以及WorksFor、Manages等边类,每个类内部都可以有丰富的属性字段。这种方式虽然前期投入的编码量会大一些,但后期维护和扩展性极佳,代码逻辑也更符合人类的直觉。而且,如果你需要实现一些非常定制化的图操作或算法,自己控制底层数据结构会给你更大的灵活性。
而对于绝大多数通用场景,特别是当你需要用到复杂的图算法(比如查找最短路径、计算节点重要性、检测社区结构等),或者你的图数据量比较大,需要高效地进行增删改查操作时,我个人觉得,NetworkX几乎是无可替代的选择。它在底层已经为你优化好了数据存储和算法实现,你只需要关注业务逻辑。它能轻松处理节点和边的属性,并且提供了直观的API来访问和操作这些属性。比如,如果你想找一个社交网络里最活跃的用户(高中心性),或者找出哪些用户形成了紧密的兴趣小组(社区检测),NetworkX都能提供开箱即用的解决方案。它帮你省去了大量重复造轮子的时间,让你能更专注于从图数据中挖掘价值。当然,引入一个外部库意味着一个额外的依赖,但对于图这种复杂的数据结构来说,这通常是值得的。
在复杂关系建模中,如何为节点和边添加属性?
在处理复杂关系时,仅仅知道“A和B有连接”是远远不够的。我们通常需要知道“A和B是朋友关系,他们认识了5年”,或者“A和B之间有一条销售订单,金额是1000元,发生于2023年”。这些附加信息就是节点和边的属性,它们是实现复杂关系建模的关键。
使用自定义的面向对象模型时,为节点和边添加属性是最自然的方式。你可以直接在Node类和Edge类的构造函数中定义所需的属性字段。
class Node:
    def __init__(self, id, name, type):
        self.id = id
        self.name = name
        self.type = type # e.g., "Person", "Product", "Location"
        self.properties = {} # 用于存储额外、非核心的属性

    def add_property(self, key, value):
        self.properties[key] = value

class Edge:
    def __init__(self, source_node, target_node, relation_type):
        self.source = source_node
        self.target = target_node
        self.relation_type = relation_type # e.g., "FRIEND_OF", "PURCHASED", "LOCATED_IN"
        self.properties = {} # 用于存储边的额外属性,如权重、时间戳

    def add_property(self, key, value):
        self.properties[key] = value

# 示例
alice = Node("p001", "Alice", "Person")
alice.add_property("age", 30)
alice.add_property("city", "New York")

iphone = Node("pr001", "iPhone 15", "Product")
iphone.add_property("price", 999)

purchase_edge = Edge(alice, iphone, "PURCHASED")
purchase_edge.add_property("quantity", 1)
purchase_edge.add_property("date", "2023-11-20")

# 你可以把这些节点和边实例存储在一个Graph类中
这种方式的优点在于高度定制化,你可以根据业务需求精确定义每个属性的类型和含义。
而当我使用NetworkX时,为节点和边添加属性简直是小菜一碟,而且非常灵活。NetworkX允许你在添加节点和边时直接传入任意数量的关键字参数,这些参数会自动作为属性存储起来。
import networkx as nx

G = nx.Graph() # 或者 nx.DiGraph() 用于有向图

# 添加节点并赋予属性
G.add_node("Alice", age=30, city="New York", occupation="Engineer")
G.add_node("Bob", age=32, city="San Francisco", occupation="Designer")
G.add_node("ProjectX", status="Active", deadline="2024-06-30")

# 添加边并赋予属性
G.add_edge("Alice", "Bob", relationship="friend", duration_years=5, common_interest="hiking")
G.add_edge("Alice", "ProjectX", role="Lead Developer", start_date="2023-01-15")
G.add_edge("Bob", "ProjectX", role="UI/UX Designer", start_date="2023-02-01")

# 访问节点和边的属性
print(G.nodes["Alice"]["age"]) # 输出: 30
print(G.edges["Alice", "Bob"]["relationship"]) # 输出: friend
print(G.edges["Alice", "ProjectX"]["role"]) # 输出: Lead Developer

# 也可以在添加之后修改或新增属性
G.nodes["Alice"]["status"] = "Active"
G.edges["Alice", "Bob"]["last_met"] = "2023-11-01"

# 遍历节点和边的属性
for node, data in G.nodes(data=True):
    print(f"Node: {node}, Properties: {data}")

for u, v, data in G.edges(data=True):
    print(f"Edge: ({u}, {v}), Properties: {data}")
NetworkX这种键值对的属性存储方式,让我觉得非常方便和直观。它不需要你预先定义所有可能的属性字段,可以随时动态添加,这在探索性数据分析和快速原型开发中尤其有用。这些属性不仅可以用于存储信息,更重要的是,它们可以作为图算法的输入,比如在最短路径算法中,边的“权重”属性就至关重要;在社区检测中,节点的“类型”属性可能影响分组结果。
图遍历和算法在复杂关系分析中的应用?
一旦我们用Python构建好了包含丰富属性的图结构,真正的价值就体现在如何利用图遍历和各种图算法来深入分析这些复杂关系。这不仅仅是数据存储,更是数据洞察的利器。
图遍历是探索图结构最基础也是最核心的操作。最常见的两种是广度优先搜索(BFS)和深度优先搜索(DFS)。
- 广度优先搜索(BFS):想象一下从一个点开始,一层一层向外“扩散”寻找邻居。它非常适合用来找出最短路径(在无权图中),或者查找一个节点在多少“跳”之内可以到达的范围。比如,在社交网络中,你想找出“我的朋友的朋友”是谁,或者在一个物流网络中,找到从A地到B地的最少中转次数的路线,BFS就是首选。
- 深度优先搜索(DFS):它会沿着一条路径尽可能深地探索,直到无路可走才回溯。DFS常用于检测图的连通性、寻找环路、拓扑排序等。例如,在一个任务依赖图中,你可以用DFS来检查是否存在循环依赖,或者确定任务的执行顺序。在我处理一些复杂的系统依赖关系时,DFS帮我理清了哪些模块是真正独立的,哪些是相互耦合的。
而图算法则是在遍历的基础上,提供更高级、更复杂的分析能力,它们能回答关于图结构和其中关系更深层次的问题:
- *最短路径算法(如Dijkstra、A)**:当边带有权重(例如,距离、成本、时间)时,这些算法能找出两点之间权重总和最小的路径。这在物流优化、网络路由、甚至是知识图谱中的推理路径查找都至关重要。我曾经用Dijkstra算法来优化一个仓库的拣货路径,显著提升了效率。
- 中心性度量(Degree Centrality, Betweenness Centrality, Closeness Centrality, Eigenvector Centrality):这些算法用于识别图中“重要”的节点。
- 度中心性:连接数最多的节点,通常代表影响力广或活跃度高。
- 中介中心性:位于许多最短路径上的节点,代表控制信息流的关键节点。
- 接近中心性:到所有其他节点平均距离最短的节点,代表能快速影响整个网络的节点。
- 特征向量中心性:连接到许多重要节点的节点,代表真正有影响力的节点。 在分析社交网络或组织架构时,这些中心性指标能帮我找出关键人物、信息枢纽或潜在的瓶颈。
- 社区检测算法(如Louvain、Girvan-Newman):这些算法旨在识别图中紧密连接的节点群,即“社区”或“聚类”。这在客户细分、生物网络分析、社交圈子识别等方面非常有用。我发现它们在分析用户行为模式、发现隐藏的用户群体方面效果非常好。
- 连通分量(Connected Components):用于识别图中的独立子图,即那些相互之间没有路径连接的节点集合。这可以帮助我们理解一个系统是否是单一整体,或者由多个隔离的部分组成。
总的来说,图遍历和算法不仅仅是理论概念,它们是解决现实世界中复杂关系问题的强大工具。它们能从看似杂乱无章的连接中提取出结构、模式和关键信息,从而支持决策、优化流程或发现新的洞察。在我看来,掌握这些工具,是真正将图结构应用于实际的必经之路。
本篇关于《Python图结构实现与关系建模详解》的介绍就到此结束啦,但是学无止境,想要了解学习更多关于文章的相关知识,请关注golang学习网公众号!
 台式机没WiFi?4个实用连接方法
- 上一篇
- 台式机没WiFi?4个实用连接方法
- 下一篇
- sessionStorage用途与适用场景详解
-
- 文章 · python教程 | 4小时前 |
- Python Path.replace 覆盖目标文件时怎样处理平台差异
- 415浏览 收藏
-
- 文章 · python教程 | 4小时前 | Python教程 · 进程管理 · Python subprocess Popen 进程超时 TimeoutExpired communicate
- Python subprocess 超时后怎样终止并读取输出
- 457浏览 收藏
-
- 文章 · python教程 | 4小时前 |
- Python 怎样读取 TOML 配置并处理二进制文件
- 202浏览 收藏
-
- 文章 · python教程 | 4小时前 |
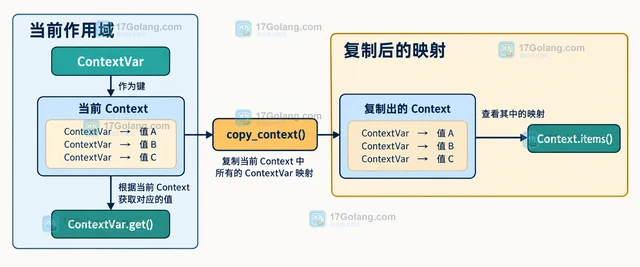
- Python contextvars.Context 怎样复制上下文后运行回调
- 143浏览 收藏
-
- 文章 · python教程 | 4小时前 |
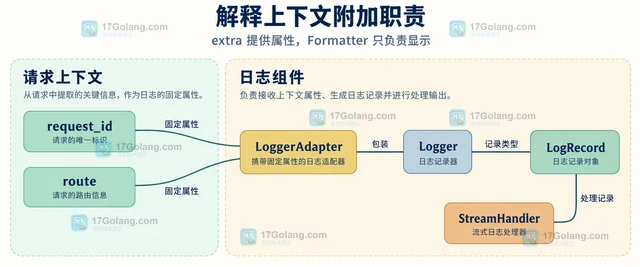
- Python 日志怎样给每条记录附加请求上下文
- 364浏览 收藏
-
- 文章 · python教程 | 4小时前 | python ·
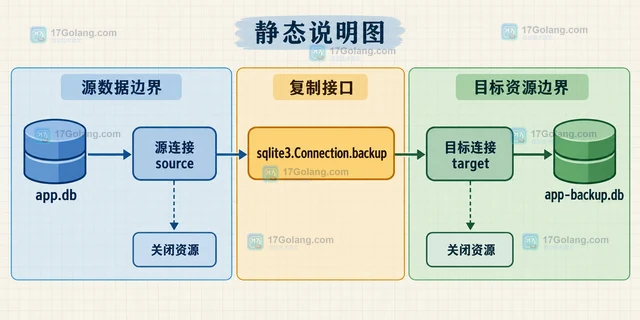
- Python sqlite3 怎样在线备份数据库
- 355浏览 收藏
-
- 文章 · python教程 | 4小时前 |
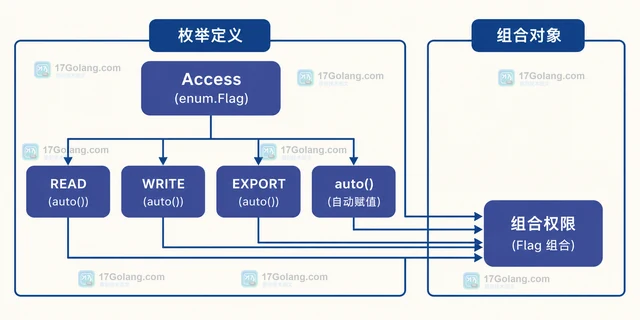
- Python enum.Flag 怎样组合权限标记并判断成员
- 167浏览 收藏
-
- 文章 · python教程 | 4小时前 |
- Python sqlite3 怎么查看连接当前的 SQL 长度上限
- 323浏览 收藏
-
- 文章 · python教程 | 4小时前 |
- Python 装饰器怎样保留原函数参数类型
- 309浏览 收藏
-
- 文章 · python教程 | 5小时前 |
- Python asyncio 怎样把阻塞函数放到线程执行
- 395浏览 收藏
-
- 文章 · python教程 | 5小时前 |
- Python asyncio 怎样用绝对时间设置超时
- 256浏览 收藏
-
- 文章 · python教程 | 5小时前 | python · Python 共享内存 multiprocessing.shared_memory close UNLINK SharedMemory
- Python SharedMemory 的 close 和 unlink 有什么区别
- 319浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 513次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 572次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 598次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 549次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 366次使用
-
- Python sqlite3 Connection serialize 怎么导出数据库快照:备份窗口、内存占用与恢复校验
- 2026-08-26 501浏览
-
- Python监控网页状态:requests异常处理实战
- 2026-05-29 501浏览
-
- TensorFlow模型部署为API的TF Serving方法
- 2026-05-26 501浏览
-
- Python字符串编码转换:encode与decode详解
- 2026-05-16 501浏览
-
- TensorFlow裁剪无用算子方法详解
- 2026-05-15 501浏览