
Hibernate@ElementCollection@Where高效过滤方法
本文深入探讨了 Hibernate 中利用 `@ElementCollection` 和 `@Where` 注解实现高效数据过滤的技巧,尤其针对集合类型字段的场景。文章通过两个实用示例,清晰地展示了如何根据特定条件(如“主电话号码”或“队伍归属”)筛选集合元素,避免在业务逻辑中手动处理数据,从而提升代码可读性和性能。重点讲解了 `@ElementCollection`、`@CollectionTable` 和 `@Where` 注解的联合使用,并强调了 `@Where` 注解在过滤集合元素中的关键作用。无论是处理一对多关系中子对象的条件加载,还是将同一张表中的数据映射到不同的集合属性,本文提供的技巧都极具参考价值,助力开发者更好地运用 Hibernate 进行对象关系映射。
使用 Hibernate @ElementCollection 和 @Where 注解实现数据过滤
在使用 Hibernate 进行实体映射时,经常会遇到需要对集合类型的字段进行过滤的情况。例如,一个用户可能有多个电话号码,但我们只想加载其中标记为“主电话”的号码。
Hibernate 提供了 @ElementCollection 和 @Where 注解,可以非常方便地实现这种需求。本文将通过一个简单的示例来说明如何结合这两个注解来实现集合字段的数据过滤。
示例场景
假设我们有一个 User 实体,每个用户可以拥有多个电话号码(PhoneNumber),但我们在某些情况下只需要加载用户的主电话号码。
实体定义
import javax.persistence.*;
import java.util.Set;
@Entity
public class User {
@Id
@GeneratedValue(strategy = GenerationType.IDENTITY)
private Long id;
private String name;
// 使用 @ElementCollection 映射嵌套集合
@ElementCollection
@CollectionTable(name = "phone_number", joinColumns = @JoinColumn(name = "user_id"))
@Where(clause = "is_primary = true") // 只加载主电话号码
private Set primaryPhones;
// Getter 和 Setter
public Long getId() {
return id;
}
public void setId(Long id) {
this.id = id;
}
public String getName() {
return name;
}
public void setName(String name) {
this.name = name;
}
public Set getPrimaryPhones() {
return primaryPhones;
}
public void setPrimaryPhones(Set primaryPhones) {
this.primaryPhones = primaryPhones;
}
}
对应的值类型 PhoneNumber:
import javax.persistence.Embeddable;
@Embeddable
public class PhoneNumber {
private String number;
private boolean isPrimary;
// Getter 和 Setter
public String getNumber() {
return number;
}
public void setNumber(String number) {
this.number = number;
}
public boolean isPrimary() {
return isPrimary;
}
public void setPrimary(boolean primary) {
isPrimary = primary;
}
}
关键点说明
@ElementCollection:用于映射嵌入式对象的集合,适用于不需要独立生命周期的对象。@CollectionTable:指定集合所存储的数据库表名以及关联的外键列。@Where:Hibernates 的扩展注解,允许我们指定 SQL 片段来过滤集合中的元素。- 在上面的例子中,我们通过
@Where(clause = "is_primary = true") 来确保只加载主电话号码。
查询效果
当我们执行如下查询:
User user = entityManager.find(User.class, userId);
System.out.println(user.getPrimaryPhones());
Hibernate 将生成类似如下的 SQL 查询(具体取决于数据库方言):
SELECT * FROM phone_number WHERE user_id = ? AND is_primary = true;
这确保了只有符合条件的记录会被加载到 primaryPhones 集合中。
总结
通过结合使用 @ElementCollection 和 @Where 注解,我们可以非常灵活地对集合类型的字段进行数据过滤,避免在业务逻辑中手动筛选数据,提高代码的可读性和性能。这种方式特别适合处理一对多关系中子对象的条件加载场景。
" />
本文介绍了如何在Hibernate中使用 @ElementCollection 和 @Where 注解,根据特定条件过滤集合元素,将同一张表中的数据分别映射到不同的集合属性中。通过一个游戏实体类的例子,详细讲解了如何根据队伍(team)的不同,将玩家ID分别存储到 homePlayerIds 和 awayPlayerIds 集合中。
在使用 Hibernate 进行对象关系映射时,有时需要将同一张表中的数据根据不同的条件映射到不同的集合属性中。例如,在一个游戏中,玩家数据存储在 game_player_team 表中,我们需要将属于主队的玩家ID存储到 homePlayerIds 集合中,将属于客队的玩家ID存储到 awayPlayerIds 集合中。这时,可以结合使用 @ElementCollection 和 @Where 注解来实现这一目标。
示例:游戏实体类
假设我们有如下的 game_player_team 表:
CREATE TABLE game_player_team (
game_id INT,
player_id INT,
team VARCHAR(1)
);
INSERT INTO game_player_team (game_id, player_id, team) VALUES
(1, 1, 'H'),
(1, 2, 'H'),
(1, 3, 'A'),
(1, 4, 'A');
现在,我们创建一个 Game 实体类,其中包含 homePlayerIds 和 awayPlayerIds 两个集合属性,分别存储主队和客队的玩家ID。
import jakarta.persistence.*;
import org.hibernate.annotations.Where;
import java.util.List;
@Entity
class Game {
@Id
public Long id;
// 映射主队玩家列表,筛选条件为 team = 'H'
@ElementCollection
@CollectionTable(name="game_player_team", joinColumns={@JoinColumn(name="game_id")})
@Column(name="player_id")
@Where(clause = "team = 'H'")
public List homePlayerIds;
// 映射客队玩家列表,筛选条件为 team = 'A'
@ElementCollection
@CollectionTable(name="game_player_team", joinColumns={@JoinColumn(name="game_id")})
@Column(name="player_id")
@Where(clause = "team = 'A'")
public List awayPlayerIds;
}
// Player 类作为嵌入类型,用于封装 player_id 和 team 字段
@Embeddable
class Player {
@Column(name = "player_id")
public Long playerId;
public String team;
public Player() {
}
public Player(Long playerId, String team) {
this.playerId = playerId;
this.team = team;
}
}
代码解释:
@ElementCollection:用于指定这是一个元素集合(即非实体类的集合)。@CollectionTable:用于指定集合元素所对应的数据库表,joinColumns 指定了关联的外键列(这里是 game_id)。@Column(name="player_id"):指定了集合中每个元素映射到的数据库字段名。@Where(clause = "team = 'H'"):这是关键部分。该注解用于添加 SQL WHERE 子句,从而过滤集合元素。team = 'H' 表示只选择 team 列值为 'H' 的记录,并将其映射到 homePlayerIds 集合中;同理,team = 'A' 只选择 team 值为 'A' 的记录并映射到 awayPlayerIds 中。
注意事项:
@Where 注解直接作用于 @ElementCollection 标注的集合属性上。@Where 注解的 clause 属性指定了 SQL WHERE 子句,用于过滤数据。- 需要导入
org.hibernate.annotations.Where 包。 - 示例中使用了
@Embeddable 注解,将 player_id 和 team 封装到 Player 类中,保证了 @Where 注解可以生效。
总结
通过结合使用 @ElementCollection 和 @Where 注解,我们可以方便地根据特定条件从同一张表中过滤数据,并将过滤后的数据映射到不同的集合属性中。这种方法可以简化数据访问逻辑,提高代码的可读性和可维护性。在实际应用中,可以根据具体的需求调整 WHERE 子句,实现更复杂的过滤逻辑。
文中关于的知识介绍,希望对你的学习有所帮助!若是受益匪浅,那就动动鼠标收藏这篇《Hibernate@ElementCollection@Where高效过滤方法》文章吧,也可关注golang学习网公众号了解相关技术文章。
 Golang微服务重试与熔断实现方法
- 上一篇
- Golang微服务重试与熔断实现方法

- 下一篇
- Golang责任链模式中间件怎么实现
-
- 文章 · java教程 | 35分钟前 |
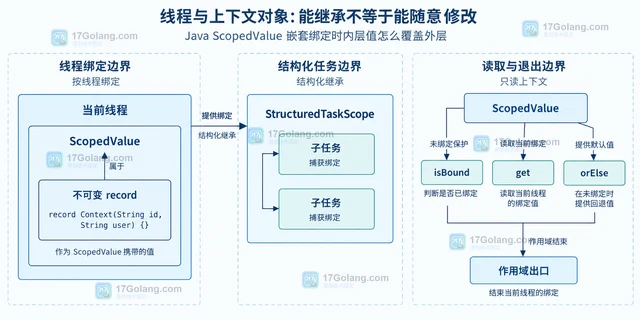
- Java ScopedValue 嵌套绑定时内层值怎么覆盖外层
- 104浏览 收藏
-
- 文章 · java教程 | 5小时前 | Java · 并发编程 · 虚拟线程 · Java虚拟线程 ForkJoinPool Virtual Threads 调度器并行度 jdk.virtualThreadScheduler.parallelism
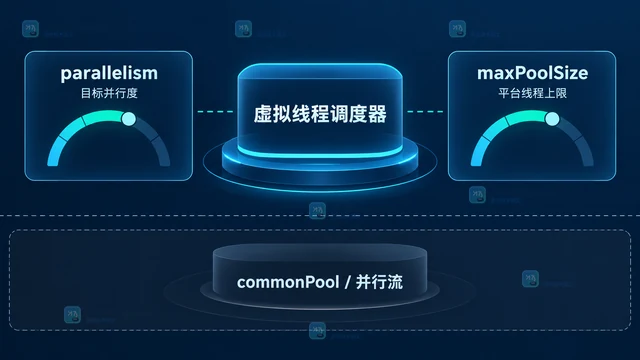
- Java 虚拟线程调度器并行度怎么单独配置
- 459浏览 收藏
-
- 文章 · java教程 | 8小时前 | 并发 · Java · 虚拟线程 · java 超时 结构化并发 StructuredTaskScope
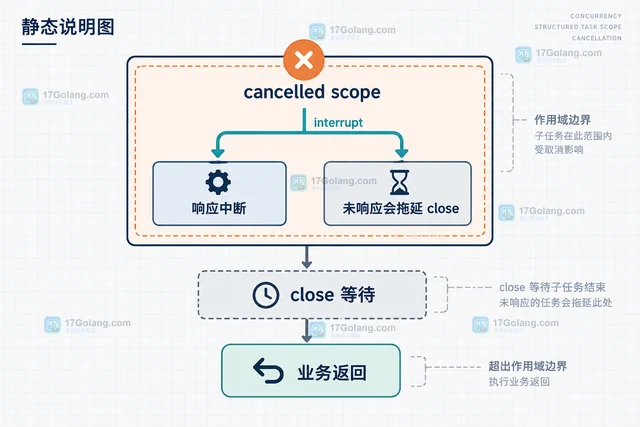
- Java StructuredTaskScope 怎么设置整体截止时间
- 118浏览 收藏
-
- 文章 · java教程 | 14小时前 | Java · java instanceof Primitive Patterns 窄化转换
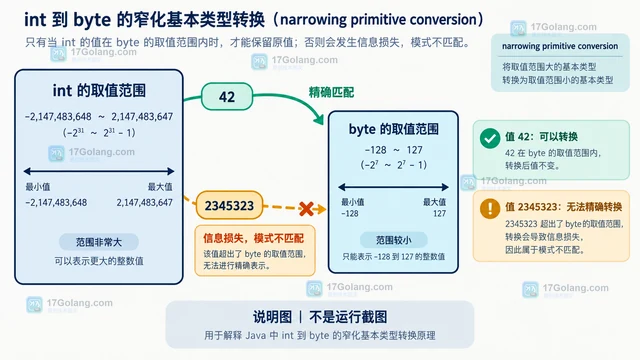
- Java Primitive Patterns 怎么处理数值窄化失败
- 389浏览 收藏
-
- 文章 · java教程 | 16小时前 |
- Java Stable Values 怎么替代双重检查锁
- 155浏览 收藏
-
- 文章 · java教程 | 19小时前 |
- Java Vector API 怎么用 Mask 处理尾部元素
- 358浏览 收藏
-
- 文章 · java教程 | 21小时前 | Java · JVM · java Hotspot Compact Object Headers JEP 519
- Java Compact Object Headers 会怎样改变对象布局
- 293浏览 收藏
-
- 文章 · java教程 | 1天前 | Java教程 · java Linker API Foreign Function and Memory API
- Java Linker API 怎么调用简单本地函数
- 486浏览 收藏
-
- 文章 · java教程 | 1天前 | Java · java 模块系统 JDK 25 import module Module Import Declaration
- Java Module Import Declaration 会改变哪些导入规则
- 299浏览 收藏
-
- 文章 · java教程 | 1天前 | Java · java Event Flight Recorder JFR
- Java 自定义 JFR Event 怎么控制提交条件
- 325浏览 收藏
-
- 文章 · java教程 | 1天前 | Java ·
- Java ClassValue 怎么避免类加载器泄漏
- 464浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 343次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 403次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 400次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 361次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 183次使用
-
- Java try-with-resources 多个资源关闭顺序是什么
- 2026-09-10 501浏览
-
- 矩阵主副对角线快速定位技巧
- 2026-05-31 501浏览
-
- Java多态优化流程代码与行为分发改进
- 2026-05-26 501浏览
-
- JVM 类元数据双亲委派链表深度解析
- 2026-05-21 501浏览
-
- 反射异常处理:InvocationTargetException解析与应用
- 2026-05-16 501浏览


