
关于 MySQL 百万数据量的 count(*) 查询如何优化?
小伙伴们对数据库编程感兴趣吗?是否正在学习相关知识点?如果是,那么本文《关于 MySQL 百万数据量的 count(*) 查询如何优化?》,就很适合你,本篇文章讲解的知识点主要包括MySQL、数据结构、算法、架构。在之后的文章中也会多多分享相关知识点,希望对大家的知识积累有所帮助!
明确需求
对这个问题有兴趣是源于一次开发中遇到要统计人数的需求。类似于“得到”专栏的订阅数。
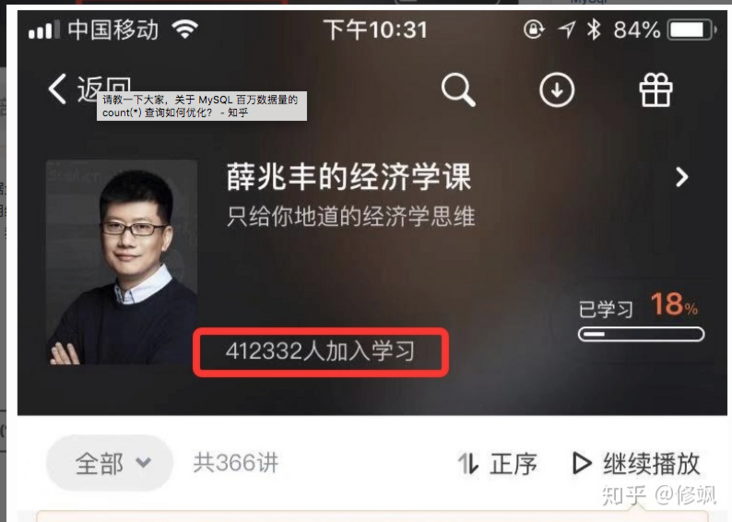
但是我的数据量比这个大很多,而对数据的准确性要求就不那么高。所以首先要明确需求。其他答案有的说了用缓存,有的答案对比了count(*)、count(1)的区别,都很好,但是我认为还是要看一下题主的场景。我根据我实际开发的经验总结如下几个方面,FYI。
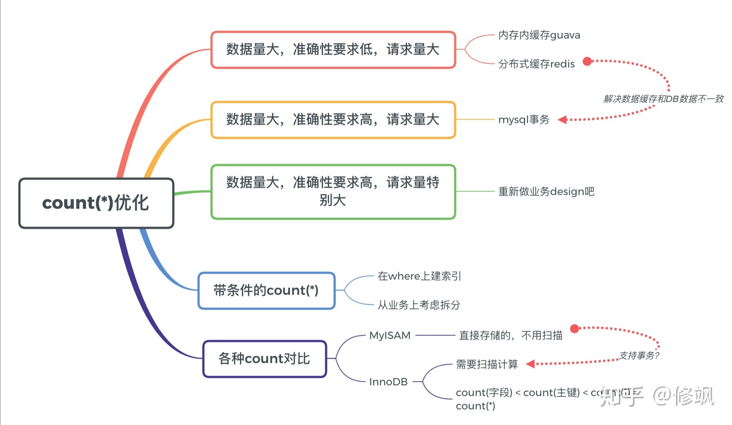
数据量大/准确性要求低/请求量大
- 这种场景一般是C端产品,比如上面说的得到APP的订阅数目,如果对一致性要求不高,可以直接在内存中使用缓存,用guava在内存中做一个缓存定时刷新即可,百万量级count(*)有缓存的频率还不至于有啥性能问题;
- 但是内存内缓存有一个问题就是不同服务器之间的缓存数量是不一致的,可以考虑用redis作为计数,一般这种场景是大多数同学遇到的,简单粗暴搞定即可;
- 用show table status。这个建议还是不要用了,翻了下mysql 的doc,40%的误差概率,碰上就有点大了呀。
TABLE_ROWS
The number of rows. Some storage engines, such as MyISAM, store the exact count. For other storage engines, such as InnoDB, this value is an approximation, and may vary from the actual value by as much as 40% to 50%. In such cases, use SELECT COUNT(*) to obtain an accurate count.
数据量大/准确性要求高/请求量一般
这种场景一般出现在账务上,比如有多少人打款。而且估计DAU在亿级别的公司可能才会遇到。这里最关键的问题还是一致性的要求。在并发系统中,看看我们用redis,我们看看会出现什么样的一致性问题:
时间       A processor         B processor
T1         插入数据
T2                             1.redis#get计数器;2. 查询最新的N条数据
T3         redis#incr
在T2的时间点的时候会出现数据不一致,B看到的是数据已经更新,但是数据库还没更新。我们就在想,如果放到一个事务里面,就可以完美解决这个问题了呀。由于事务,innoDB不支持像MyISAM准确计数,解铃还须系铃人,所以我们建一个计数表(count_table)+事务,解这个问题了。
时间         会话A                            会话B
T1         begin;
           在计数表中插入一条数据;
T2                                          begin;
                                            1. 读count_table;
                                            2. 查询最新的N条数据
                                            commit;
T3         更新conut_table;
           commit;
在T1的时候,如果采用Mysql默认的事务隔离级别:读提交。因为T1事务还没有提交,所以插入的数据,B是读不到的,所以从逻辑上来说是一致的。
数据量大/准确性要求高/请求量特别高
抱歉,没遇到过。如果你觉得你遇到了,你的架构需要你重新design and review,相信我。
带条件count(*)
很多时候我们的业务场景不是数据量多,而是条件复杂。这其实就是一个查询优化的问题了,和是不是count(*)没有关系,那么有以下两招常用,这个得具体问题具体分析了。比如时间维度可以加一个索引来优化;
select * from table_name where a = x and b = x;
- 加索引
- 业务拆分
count性能比较
- count(primary key)。遍历整个表,把主键值拿出来,累加;
- count(1)。遍历整个表,但是不取值,累加;
- count(非空字段)。遍历整个表,读出这个字段,累加;
- count(可以为空的字段)。遍历整个表,读出这个字段,判断不为null累加;
- count(*)。遍历整个表,做了优化,不取值,累加。
结合mysql的一些索引查询知识,我们可以大致得出如下结论。
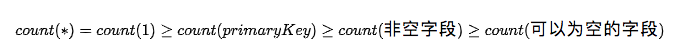
建议直接使用count(*)。
今天关于《关于 MySQL 百万数据量的 count(*) 查询如何优化?》的内容介绍就到此结束,如果有什么疑问或者建议,可以在golang学习网公众号下多多回复交流;文中若有不正之处,也希望回复留言以告知!
 OA软件之工作日志,助你及时修正工作偏差
- 上一篇
- OA软件之工作日志,助你及时修正工作偏差
- 下一篇
- 【巨杉数据库Sequoiadb】sdb backupOffline 相关问题
-
- 笑点低的花瓣
- 赞 ??,一直没懂这个问题,但其实工作中常常有遇到...不过今天到这,帮助很大,总算是懂了,感谢作者大大分享技术文章!
- 2023-03-31 07:43:54
-
- 活力的手机
- 这篇技术文章真及时,太全面了,真优秀,已收藏,关注楼主了!希望楼主能多写数据库相关的文章。
- 2023-03-25 14:01:18
-
- 复杂的店员
- 写的不错,一直没懂这个问题,但其实工作中常常有遇到...不过今天到这,看完之后很有帮助,总算是懂了,感谢作者大大分享文章内容!
- 2023-02-21 23:51:00
-
- 专注的大碗
- 这篇技术贴真及时,太全面了,很棒,码住,关注作者了!希望作者能多写数据库相关的文章。
- 2023-02-20 05:38:08
-
- 数据库 · MySQL | 1小时前 | MySQL · JSON · 性能优化 · mysql 部分更新 JSON_SET JSON_STORAGE_FREE
- MySQL JSON 部分更新什么时候真的生效
- 132浏览 收藏
-
- 数据库 · MySQL | 1小时前 | mysql 存储过程 错误信息 RESIGNAL GET STACKED DIAGNOSTICS
- MySQL RESIGNAL 怎样在存储程序中保留原始错误信息
- 280浏览 收藏
-
- 数据库 · MySQL | 1小时前 | MySQL · InnoDB · 数据库运维 · mysql Threads 锁等待 data_locks performance_schema data_lock_waits INNODB_TRX 阻塞事务
- MySQL 锁等待超时怎样从 performance_schema 找阻塞者
- 458浏览 收藏
-
- 数据库 · MySQL | 1小时前 |
- MySQL SIGNAL 怎样在存储程序中定义自定义异常
- 132浏览 收藏
-
- 数据库 · MySQL | 1小时前 | mysql optimizer hint 连接顺序 JOIN_ORDER JOIN_PREFIX
- MySQL optimizer hint 怎样限定连接顺序
- 403浏览 收藏
-
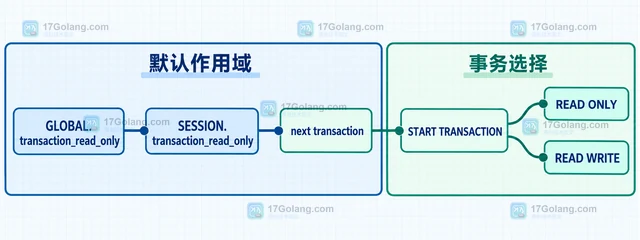
- 数据库 · MySQL | 1小时前 | MySQL · 事务 · 故障排查 · mysql transaction_read_only INNODB_TRX START TRANSACTION SET TRANSACTION
- MySQL 事务只读模式怎样判断当前连接能否写入
- 102浏览 收藏
-
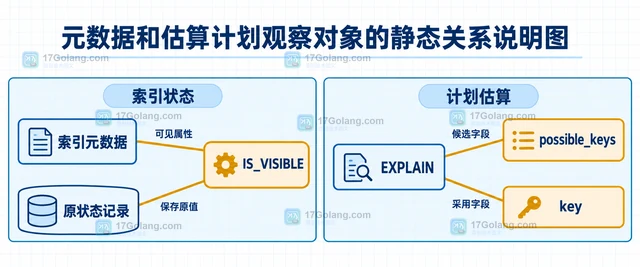
- 数据库 · MySQL | 1小时前 | mysql visible 不可见索引 SET_VAR optimizer_switch
- MySQL 不可见索引怎样临时恢复可见性
- 124浏览 收藏
-
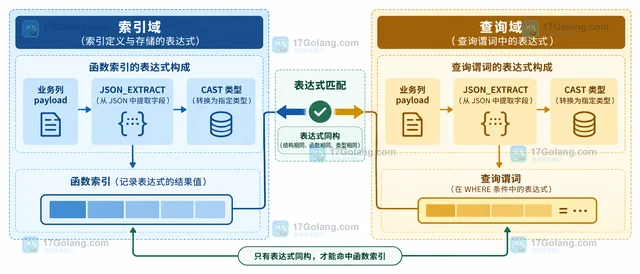
- 数据库 · MySQL | 1小时前 |
- MySQL JSON_TABLE 怎样展开嵌套数组又保留没有子项的行
- 231浏览 收藏
-
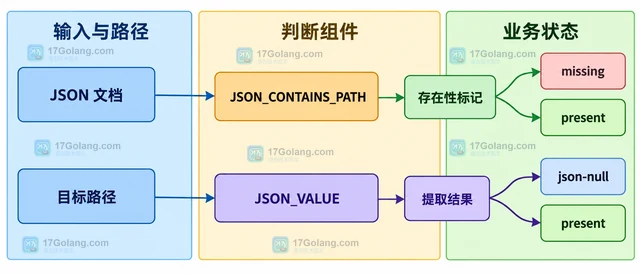
- 数据库 · MySQL | 1小时前 |
- MySQL JSON_VALUE 怎样区分路径不存在和 JSON 空值
- 488浏览 收藏
-
- 数据库 · MySQL | 2小时前 |
- MySQL GROUP BY WITH ROLLUP 识别小计与总计行的判断方法
- 483浏览 收藏
-
- 数据库 · MySQL | 2小时前 |
- MySQL CTE 怎样判断是否应该物化
- 315浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 570次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 614次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 641次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 601次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 419次使用
-
- MySQL 明明加了索引,为什么查询还是很慢?先查这 6 个点
- 2026-06-27 374浏览
-
- golang MySQL实现对数据库表存储获取操作示例
- 2022-12-22 499浏览
-
- Golang迭代如何在Go中循环数据结构使用详解
- 2022-12-22 148浏览
-
- 详解如何在Go语言中循环数据结构
- 2022-12-22 406浏览
-
- goHTTP2的头部压缩算法hpack实现详解
- 2022-12-22 398浏览


