
Linuxstrings输出格式自定义技巧
本文介绍了Linux系统中strings命令输出格式的自定义方法。strings命令用于提取二进制文件中的可打印字符串,但其默认输出格式固定。文章提供了多种自定义输出格式的方案,包括使用awk、sed、perl等文本处理工具,以及编写Python脚本进行更复杂的处理,最终实现将字符串及其偏移量以制表符或其他自定义格式输出,满足不同用户的个性化需求,提升使用效率。 选择哪种方法取决于具体的格式化需求和个人偏好。
strings 命令用于从二进制文件中提取可打印的字符串。默认情况下,strings 命令的输出格式是固定的,即每行显示一个字符串,前面带有其在文件中的字节偏移量。
虽然 strings 命令本身不提供直接的自定义输出格式选项,但你可以通过其他工具或脚本来处理 strings 的输出,以实现自定义格式。以下是一些常见的方法:
使用 awk 或 sed
你可以使用 awk 或 sed 等文本处理工具来格式化 strings 的输出。例如,假设你想将每行的偏移量和字符串用制表符分隔,可以使用以下命令:
strings your_binary_file | awk '{print $1 "\t" $0}'
或者使用 sed:
strings your_binary_file | sed 's/^/ /; s/$/\t/'
使用 perl
perl 是一个强大的文本处理工具,可以用来实现更复杂的格式化需求。例如:
strings your_binary_file | perl -pe 's/^(\S+)\s+/\t$1\t/'
使用 Python 脚本
如果你需要更复杂的处理逻辑,可以编写一个简单的 Python 脚本来处理 strings 的输出。例如:
import subprocess

def custom_strings_format(binary_file):
    # 运行 strings 命令并捕获输出
    result = subprocess.run(['strings', binary_file], capture_output=True, text=True)
    lines = result.stdout.splitlines()

    # 处理每一行
    formatted_lines = []
    for line in lines:
        parts = line.split(maxsplit=1)
        if len(parts) == 2:
            offset, string = parts
            formatted_lines.append(f"{offset}\t{string}")

    # 输出格式化后的结果
    for line in formatted_lines:
        print(line)

# 使用示例
custom_strings_format('your_binary_file')
使用 xargs 和 printf
如果你想将偏移量和字符串用特定的格式输出,可以使用 xargs 和 printf:
strings your_binary_file | xargs -I {} printf "%s\t{}\n" {}
通过这些方法,你可以根据需要自定义 strings 命令的输出格式。选择哪种方法取决于你的具体需求和偏好。
文中关于的知识介绍,希望对你的学习有所帮助!若是受益匪浅,那就动动鼠标收藏这篇《Linuxstrings输出格式自定义技巧》文章吧,也可关注golang学习网公众号了解相关技术文章。
 copendir详解:遍历目录结构的终极指南
- 上一篇
- copendir详解:遍历目录结构的终极指南

- 下一篇
- Vite打包后私有变量赋值问题解决攻略
-
- 文章 · linux | 6小时前 |
- Linux lsof发现被删除但仍占用的日志文件
- 128浏览 收藏
-
- 文章 · linux | 6小时前 |
- Linux ss定位端口监听进程与连接状态的方法
- 308浏览 收藏
-
- 文章 · linux | 3天前 |
- Linux rsync保留权限与删除多余文件的迁移清单
- 403浏览 收藏
-
- 文章 · linux | 3天前 | Linux ·
- Linux find按文件大小和修改时间清理缓存的安全流程
- 293浏览 收藏
-
- 文章 · linux | 3天前 | Linux · Linux 日志轮转 logrotate postrotate
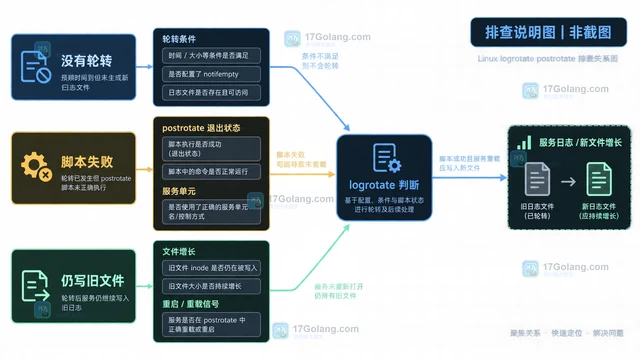
- Linux logrotate配合postrotate通知服务重开日志的配置
- 220浏览 收藏
-
- 文章 · linux | 3天前 | Linux · 运维排查 · Linux systemd journalctl 日志过滤
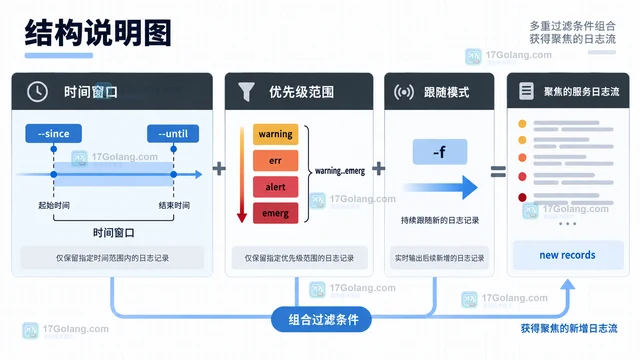
- Linux journalctl按服务与时间窗口过滤日志的命令组合
- 495浏览 收藏
-
- 文章 · linux | 3天前 | linux运维 · Linux systemd 启动顺序 network.target network-online.target
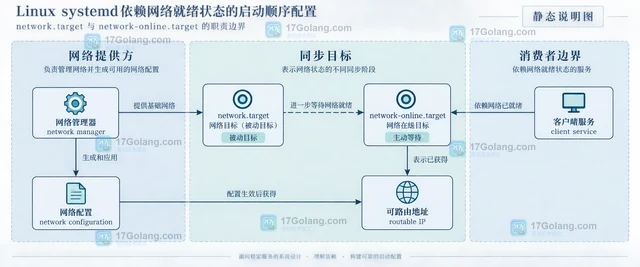
- Linux systemd依赖网络就绪状态的启动顺序配置
- 496浏览 收藏
-
- 文章 · linux | 3天前 | Linux · Linux 环境变量 systemd EnvironmentFile
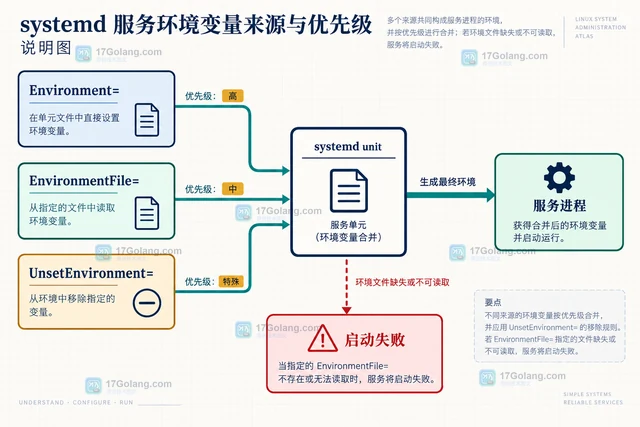
- Linux systemd用EnvironmentFile处理带空格值的配置方法
- 204浏览 收藏
-
- 文章 · linux | 3天前 | Linux · Linux tar strip-components GNU tar
- Linux tar用 strip-components 控制解包目录层级的实现方法
- 104浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 190次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 245次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 202次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 184次使用
-

- CMMLU
- 深入了解CMMLU中文评估基准,涵盖67个学科主题,提供数据集下载、Zero-shot/Five-shot评估方法及排行榜,助力优化中文语言模型性能。
- 175次使用
-
- Linux vmstat 如何分辨内存抖动与磁盘等待:si、so、wa 与复测顺序
- 2026-08-30 501浏览
-
- Linux搭建vsftpdFTP服务器教程
- 2026-04-30 501浏览
-
- Shell脚本安装教程:.sh一键安装指南
- 2026-03-16 501浏览
-
- Linux清空文件内容的几种方法
- 2025-12-01 501浏览
-
- Linux命令行下载文件技巧
- 2025-11-23 501浏览


