
Mariadb学习总结(八):聚合函数及分组查询
今天golang学习网给大家带来了《Mariadb学习总结(八):聚合函数及分组查询》,其中涉及到的知识点包括等等,无论你是小白还是老手,都适合看一看哦~有好的建议也欢迎大家在评论留言,若是看完有所收获,也希望大家能多多点赞支持呀!一起加油学习~

当我们需要汇总表中的数据而不是使用表中某一行数据时,可以使用Mysql为我们提供的聚合函数,在Mysql中,常用的聚合函数有以下五个:
- AVG:取平均值
- COUNT:取统计值
- MAX:取最大值
- MIN:取最小值
- SUM:取和值
MariaDB [world]> SELECT SUM(Population) FROM city;
+-----------------+
| SUM(Population) |
+-----------------+
|      1429559884 |
+-----------------+
1 row in set (0.01 sec)
MariaDB [world]> SELECT SUM(Population) FROM city WHERE CountryCOde='CHN';
+-----------------+
| SUM(Population) |
+-----------------+
|       175953614 |
+-----------------+
1 row in set (0.00 sec)
MariaDB [world]> SELECT COUNT(ID) FROM city WHERE CountryCode =  'CHN';
+-----------+
| COUNT(id) |
+-----------+
|       363 |
+-----------+
1 row in set (0.00 sec)
关于COUNT,如果要统计有该表有多少行,千万别用*作为参数,因为~影响性能,选某一列就好了。
MariaDB [world]> SELECT MIN(Population) FROM city WHERE CountryCode = 'CHN';
+-----------------+
| MIN(Population) |
+-----------------+
|           89288 |
+-----------------+
1 row in set (0.00 sec)
MariaDB [world]> SELECT MAX(Population) FROM city WHERE CountryCode = 'CHN';
+-----------------+
| MAX(Population) |
+-----------------+
|         9696300 |
+-----------------+
1 row in set (0.00 sec)
MariaDB [world]> SELECT AVG(Population) FROM city WHERE District ='Henan';
+-----------------+
| AVG(Population) |
+-----------------+
|     383278.3333 |
+-----------------+
1 row in set (0.00 sec)
所以,我们看到,聚合函数通常用于数值上的计算。
以上,我们使用聚合函数时,是对所有SELECT的数据进行分组操作,假如我们想要查询所有国家的城市数,不得不多次使用WHERE对CountryCode进行筛选。
MariaDB [world]> SELECT DISTINCT CountryCode FROM city;
+-------------+
| CountryCode |
+-------------+
| ABW         |
| AFG         |
...............
| ZWE         |
+-------------+
232 rows in set (0.00 sec)
我们看到,在我们的数据表中,有232个国家,那么?是不是需要我们对这232个不同国家都使用一次COUNT(ID)才能统计每个国家的城市数量呢?其实不然。
我们可以使用分组查询GROUP BY,什么叫分组呢? 分组查询就是使用指定的一列或多列,对数据进行逻辑分组(当分组依据相同时被划分为一组),假设有如下数据:
MariaDB [world]> SELECT * FROM city LIMIT 5;
+----+----------------+-------------+---------------+------------+
| ID | Name           | CountryCode | District      | Population |
+----+----------------+-------------+---------------+------------+
|  1 | Kabul          | AFG         | Kabol         |    1780000 |
|  2 | Qandahar       | AFG         | Qandahar      |     237500 |
|  3 | Herat          | AFG         | Herat         |     186800 |
|  4 | Mazar-e-Sharif | AFG         | Balkh         |     127800 |
|  5 | Amsterdam      | NLD         | Noord-Holland |     731200 |
+----+----------------+-------------+---------------+------------+
5 rows in set (0.00 sec)
我们使用GROUP BY CountryCode就是指定CountryCode作为分组依据,所以1,2,3,4行他们被分为同一组,而5在另一个组。
- 通常分组是配合聚合函数来使用的,聚合函数对每个单独的逻辑分组进行汇总计算。
- GROUP BY子句中列出的每一列都必须是检索列或有效的表达式(但不能是聚合函数),如果在SELECT中使用表达式,则必须在GROUP BY子句中指定相同的表达式,且不能使用别名。
- 除聚合函数外,SELECT语句中的每一列都必须在GROUP BY子句中给出。
- 如果分组中包含具有NULL值的行,则NULL将作为一个分组返回。
- GROUP BY子句必须出现在WHERE子句之后,ORDER BY子句之前。
MariaDB [world]> SELECT CountryCode,COUNT(ID) FROM city GROUP BY CountryCode;
+-------------+-----------+
| CountryCode | COUNT(ID) |
+-------------+-----------+
| ABW         |         1 |
| AFG         |         4 |
...........................
| ZMB         |         7 |
| ZWE         |         6 |
+-------------+-----------+
232 rows in set (0.00 sec)
当SELECT语句中使用WHERE子句时,WHERE子句总在分组前进行过滤。
MariaDB [world]> SELECT CountryCode,COUNT(ID) FROM city WHERE Population >= 1000000 GROUPP BY CountryCode;
+-------------+-----------+
| CountryCode | COUNT(ID) |
+-------------+-----------+
| AFG         |         1 |
| AGO         |         1 |
| ARG         |         3 |
| ARM         |         1 |
| AUS         |         4 |
...........................
| YUG         |         1 |
| ZAF         |         1 |
| ZMB         |         1 |
| ZWE         |         1 |
+-------------+-----------+
77 rows in set (0.01 sec)
所以在分组中未出现的国家,没有1000000人口的城市。
HAVING子句用于过滤分组后所得到汇总值的数据,而HAVING支持的操作和WHERE子句是相同的。
例如:
MariaDB [world]> SELECT CountryCode,SUM(Population) AS Total_Population FROM city GROUP BY CountryCode HAVING Total_Population > 1000000;
+-------------+------------------+
| CountryCode | Total_Population |
+-------------+------------------+
| AFG         |          2332100 |
| AGO         |          2561600 |
| ARE         |          1728336 |
..................................
| ZAF         |         15196370 |
| ZMB         |          2473500 |
| ZWE         |          2730420 |
+-------------+------------------+
108 rows in set (0.00 sec)
今天关于《Mariadb学习总结(八):聚合函数及分组查询》的内容介绍就到此结束,如果有什么疑问或者建议,可以在golang学习网公众号下多多回复交流;文中若有不正之处,也希望回复留言以告知!
 中国移动 11 月 5G 网络客户数达 5.47 亿户
- 上一篇
- 中国移动 11 月 5G 网络客户数达 5.47 亿户

- 下一篇
- 一文读懂Linux内存分配策略
-
- 文章 · linux | 21小时前 | Linux mount namespace PID namespace namespaces unshare
- Linux namespaces 怎样组合 mount 与 pid 隔离
- 470浏览 收藏
-
- 文章 · linux | 22小时前 | Linux systemd DeviceAllow DeviceDeny DevicePolicy 设备访问控制
- Linux systemd.resource-control DeviceAllow 怎样限制服务访问设备
- 224浏览 收藏
-
- 文章 · linux | 22小时前 | Linux 容器 虚拟机 systemd-detect-virt 虚拟化识别
- Linux systemd-detect-virt 怎样判断当前运行在虚拟机还是容器
- 206浏览 收藏
-
- 文章 · linux | 22小时前 |
- Linux pr 怎样把两个文本文件并排输出
- 252浏览 收藏
-
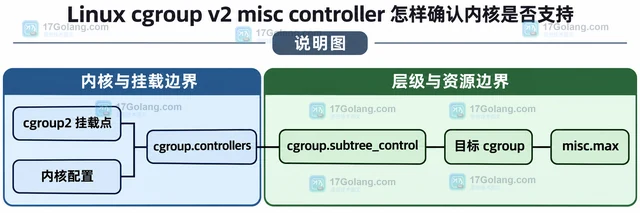
- 文章 · linux | 22小时前 | linux运维 · 兼容性 · Linux cgroup v2 misc controller misc.max 内核兼容性
- Linux cgroup v2 misc controller 怎样确认内核是否支持
- 259浏览 收藏
-
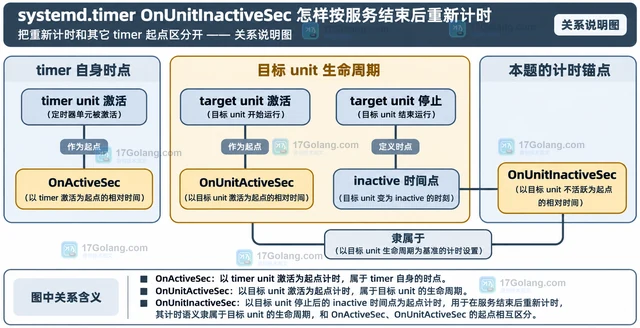
- 文章 · linux | 22小时前 | Linux · systemd 定时任务 systemd.timer OnUnitInactiveSec
- systemd.timer OnUnitInactiveSec 怎样按服务结束后重新计时
- 348浏览 收藏
-
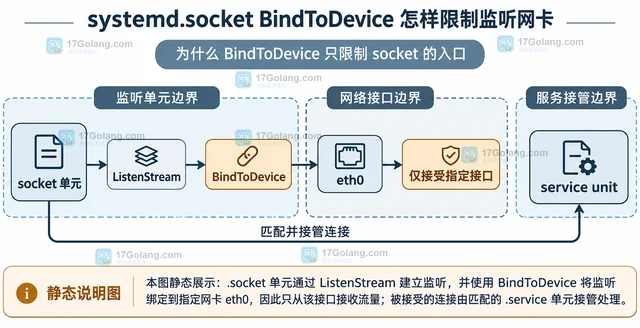
- 文章 · linux | 22小时前 | Linux · systemd systemd.socket BindToDevice 网络接口绑定
- systemd.socket BindToDevice 怎样限制监听网卡
- 184浏览 收藏
-
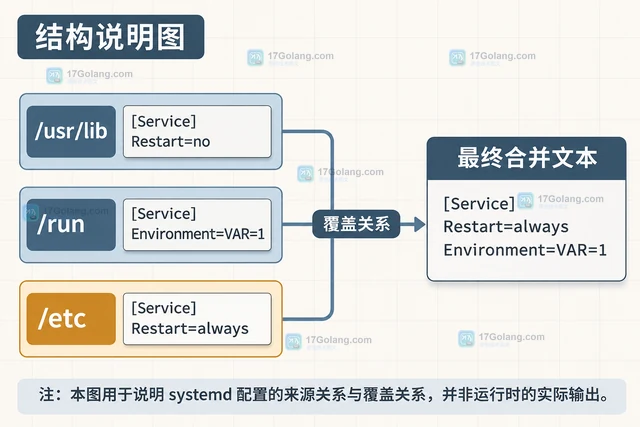
- 文章 · linux | 22小时前 | Linux · systemd systemd-analyze cat-config unit配置
- systemd-analyze cat-config 合并查看 unit 配置来源的操作方法
- 326浏览 收藏
-
- 文章 · linux | 23小时前 | Linux · 故障恢复 · 服务管理 · systemd Linux服务 Restart RestartMode systemd.service RestartPreventExitStatus RestartForceExitStatus
- systemd service RestartMode 怎样区分失败重启和异常退出
- 170浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 1155次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 1141次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 1320次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 1261次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 1116次使用
-
- Linux vmstat 如何分辨内存抖动与磁盘等待:si、so、wa 与复测顺序
- 2026-08-30 501浏览
-
- Linux搭建vsftpdFTP服务器教程
- 2026-04-30 501浏览
-
- Shell脚本安装教程:.sh一键安装指南
- 2026-03-16 501浏览
-
- Linux清空文件内容的几种方法
- 2025-12-01 501浏览
-
- Linux命令行下载文件技巧
- 2025-11-23 501浏览


