
Go 切片 cap 函数为何返回 6 而不是 5?
2024-11-14 15:09:59
0浏览
收藏
“纵有疾风来,人生不言弃”,这句话送给正在学习Golang的朋友们,也希望在阅读本文《Go 切片 cap 函数为何返回 6 而不是 5?》后,能够真的帮助到大家。我也会在后续的文章中,陆续更新Golang相关的技术文章,有好的建议欢迎大家在评论留言,非常感谢!

切片 cap 函数返回 6 ではなく 5 になる理由
在给出的代码中,append 函数被用于向切片 s 添加多个整数。在添加 5 个整数后,切片的 cap 却返回了 6,而不是预期的 5。本文将探讨造成这个现象的原因。
切片 cap 函数返回的是切片底层数组的容量,即其可以容纳的元素数量。在 Go 语言中,cap >= len,即容量总是大于或等于长度。
在代码中,当添加第一个元素时,cap 被设置为 1,因为底层数组的容量至少需要能够容纳一个元素。之后,每一次追加操作都会检查底层数组的容量是否足够。如果容量不足,底层数组的容量将会翻倍。
在添加 5 个整数后,cap 返回 6,表明底层数组的容量为 6。这是因为当追加到长度为 4 的切片时,底层数组的容量不足以容纳新的元素。因此,容量被翻倍为 8,而 cap 函数返回了 6,这是切片当前容量的较小值。
这种设计策略是为了提高切片操作的效率。通过预分配多余的容量,切片可以避免频繁地重新分配和拷贝内存,从而提高性能。
以上就是《Go 切片 cap 函数为何返回 6 而不是 5?》的详细内容,更多关于的资料请关注golang学习网公众号!
 MySQL8 中,为何使用字符串能查询 int 类型数据?
- 上一篇
- MySQL8 中,为何使用字符串能查询 int 类型数据?

- 下一篇
- 揭秘电脑几秒黑屏的6大常见原因
查看更多
最新文章
-
- Golang · Go教程 | 1天前 | Go教程 · Go encoding/xml 空元素 指针字段
- Go encoding/xml 空元素与指针字段的处理方式
- 142浏览 收藏
-
- Golang · Go教程 | 1天前 | Go教程 · Go encoding/xml 字段映射 Unmarshaler
- Go encoding/xml 自定义 Unmarshaler 的字段映射
- 189浏览 收藏
-
- Golang · Go教程 | 1天前 |
- Go encoding/xml Token 流式读取大型 XML
- 424浏览 收藏
-
- Golang · Go教程 | 1天前 | go · encoding/json · JSON Go encoding/json omitempty
- Go encoding/json omitempty 对零值字段的输出边界
- 192浏览 收藏
-
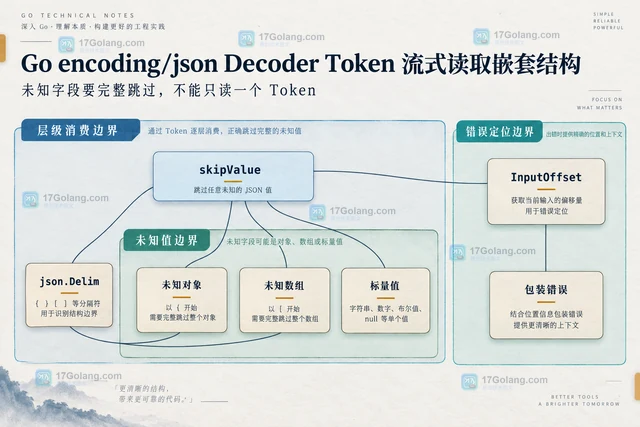
- Golang · Go教程 | 1天前 |
- Go encoding/json Decoder Token 流式读取嵌套结构
- 364浏览 收藏
-
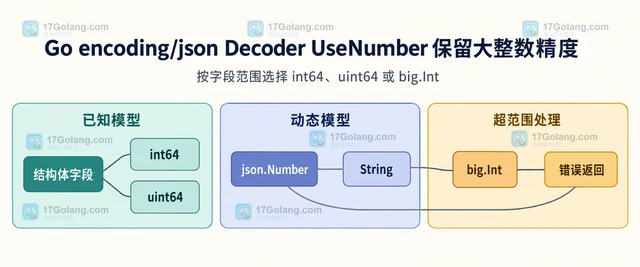
- Golang · Go教程 | 1天前 |
- Go encoding/json Decoder UseNumber 保留大整数精度
- 328浏览 收藏
-
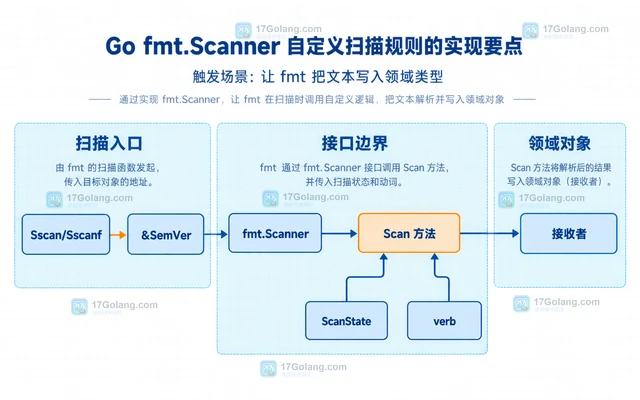
- Golang · Go教程 | 1天前 |
- Go fmt.Scanner 自定义扫描规则的实现要点
- 182浏览 收藏
-
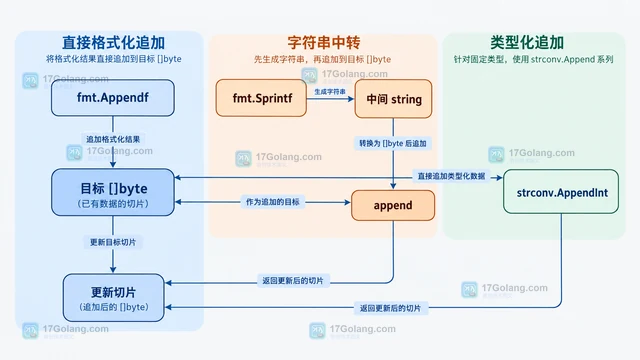
- Golang · Go教程 | 1天前 |
- Go fmt.Appendf 追加格式化结果的低分配写法
- 478浏览 收藏
-
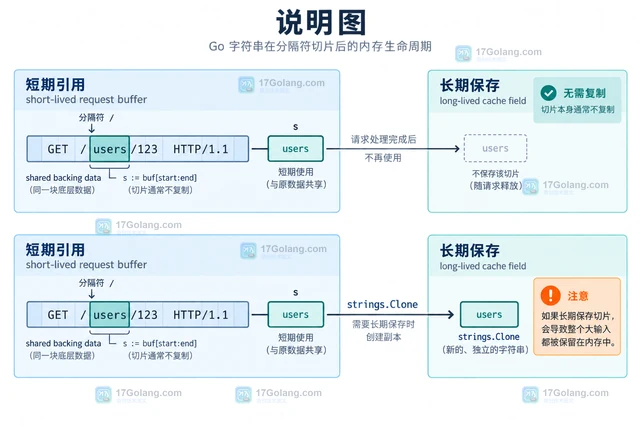
- Golang · Go教程 | 1天前 |
- Go strings.IndexByte 定位协议分隔符的低分配写法
- 413浏览 收藏
-
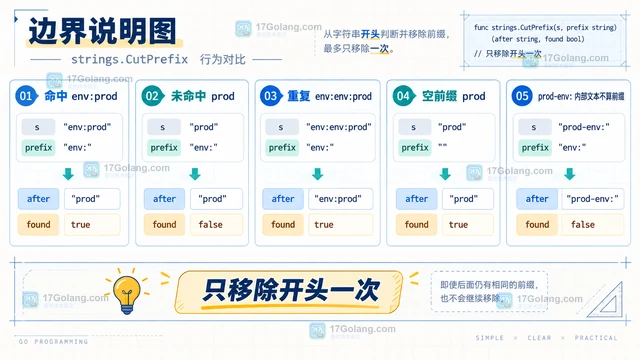
- Golang · Go教程 | 1天前 | go · Strings · Go 字符串前缀 strings.CutPrefix
- Go strings.CutPrefix 处理可选前缀的分支设计
- 165浏览 收藏
查看更多
课程推荐
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
查看更多
AI推荐
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 266次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 318次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 303次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 275次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 94次使用
查看更多
相关文章
-
- Java 性能优化上线清单:从定位、改造到灰度发布
- 2026-06-11 860浏览
-
- Spring Boot 压测验证:Gatling、JMeter 与性能回归门禁
- 2026-06-11 843浏览
-
- Java NMT 非堆内存排查:Direct Buffer、线程栈与 Metaspace 分析
- 2026-06-11 826浏览
-
- Spring Boot 容器内存优化:JVM 堆、非堆与 MaxRAMPercentage
- 2026-06-11 809浏览
-
- Tomcat 连接与线程参数调优:maxThreads、acceptCount 与 KeepAlive
- 2026-06-11 792浏览