
深入分析mysql为什么不推荐使用uuid或者雪花id作为主键
怎么入门数据库编程?需要学习哪些知识点?这是新手们刚接触编程时常见的问题;下面golang学习网就来给大家整理分享一些知识点,希望能够给初学者一些帮助。本篇文章就来介绍《深入分析mysql为什么不推荐使用uuid或者雪花id作为主键》,涉及到主键、mysqluuid、雪花id,有需要的可以收藏一下
前言:在mysql中设计表的时候,mysql官方推荐不要使用uuid或者不连续不重复的雪花id(long形且唯一),而是推荐连续自增的主键id,官方的推荐是auto_increment,那么为什么不建议采用uuid,使用uuid究竟有什么坏处?本篇博客我们就来分析这个问题,探讨一下内部的原因。
一:mysql和程序实例
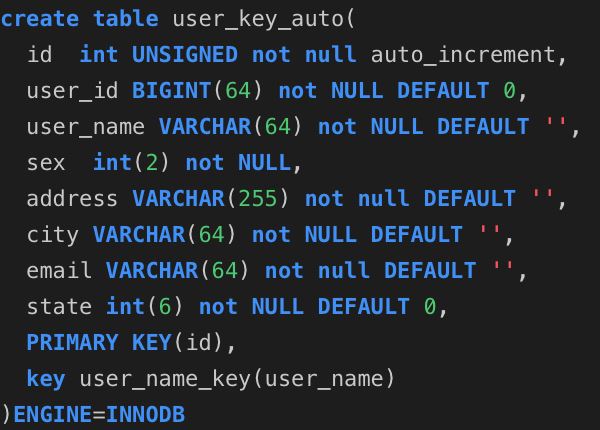
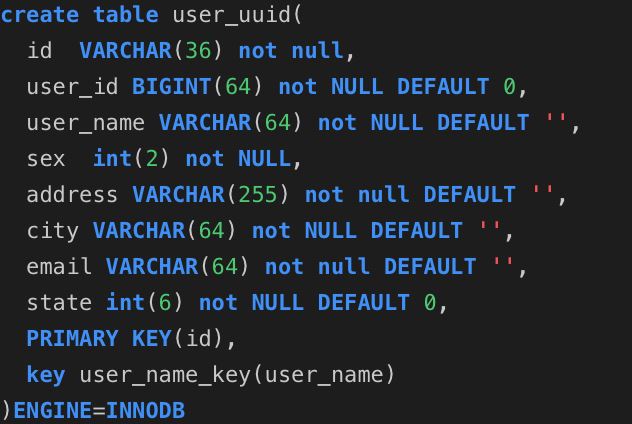
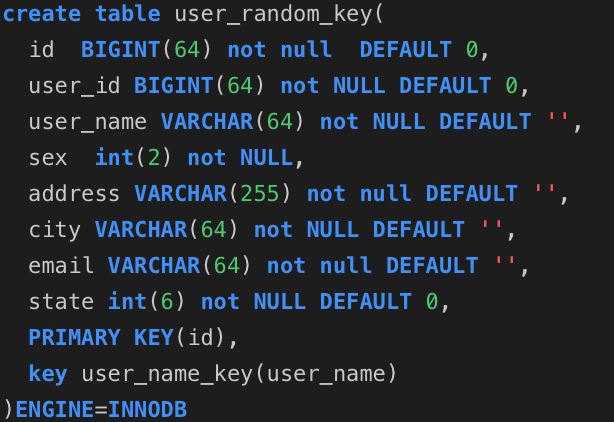
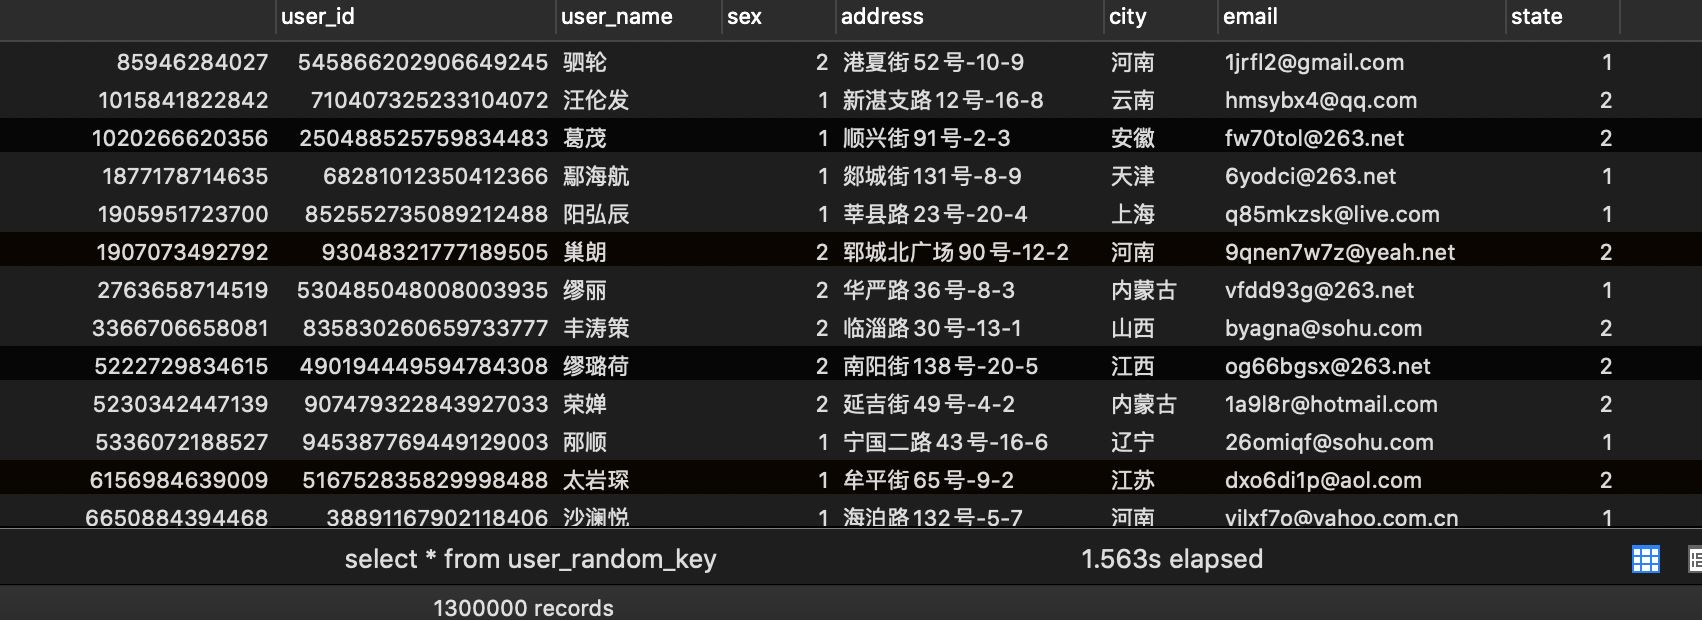
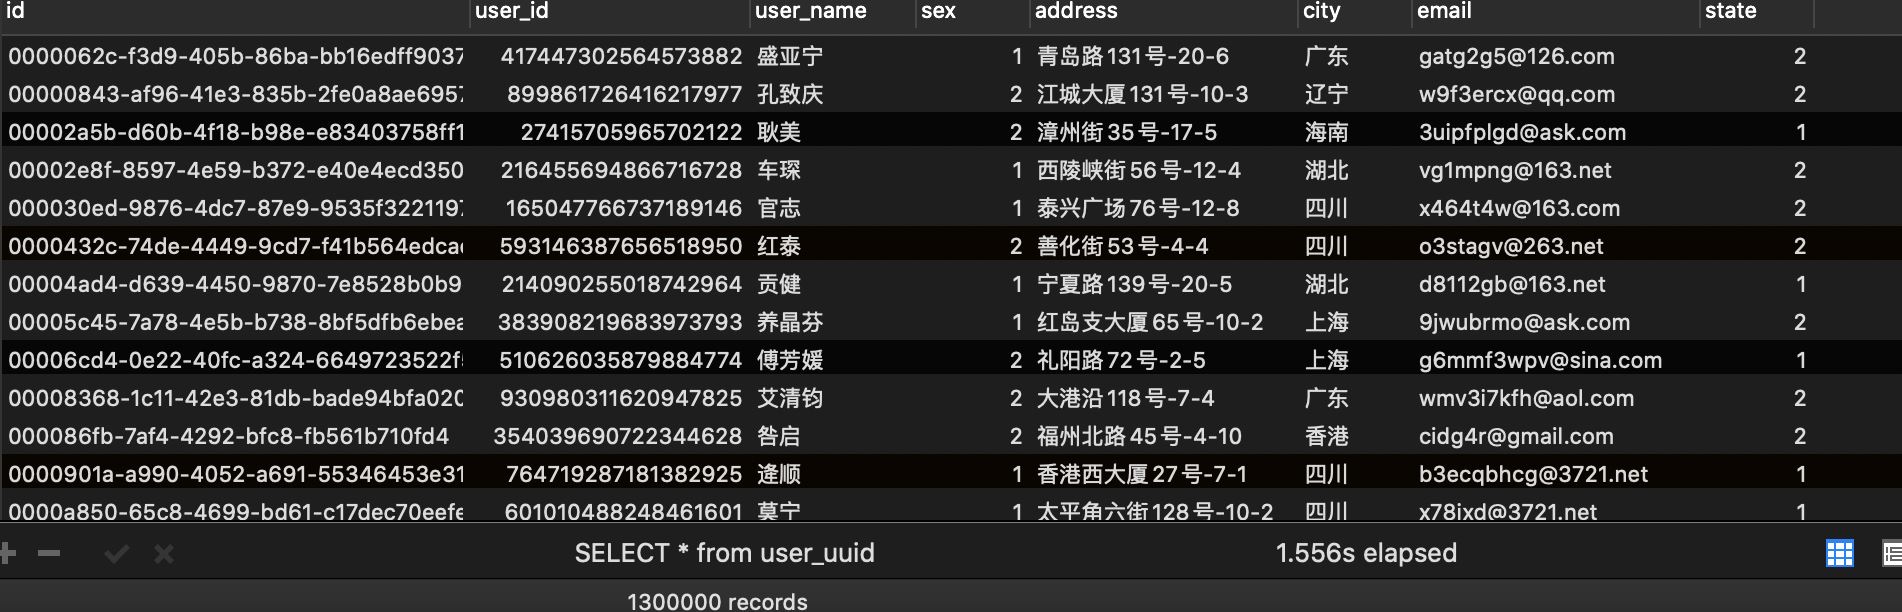
1.1:要说明这个问题,我们首先来建立三张表,分别是user_auto_key,user_uuid,user_random_key,分别表示自动增长的主键,uuid作为主键,随机key作为主键,其它我们完全保持不变.根据控制变量法,我们只把每个表的主键使用不同的策略生成,而其他的字段完全一样,然后测试一下表的插入速度和查询速度:
注:这里的随机key其实是指用雪花算法算出来的前后不连续不重复无规律的id:一串18位长度的long值
id自动生成表:
用户uuid表
随机主键表:
1.2:光有理论不行,直接上程序,使用spring的jdbcTemplate来实现增查测试:
技术框架:springboot+jdbcTemplate+junit+hutool,程序的原理就是连接自己的测试数据库,然后在相同的环境下写入同等数量的数据,来分析一下insert插入的时间来进行综合其效率,为了做到最真实的效果,所有的数据采用随机生成,比如名字、邮箱、地址都是随机生成,程序已上传自gitee,地址在文底。
package com.wyq.mysqldemo;
import cn.hutool.core.collection.CollectionUtil;
import com.wyq.mysqldemo.databaseobject.UserKeyAuto;
import com.wyq.mysqldemo.databaseobject.UserKeyRandom;
import com.wyq.mysqldemo.databaseobject.UserKeyUUID;
import com.wyq.mysqldemo.diffkeytest.AutoKeyTableService;
import com.wyq.mysqldemo.diffkeytest.RandomKeyTableService;
import com.wyq.mysqldemo.diffkeytest.UUIDKeyTableService;
import com.wyq.mysqldemo.util.JdbcTemplateService;
import org.junit.jupiter.api.Test;
import org.springframework.beans.factory.annotation.Autowired;
import org.springframework.boot.test.context.SpringBootTest;
import org.springframework.util.StopWatch;
import java.util.List;
@SpringBootTest
class MysqlDemoApplicationTests {

  @Autowired
  private JdbcTemplateService jdbcTemplateService;

  @Autowired
  private AutoKeyTableService autoKeyTableService;

  @Autowired
  private UUIDKeyTableService uuidKeyTableService;

  @Autowired
  private RandomKeyTableService randomKeyTableService;


  @Test
  void testDBTime() {

    StopWatch stopwatch = new StopWatch("执行sql时间消耗");


    /**
     * auto_increment key任务
     */
    final String insertSql = "INSERT INTO user_key_auto(user_id,user_name,sex,address,city,email,state) VALUES(?,?,?,?,?,?,?)";

    List insertData = autoKeyTableService.getInsertData();
    stopwatch.start("自动生成key表任务开始");
    long start1 = System.currentTimeMillis();
    if (CollectionUtil.isNotEmpty(insertData)) {
      boolean insertResult = jdbcTemplateService.insert(insertSql, insertData, false);
      System.out.println(insertResult);
    }
    long end1 = System.currentTimeMillis();
    System.out.println("auto key消耗的时间:" + (end1 - start1));

    stopwatch.stop();


    /**
     * uudID的key
     */
    final String insertSql2 = "INSERT INTO user_uuid(id,user_id,user_name,sex,address,city,email,state) VALUES(?,?,?,?,?,?,?,?)";

    List insertData2 = uuidKeyTableService.getInsertData();
    stopwatch.start("UUID的key表任务开始");
    long begin = System.currentTimeMillis();
    if (CollectionUtil.isNotEmpty(insertData)) {
      boolean insertResult = jdbcTemplateService.insert(insertSql2, insertData2, true);
      System.out.println(insertResult);
    }
    long over = System.currentTimeMillis();
    System.out.println("UUID key消耗的时间:" + (over - begin));

    stopwatch.stop();


    /**
     * 随机的long值key
     */
    final String insertSql3 = "INSERT INTO user_random_key(id,user_id,user_name,sex,address,city,email,state) VALUES(?,?,?,?,?,?,?,?)";
    List insertData3 = randomKeyTableService.getInsertData();
    stopwatch.start("随机的long值key表任务开始");
    Long start = System.currentTimeMillis();
    if (CollectionUtil.isNotEmpty(insertData)) {
      boolean insertResult = jdbcTemplateService.insert(insertSql3, insertData3, true);
      System.out.println(insertResult);
    }
    Long end = System.currentTimeMillis();
    System.out.println("随机key任务消耗时间:" + (end - start));
    stopwatch.stop();


    String result = stopwatch.prettyPrint();
    System.out.println(result);
  }
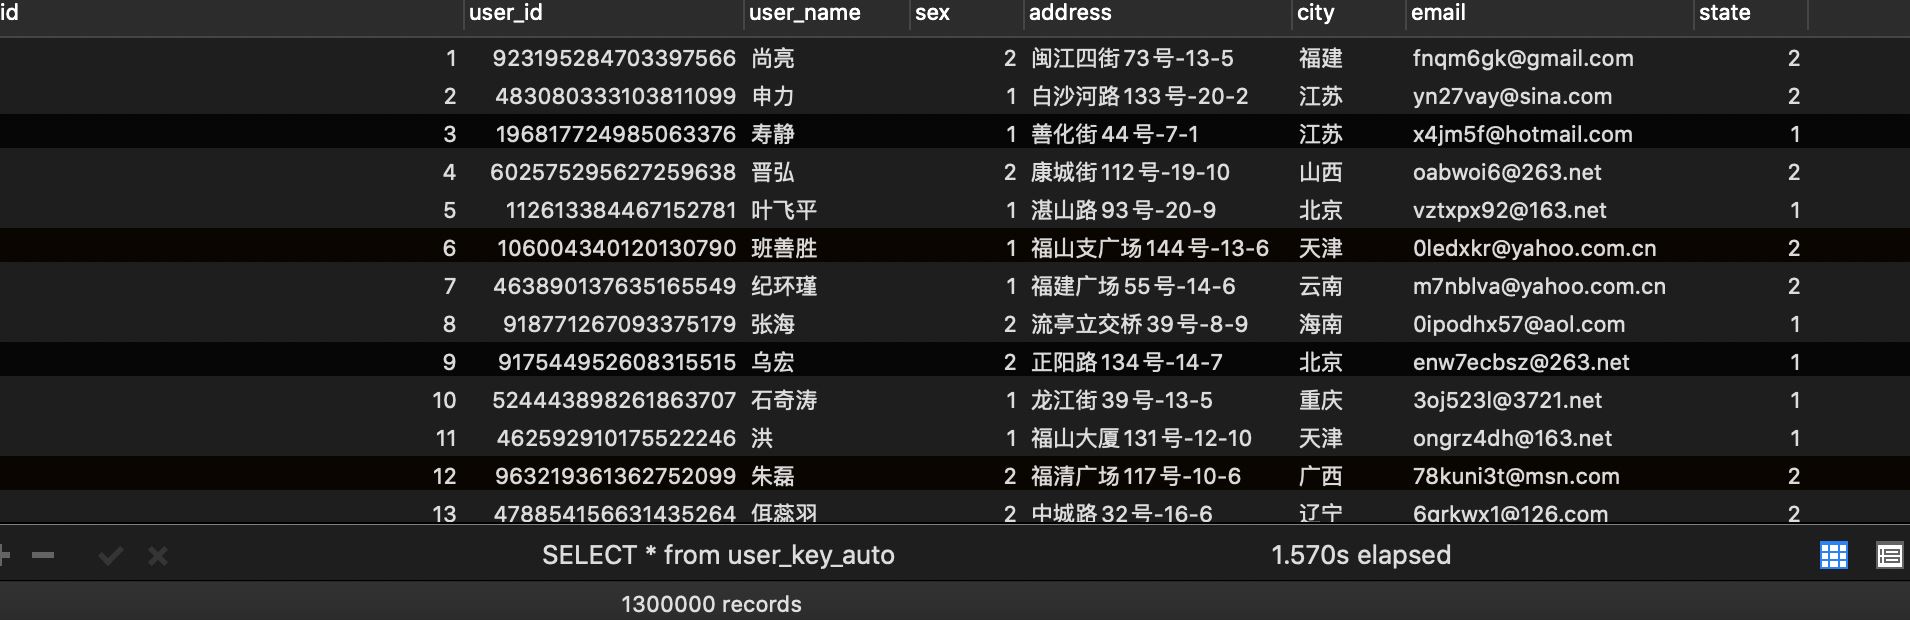
1.3:程序写入结果
user_key_auto写入结果:
user_random_key写入结果:
user_uuid表写入结果:
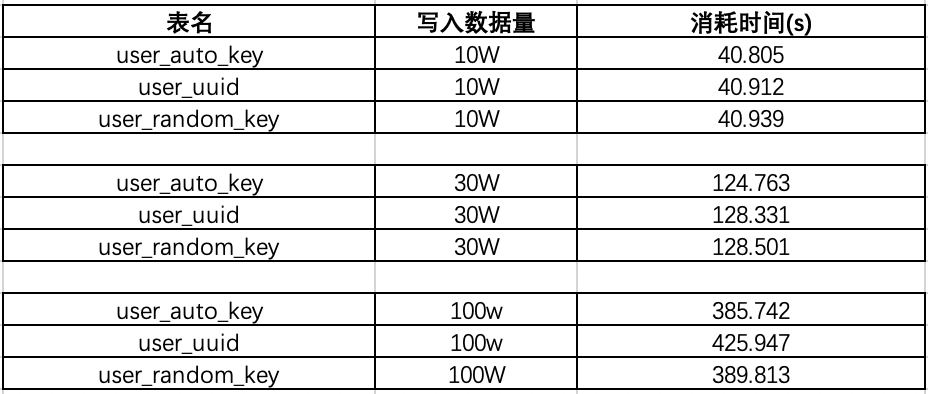
1.4:效率测试结果
在已有数据量为130W的时候:我们再来测试一下插入10w数据,看看会有什么结果:
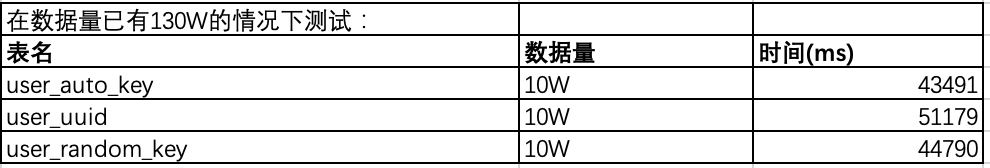
可以看出在数据量100W左右的时候,uuid的插入效率垫底,并且在后序增加了130W的数据,uudi的时间又直线下降。时间占用量总体可以打出的效率排名为:auto_key>random_key>uuid,uuid的效率最低,在数据量较大的情况下,效率直线下滑。那么为什么会出现这样的现象呢?带着疑问,我们来探讨一下这个问题:
二:使用uuid和自增id的索引结构对比
2.1:使用自增id的内部结构
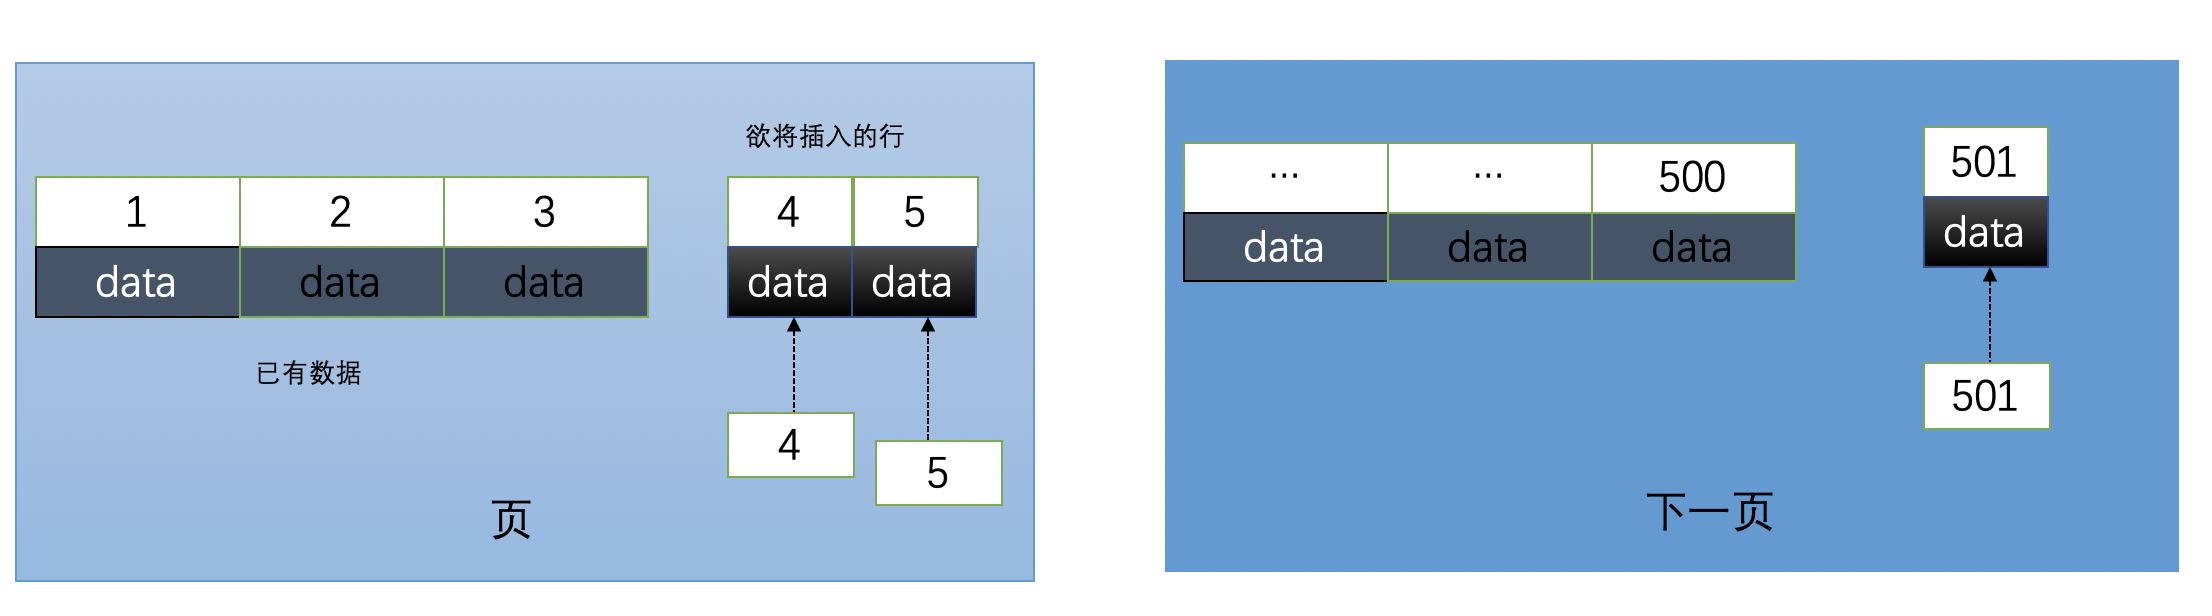
自增的主键的值是顺序的,所以Innodb把每一条记录都存储在一条记录的后面。当达到页面的最大填充因子时候(innodb默认的最大填充因子是页大小的15/16,会留出1/16的空间留作以后的 修改):
①下一条记录就会写入新的页中,一旦数据按照这种顺序的方式加载,主键页就会近乎于顺序的记录填满,提升了页面的最大填充率,不会有页的浪费
②新插入的行一定会在原有的最大数据行下一行,mysql定位和寻址很快,不会为计算新行的位置而做出额外的消耗
③减少了页分裂和碎片的产生
2.2:使用uuid的索引内部结构
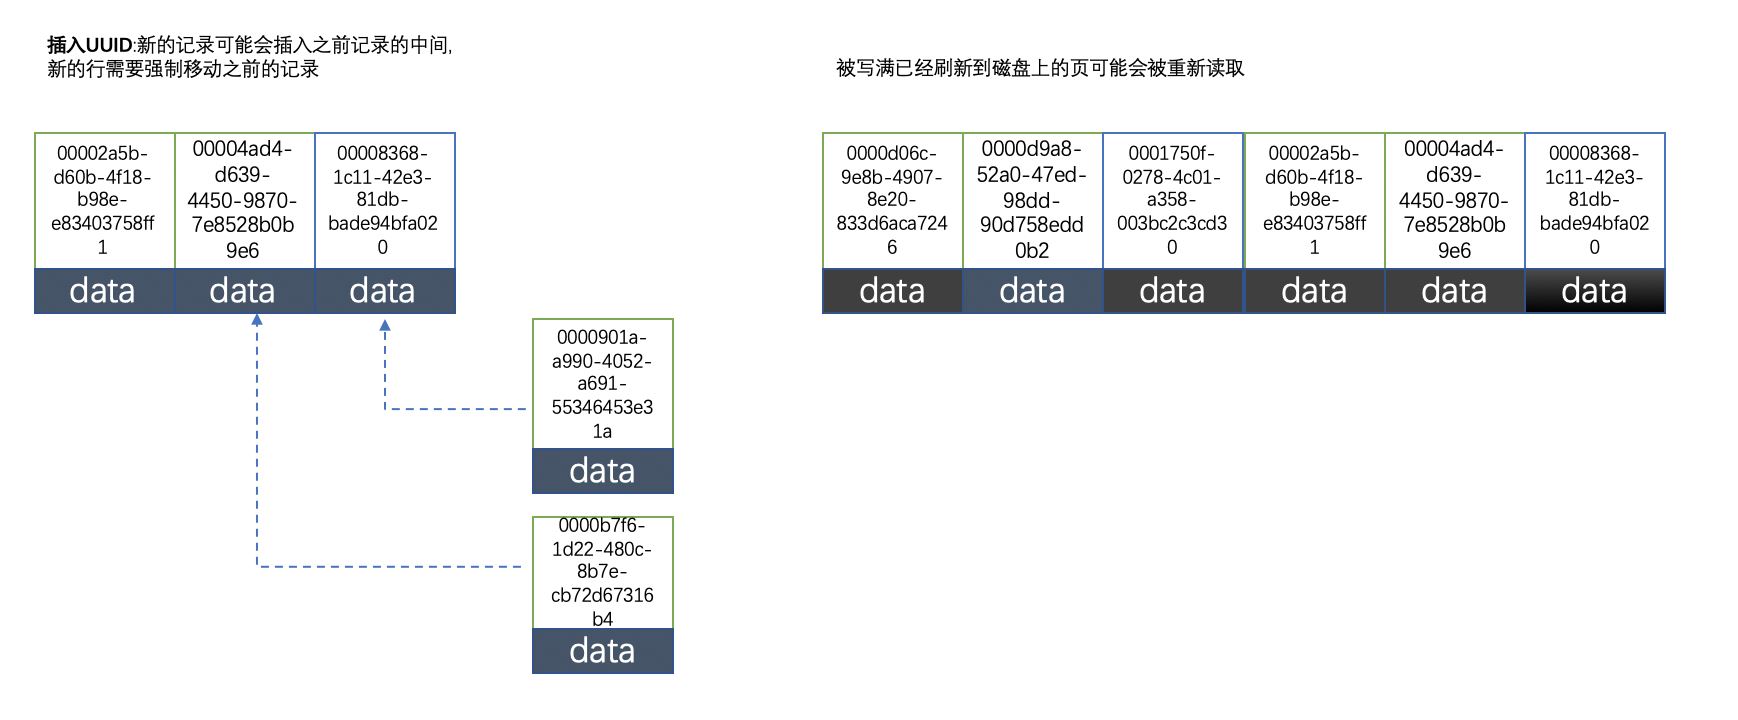
因为uuid相对顺序的自增id来说是毫无规律可言的,新行的值不一定要比之前的主键的值要大,所以innodb无法做到总是把新行插入到索引的最后,而是需要为新行寻找新的合适的位置从而来分配新的空间。这个过程需要做很多额外的操作,数据的毫无顺序会导致数据分布散乱,将会导致以下的问题:
①:写入的目标页很可能已经刷新到磁盘上并且从缓存上移除,或者还没有被加载到缓存中,innodb在插入之前不得不先找到并从磁盘读取目标页到内存中,这将导致大量的随机IO
②:因为写入是乱序的,innodb不得不频繁的做页分裂操作,以便为新的行分配空间,页分裂导致移动大量的数据,一次插入最少需要修改三个页以上
③:由于频繁的页分裂,页会变得稀疏并被不规则的填充,最终会导致数据会有碎片
在把随机值(uuid和雪花id)载入到聚簇索引(innodb默认的索引类型)以后,有时候会需要做一次OPTIMEIZE TABLE来重建表并优化页的填充,这将又需要一定的时间消耗。
结论:使用innodb应该尽可能的按主键的自增顺序插入,并且尽可能使用单调的增加的聚簇键的值来插入新行
2.3:使用自增id的缺点
那么使用自增的id就完全没有坏处了吗?并不是,自增id也会存在以下几点问题:
①:别人一旦爬取你的数据库,就可以根据数据库的自增id获取到你的业务增长信息,很容易分析出你的经营情况
②:对于高并发的负载,innodb在按主键进行插入的时候会造成明显的锁争用,主键的上界会成为争抢的热点,因为所有的插入都发生在这里,并发插入会导致间隙锁竞争
③:Auto_Increment锁机制会造成自增锁的抢夺,有一定的性能损失
附:Auto_increment的锁争抢问题,如果要改善需要调优innodb_autoinc_lock_mode的配置
三:总结
本篇博客首先从开篇的提出问题,建表到使用jdbcTemplate去测试不同id的生成策略在大数据量的数据插入表现,然后分析了id的机制不同在mysql的索引结构以及优缺点,深入的解释了为何uuid和随机不重复id在数据插入中的性能损耗,详细的解释了这个问题。在实际的开发中还是根据mysql的官方推荐最好使用自增id,mysql博大精深,内部还有很多值得优化的点需要我们学习。
附:本篇博客demo地址:https://gitee.com/Yrion/mysqlIdDemo
好了,本文到此结束,带大家了解了《深入分析mysql为什么不推荐使用uuid或者雪花id作为主键》,希望本文对你有所帮助!关注golang学习网公众号,给大家分享更多数据库知识!
 MySQL 如何修改root用户的密码
- 上一篇
- MySQL 如何修改root用户的密码
- 下一篇
- MySQL之存储过程按月创建表的方法步骤
-
- 大方的电源
- 这篇文章内容太及时了,太细致了,很好,已收藏,关注作者大大了!希望作者大大能多写数据库相关的文章。
- 2022-12-30 10:58:28
-
- 数据库 · MySQL | 4小时前 |
- JSON_TABLE 怎样展开嵌套文档
- 165浏览 收藏
-
- 数据库 · MySQL | 11小时前 |
- 部分更新 怎样减少 JSON 写放大
- 231浏览 收藏
-
- 数据库 · MySQL | 11小时前 |
- EXPLAIN FORMAT=JSON 怎样读取窗口节点
- 311浏览 收藏
-
- 数据库 · MySQL | 11小时前 |
- JSON 路径索引 怎样减少文档扫描
- 416浏览 收藏
-
- 数据库 · MySQL | 11小时前 |
- ONLY_FULL_GROUP_BY 怎样处理函数依赖
- 365浏览 收藏
-
- 数据库 · MySQL | 11小时前 |
- 不可见索引 怎样做安全回滚试验
- 254浏览 收藏
-
- 数据库 · MySQL | 12小时前 | MySQL · mysql optimizer_switch 派生表 条件下推
- optimizer_switch 怎样控制派生条件下推
- 358浏览 收藏
-
- 数据库 · MySQL | 12小时前 |
- GTID 怎样查看组复制事务标识
- 228浏览 收藏
-
- 数据库 · MySQL | 12小时前 |
- GeoJSON 怎样提取空间属性
- 462浏览 收藏
-
- 数据库 · MySQL | 12小时前 |
- 窗口函数 怎样读取 windowing 计划
- 130浏览 收藏
-
- 数据库 · MySQL | 12小时前 | MySQL · JSON · 数据校验 · JSON_SCHEMA_VALID CHECK 约束 MySQL JSON Schema JSON 结构校验 JSON_SCHEMA_VALIDATION_REPORT
- JSON_SCHEMA_VALID 怎样先判断结构
- 293浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 690次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 703次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 765次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 728次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 564次使用
-
- golang 数据库主键的问题
- 2023-02-25 217浏览
-
- 关于pt-archiver和自增主键的那些事
- 2023-02-16 243浏览
-
- MySQL8自增主键变化图文详解
- 2023-01-02 103浏览
-
- Mysql分库分表之后主键处理的几种方法
- 2022-12-31 469浏览
-
- 深入谈谈MySQL中的自增主键
- 2022-12-29 134浏览


