
当前位置:首页 >专题 >Go 网页采集与 Colly 工程实践专题
Go 网页采集与 Colly
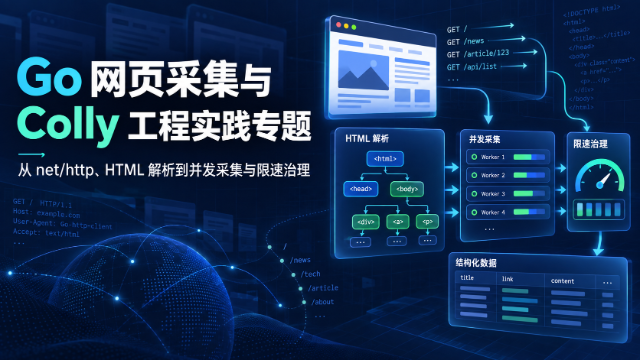
Go 网页采集与 Colly 工程实践专题
从 net/http、HTML 解析到并发采集与限速治理
网页采集不是简单发送请求再匹配字符串:请求头、编码、选择器、分页、并发、限速、重试、Cookie、失败恢复和数据落库共同决定采集器能否长期运行。本专题从 Go 标准库入口开始,串联 goquery 与 Colly 的真实文章,帮助开发者把一次性抓取脚本升级为可控制、可恢复、可维护的采集工程。
官方入口与采集基础
先建立 HTTP、HTML 解析和采集框架的判断基线
官方
Go net/http 官方文档
Go 标准库 HTTP 客户端、请求、响应、Transport、Cookie 与超时 API 参考。
官方
Go io 官方文档
Reader、Writer、Copy、LimitReader 等流式读写基础 API。
官方
golang.org/x/net/html 官方文档
Go HTML5 解析器与 Node 树 API,支持构建和遍历 HTML 文档。
官方
Colly 官方文档
Colly 官方文档入口,覆盖安装、Collector、回调、配置、并发、存储和示例。
官方
Colly Getting Started
Colly 官方快速开始,展示 Collector、回调和基本访问流程。
官方
Colly GitHub 仓库
Colly 官方源码、版本、特性、示例和维护入口。
官方
goquery GitHub 仓库
goquery 官方仓库,提供类似 jQuery 的 HTML 文档遍历与 CSS 选择器能力。
官方
Colly Best Practices
Colly 官方最佳实践入口,连接配置、限速、并发、存储和调试主题。
站内网页采集工程路径
从请求与选择器推进到并发调度、失败处理和完整爬虫


网页采集工程常见问题
把请求合规、稳定性、选择器和并发中的高频误区变成检查动作
Go 爬虫如何控制请求频率?
为每个站点设置并发上限、请求间隔、超时和退避策略,优先使用 Colly 的限速与队列能力;同时尊重 robots.txt、站点条款和公开接口约束。
goquery 选择器失效时先检查什么?
先检查响应状态码、Content-Type、字符编码、页面是否由 JavaScript 动态渲染,再确认 CSS 选择器匹配的节点层级;必要时记录原始 HTML 片段和选择数量。
并发爬虫如何避免重复 URL 和数据竞争?
用规范化 URL、去重集合和明确的任务状态管理访问计划;共享数据要通过受控队列或锁保护,回调中避免直接并发写入非线程安全结构。
网页采集遇到 403、超时或解析失败怎么办?
区分可重试网络错误、服务端拒绝和内容格式错误,设置有限次数退避重试并记录 URL、状态码和响应摘要;不要用无限重试掩盖站点变化或访问限制。
相关专题
继续查看相近方向内容
查看更多
最新文章
-
- LiblibAI生成图片细节发糊怎么办?从原始画幅到放大验收的排查步骤
- 55秒前 149浏览
-
- Go go test -race 为什么能发现共享变量数据竞争
- 1分钟前 322浏览
-
- MySQL 外键 ON DELETE SET NULL 为什么要求列可空
- 4分钟前 325浏览
-
- Go sync.WaitGroup WaitGroup 为什么不能复制
- 13分钟前 124浏览
-
- AI绘图选基础模型还是LoRA?用LiblibAI按角色、风格和复现要求判断
- 16分钟前 472浏览
-
- Go regexp.Longest 调用后为什么匹配结果会变化
- 17分钟前 432浏览
-
- 秋日玻璃温室手机壁纸怎么让叶片避开时间区域
- 22分钟前 363浏览
-
- 餐饮门店更换供应商时怎么交接资质和验收记录
- 25分钟前 198浏览


