详细介绍
Open LLM Leaderboard简介
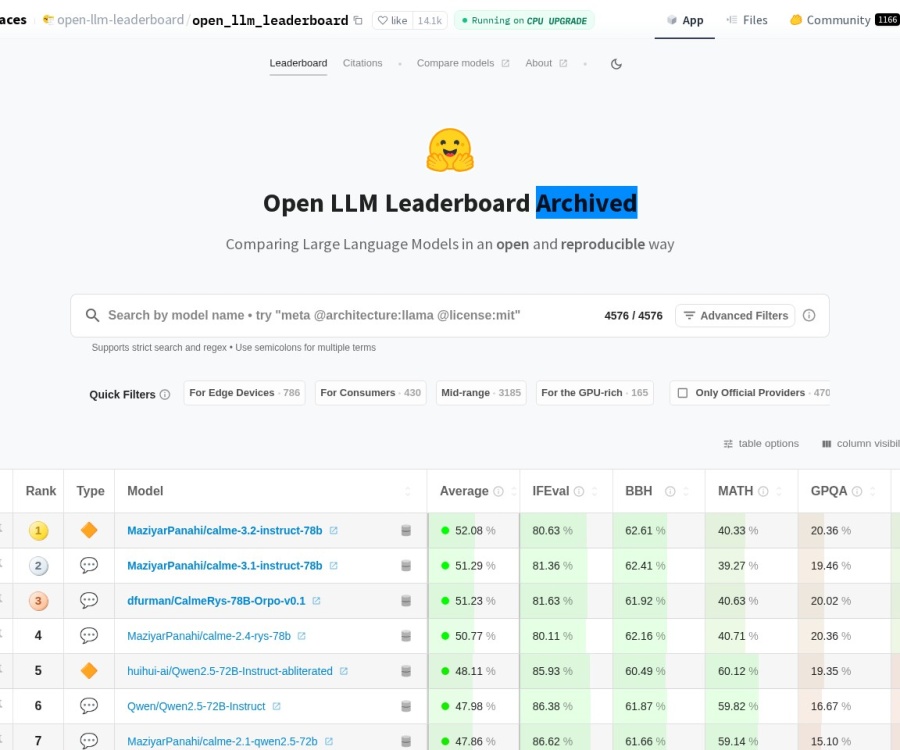
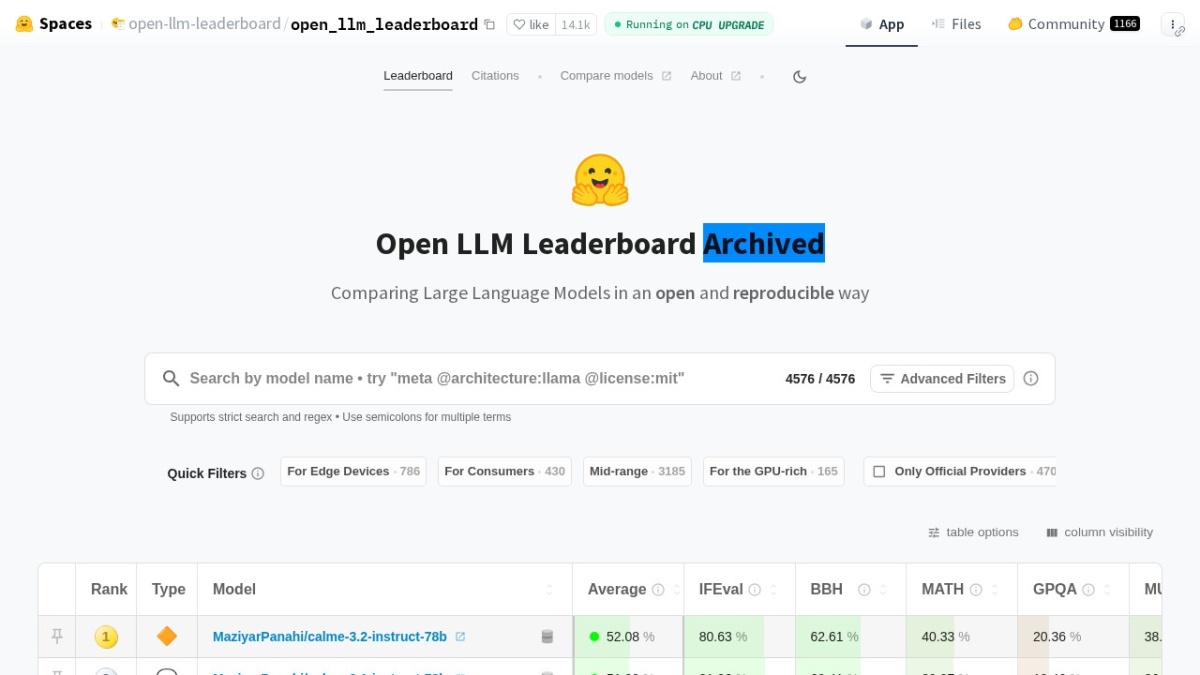
Open LLM Leaderboard 是由全球领先的大模型与数据集社区 HuggingFace 推出的权威开源大模型排行榜单。该榜单基于 Eleuther AI Language Model Evaluation Harness(Eleuther AI语言模型评估框架)构建,旨在通过标准化的测试流程评估模型性能。Open LLM Leaderboard 利用 IFEval、BBH、MATH 等多种基准测试,从指令遵循能力、复杂逻辑推理、数学解题技巧以及专业知识问答等多个维度对模型进行全方位考核。排行榜不仅涵盖预训练模型,还包括聊天机器人模型等多种类型,并提供详尽的数值评分及模型输入输出细节。借助 Open LLM Leaderboard,用户能够高效筛选出当前业界最先进的模型,从而推动开源人工智能社区的持续发展。
Open LLM Leaderboard 核心功能
- 多维度基准测试体系:集成 IFEval、BBH、MATH、GPQA 等多样化基准测试,覆盖指令遵循、复杂推理、数学计算及专业领域问答等场景,全面衡量模型的综合智能水平。
- 广泛的模型类型支持:兼容预训练模型、持续预训练模型、特定领域微调模型以及聊天交互模型,满足不同应用场景下的评估需求。
- 透明的结果展示:提供精确的量化评分数据以及模型具体的输入输出示例,帮助用户深入剖析模型的实际表现与潜在缺陷。
- 活跃的社区互动机制:允许社区成员对模型进行标记、评论和讨论,确保排行榜数据的公正性、透明度及时效性。
- 强大的可复现性支持:开放相关代码库评估工具,使研究人员和开发者能够复现榜单上的测试结果,增强学术研究的可信度。
Open LLM Leaderboard 主要评估基准
- IFEval:专注于评估模型遵循明确指令的能力,特别是针对格式约束等要求,采用严格的准确率指标进行衡量。
- BBH(Big Bench Hard):包含23个高难度子任务,涉及多步算术运算、算法逻辑推理及深层语言理解,旨在测试模型的综合解决能力。
- MATH:专门测试模型解决高中竞赛级别数学难题的能力,要求模型在解题过程中严格遵循特定的输出格式规范。
- GPQA(Graduate-Level Google-Proof Q&A Benchmark):由领域专家设计的高难度知识问答基准,涵盖多学科专业知识,难以通过简单搜索获取答案。
- MuSR(Multistep Soft Reasoning):通过复杂的的多步推理问题(例如谋杀案谜题),评估模型在长上下文环境下的解析能力与逻辑推理水平。
- MMLU-PRO(Massive Multitask Language Understanding – Professional):MMLU的专业改进版,通过增加选项数量和提升问题难度来减少噪声干扰,更准确地评估多任务语言理解能力。
如何使用 Open LLM Leaderboard
- 访问排行榜主页:进入 Open LLM Leaderboard 官方页面,浏览最新的模型排名列表及各项性能数据。
- 查阅模型详细档案:点击感兴趣的模型名称,深入查看其详细的技术参数、评测得分及具体表现。
- 筛选与对比模型:利用页面提供的筛选工具,根据模型类型、参数量或特定性能指标进行过滤。对比不同模型在各基准测试中的得分,从而选择最符合项目需求的模型。
- 复现评估结果:若需验证或复现特定模型的评测成绩,可使用 Hugging Face 提供的以下代码工具:
git clone git@github.com:huggingface/lm-evaluation-harness.git
cd lm-evaluation-harness
git checkout main
pip install -e .
lm-eval --model_args="pretrained=<your_model>,revision=<your_model_revision>,dtype=<model_dtype>" --tasks=leaderboard --batch_size=auto --output_path=<output_path>- 请将
<your_model>、<your_model_revision>和<output_path>替换为您的实际参数值。 - 针对指令微调模型,建议添加
--apply_chat_template和--fewshot_as_multiturn参数以确保评估准确性。
Open LLM Leaderboard 的应用场景
- 模型选型与评估:帮助开发者和研究人员快速识别适合特定任务(如智能客服系统、自动内容生成等)的最佳开源语言模型。
- 学术研究与基准测试:为学术界提供统一、标准的评估平台,协助研究人员客观评价模型性能,促进语言模型技术的迭代创新。
- 开源社区协作:激发开源社区的活力,鼓励开发者提交新模型至排行榜,分享最新的研究成果与技术突破。
- 教育与技能培训:作为优质的教育资源,帮助学生和初学者掌握语言模型的评估方法论及关键性能指标,提供实践操作平台。
- 技术验证与竞品分析:验证新研发的语言模型是否达到行业主流标准,并通过与其他模型的横向对比,发现自身优势与不足,为后续优化提供数据支持。
查看更多
最新文章
Go bytes.Clone 后修改原切片为什么不再影响副本
解释 Go bytes.Clone 为什么能让副本与原切片隔离,覆盖切片头、底层数组、长度容量以及 ni
tuozi工具箱有哪些文件与文本工具?JSON编辑器、剪贴板和批量重命名说明
tuozi工具箱产品站的插件区域展示JSON编辑器、剪贴板、文件批量重命名等入口,本文按公开页面说明这些
PHP 属性钩子怎么集中处理读写逻辑
PHP 8.4 属性钩子可以在属性边界集中处理校验、标准化和派生值,减少重复 getter/setter
Cloud Native Buildpacks 毕业后应用构建生态会怎么变
Cloud Native Buildpacks 成为 CNCF 毕业项目,核心意义不是突然增加某个命令,
动漫岛有哪些内容分类?治愈系、热血燃与搞笑萌入口说明
动漫岛产品站首页提供看番与读漫画入口,并按治愈系、热血燃、甜宠恋、搞笑萌等兴趣方向展示内容分类。本文说明
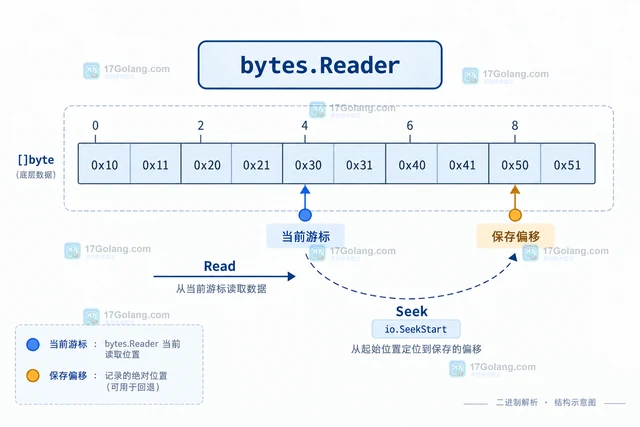
Go bytes.Reader 怎么实现可回退的二进制解析
用 Go bytes.Reader 保存绝对偏移、回退试读分支,并区分 Seek 越界、负位置、EOF