详细介绍
PubMedQA是什么
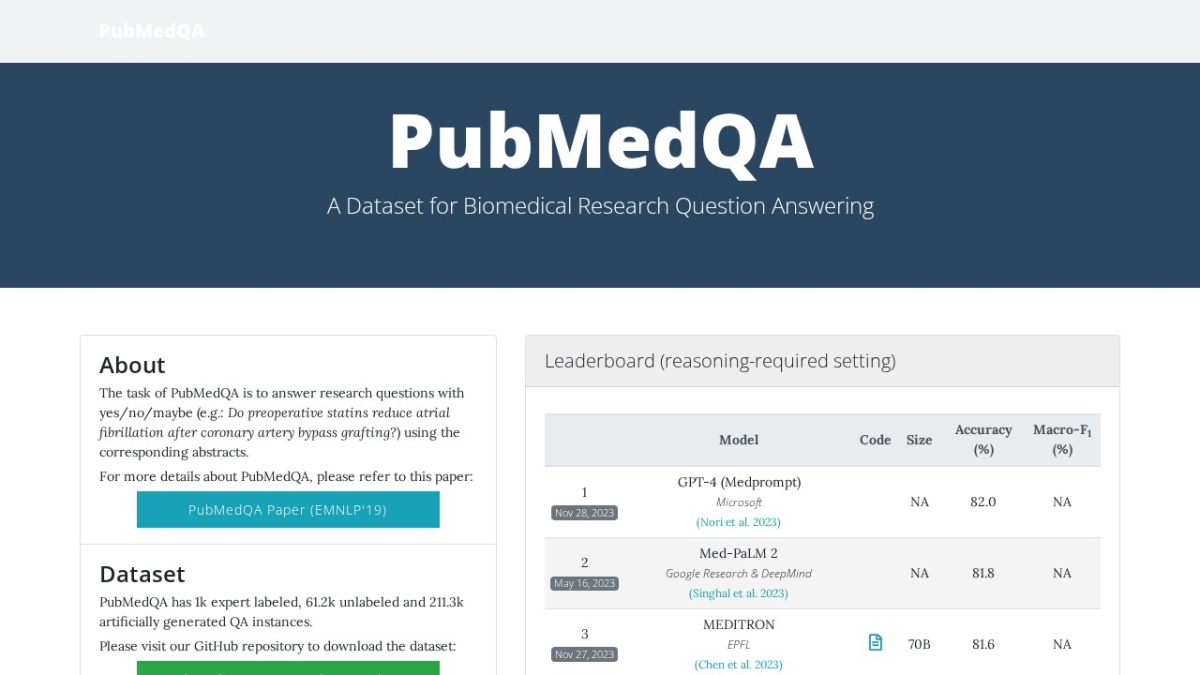
PubMedQA是一个专为生物医学研究领域设计的问答数据集。该数据集旨在通过文献摘要来回答具有“是/否/可能”性质的研究问题,例如评估“某种特定药物是否有效”。PubMedQA资源库中包含了1000个由专家精心标注的问答实例、61200个未标注实例以及211300个人工生成的问答对。它为研究人员提供了一个标准化的测试环境,专门用于开发和评估生物医学领域的自然语言处理(NLP)模型,从而显著提升模型对生物医学文献的理解深度及问答准确性。
PubMedQA的主要功能
- 提供高品质的生物医学问答数据:PubMedQA汇集了1000个专家标注样本、61200个未标注样本及211300个人工生成样本,为生物医学NLP研究提供了丰富且多样化的数据支持。
- 充当模型评估的标准基准:作为生物医学问答模型的标准化测试平台,PubMedQA通过公开各类模型的性能指标,协助研究者进行横向比较,进而推动模型的改进与优化。
- 促进生物医学信息的高效提取:该数据集赋能生物医学NLP研究,帮助从海量学术文献中迅速提炼关键信息,从而大幅提高科研工作的效率。
- 驱动生物医学NLP技术进步:凭借高质量的数据资源,PubMedQA推动了生物医学问答系统及文本理解技术的发展,为构建更智能的人工智能模型奠定了坚实基础。
如何使用PubMedQA
- 获取PubMedQA数据集:访问PubMedQA官方GitHub仓库(https://github.com/pubmedqa/pubmedqa),克隆代码库并下载所需的数据集文件。
- 熟悉数据集架构:加载数据文件并检查其结构,明确每个实例中包含的研究问题、对应答案以及相关文献摘要等关键要素。
- 执行数据预处理:对原始数据进行清洗和格式化,例如利用分词器将问题与摘要转化为模型可识别的输入格式,并提取相应的标签。
- 开展模型训练:选取合适的模型架构(如BERT、PubMedBERT等),使用预处理后的数据进行训练,并通过调整参数来优化模型表现。
- 实施模型评估在测试集上验证模型性能,计算准确率、F1分数等关键指标,以确认模型的有效性与可靠性。
- 提交结果至排行榜:遵循GitHub仓库中的“Submission”指引,将模型的预测结果及性能数据提交至PubMedQA官方排行榜,等待审核与排名。
- 借鉴排行榜优化策略:分析排行榜上高分模型的技术方案与性能表现,与自身模型进行对比,寻找差距并进一步迭代优化。
PubMedQA的应用场景
- 辅助临床决策:协助医生快速检索最新的研究成果,为诊断和治疗方案的制定提供有力支持。
- 加速医学研究:为科研人员提供精准的文献信息提取服务,缩短研究周期,加快科学发现进程。
- 赋能医学教育:作为高效的学习辅助工具,帮助医学生快速掌握生物医学领域的核心知识与前沿动态。
- 支持药物研发:助力制药企业及研究人员快速评估药物疗效及临床试验结果,提高研发效率。
- 构建智能医疗系统:集成于智能医疗平台中,基于最新研究成果为用户提供个性化的医疗建议与健康指导。
查看更多
最新文章
Go Benchmark报告allocs/op并定位临时对象来源的方法
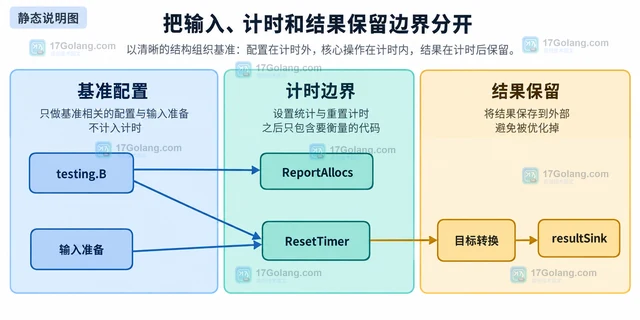
用 go test -benchmem 和 testing.B.ReportAllocs 读懂 B/op
Redis Sentinel故障转移期间客户端重连的配置方法
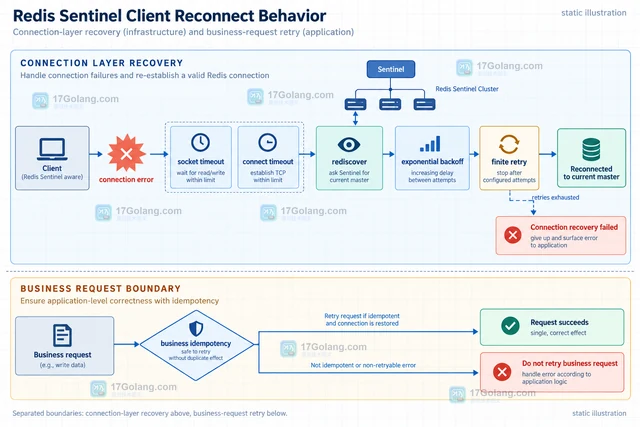
Redis Sentinel故障转移时,客户端不能继续依赖旧主节点地址。本文以服务发现、连接池、超时、退
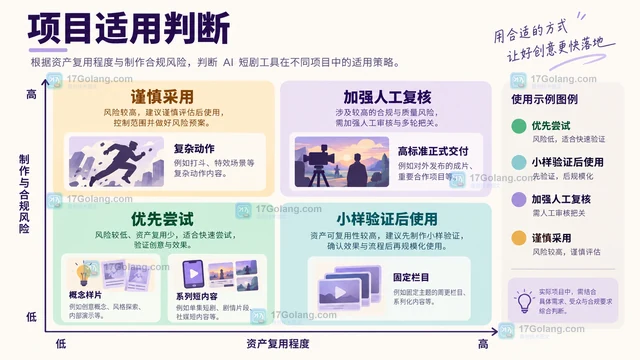
商汤Seko能做AI短剧工具吗?功能范围和适用场景
本文解答商汤Seko作为AI短剧工具的核心能力,拆解功能边界、适用场景与选型要点,为创作者和工作室提供实
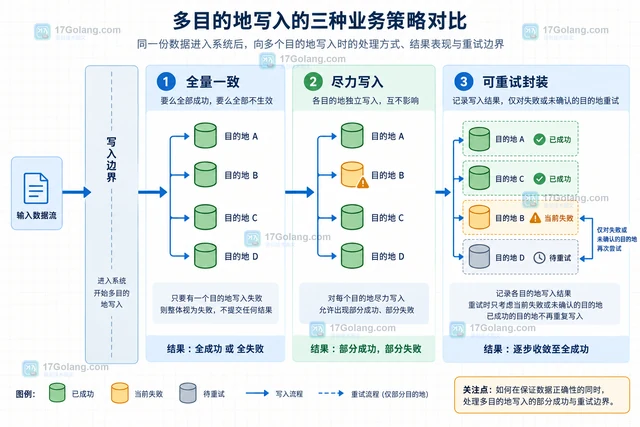
Go MultiWriter第一个Writer失败后其他Writer未完成的处理边界
Go io.MultiWriter按顺序写入多个Writer,首个错误会截断后续目标。本文用故障示例拆解
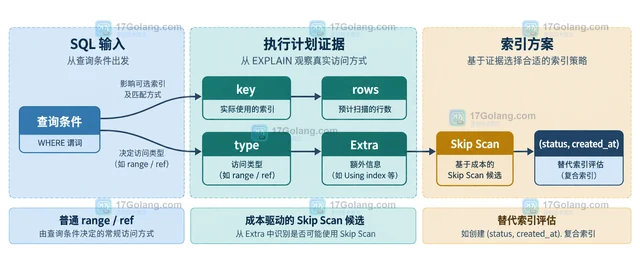
MySQL 复合索引跳过最左列时的访问边界
围绕 (tenant_id, status, created_at) 示例,说明跳过复合索引最左列后普通
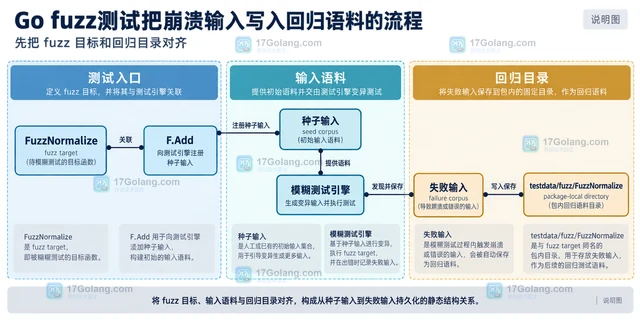
Go fuzz测试把崩溃输入写入回归语料的流程
Go fuzz 测试发现崩溃输入后,如何利用 testdata/fuzz 语料目录在普通 go test