详细介绍

ChatTTS:高效对话文本到语音转换解决方案
ChatTTS 是一个专门为对话场景设计的文本到语音(Text-to-Speech, TTS)生成模型,旨在为大型语言模型(LLM)助手的对话任务以及对话式音频和视频介绍提供高质量、自然的语音合成服务。它支持中文和英文,经过约1000万小时的中英文数据训练,确保了其在多语言环境下的出色表现。
核心优势:
- 多语言支持:ChatTTS能够处理包括中文和英文在内的多种语言,满足全球用户的需求。
- 大数据训练:通过大约1000万小时的中英文数据训练,ChatTTS能够生成高质量、自然流畅的语音。
- 对话任务优化:特别为对话应用优化,适用于大型语言模型的对话任务。
- 开源计划:项目团队计划开源一个训练基础模型,促进学术和开发社区的合作与创新。
- 安全与控制:致力于提高模型的可控性,添加水印,与LLM集成,确保使用安全。
主要功能:
- 优化对话场景:ChatTTS为对话应用进行了特别优化,支持中英文,提升对话体验。
- 高质量语音合成:通过大量数据训练,生成高质量、自然的语音,满足各种应用需求。
- 易用性:只需输入文本信息,即可生成相应的语音文件,操作简便。
使用示例:
- 从GitHub下载ChatTTS代码。
- 安装必要的依赖包,如torch和ChatTTS。
- 导入所需的库,包括torch、ChatTTS以及IPython.display的Audio。
- 初始化ChatTTS类并加载预训练模型。
- 定义要转换为语音的文本。
- 使用infer方法从文本生成语音。
- 使用IPython.display的Audio类播放生成的音频。
总结:
ChatTTS是一个功能强大的文本到语音模型,适用于需要对话功能的各种应用和服务。其多语言支持和大数据训练使其能够生成高质量和自然的语音。此外,ChatTTS的易用性和开源计划使其成为学术研究和开发社区的宝贵资源。开发者和用户可以通过提供的API和SDK轻松集成和使用ChatTTS,并且可以针对特定应用或声音进行定制。尽管ChatTTS功能强大,但也存在一些限制,如对输入文本的复杂性和长度的依赖,以及实时生成高质量语音所需的计算资源。项目团队不断更新和改进,以提高模型的性能。
查看更多
最新文章
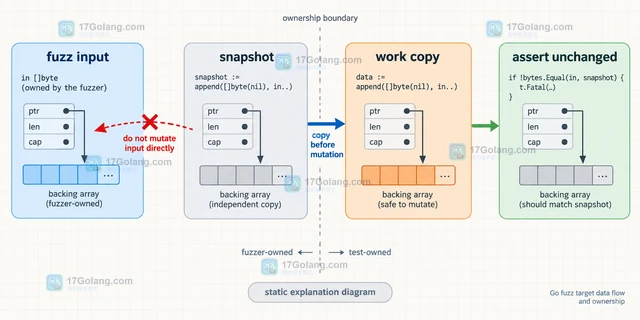
Go fuzz测试修改输入切片后影响后续用例的隔离方法
Go fuzz 测试遇到 []byte 被修改、后续用例结果漂移时,关键是建立输入所有权:保留原始快照,
照妖镜隐私权限怎么查看?相册、相机与网络权限核对说明
本文按公开产品资料页核对照妖镜工具箱的产品定位、权限项目与隐私检查方法,帮助安卓用户在安装和首次启动前明
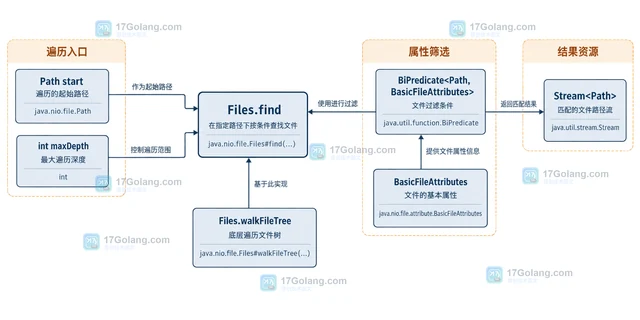
Java Files.find组合文件类型与大小条件的遍历方法
用 Java Files.find 组合普通文件、扩展名、大小和修改时间条件,掌握 maxDepth、B
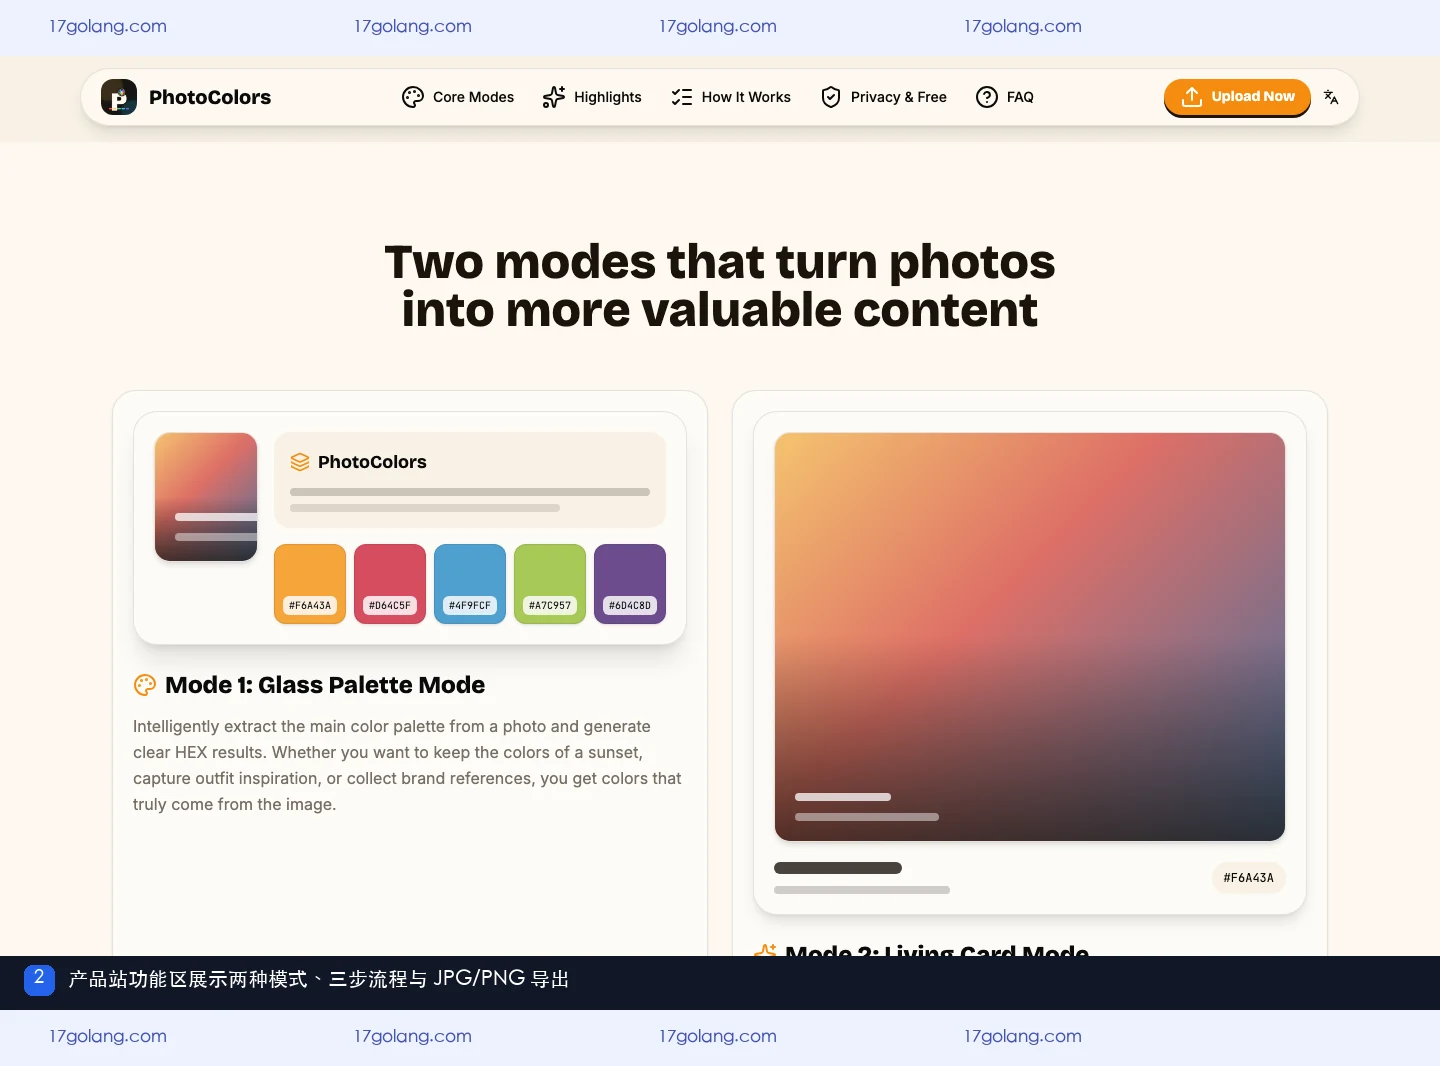
photocolors在线版怎么用?无需下载的色盘与记忆卡片流程说明
photocolors提供浏览器在线入口,可从照片提取主色和HEX代码,并在色盘模式、记忆卡片模式之间选
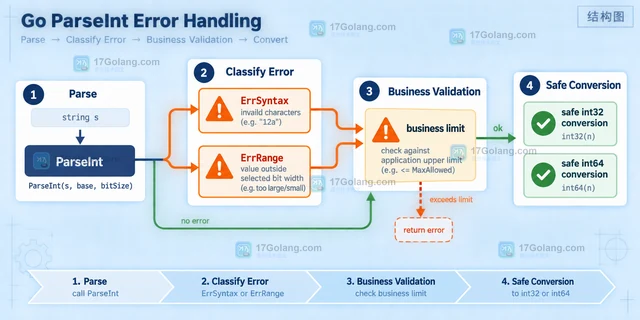
Go strconv.ParseInt处理边界数值和位宽的实现方式
用 Go strconv.ParseInt 按进制和位宽检查字符串整数,区分 ErrSyntax 与 E
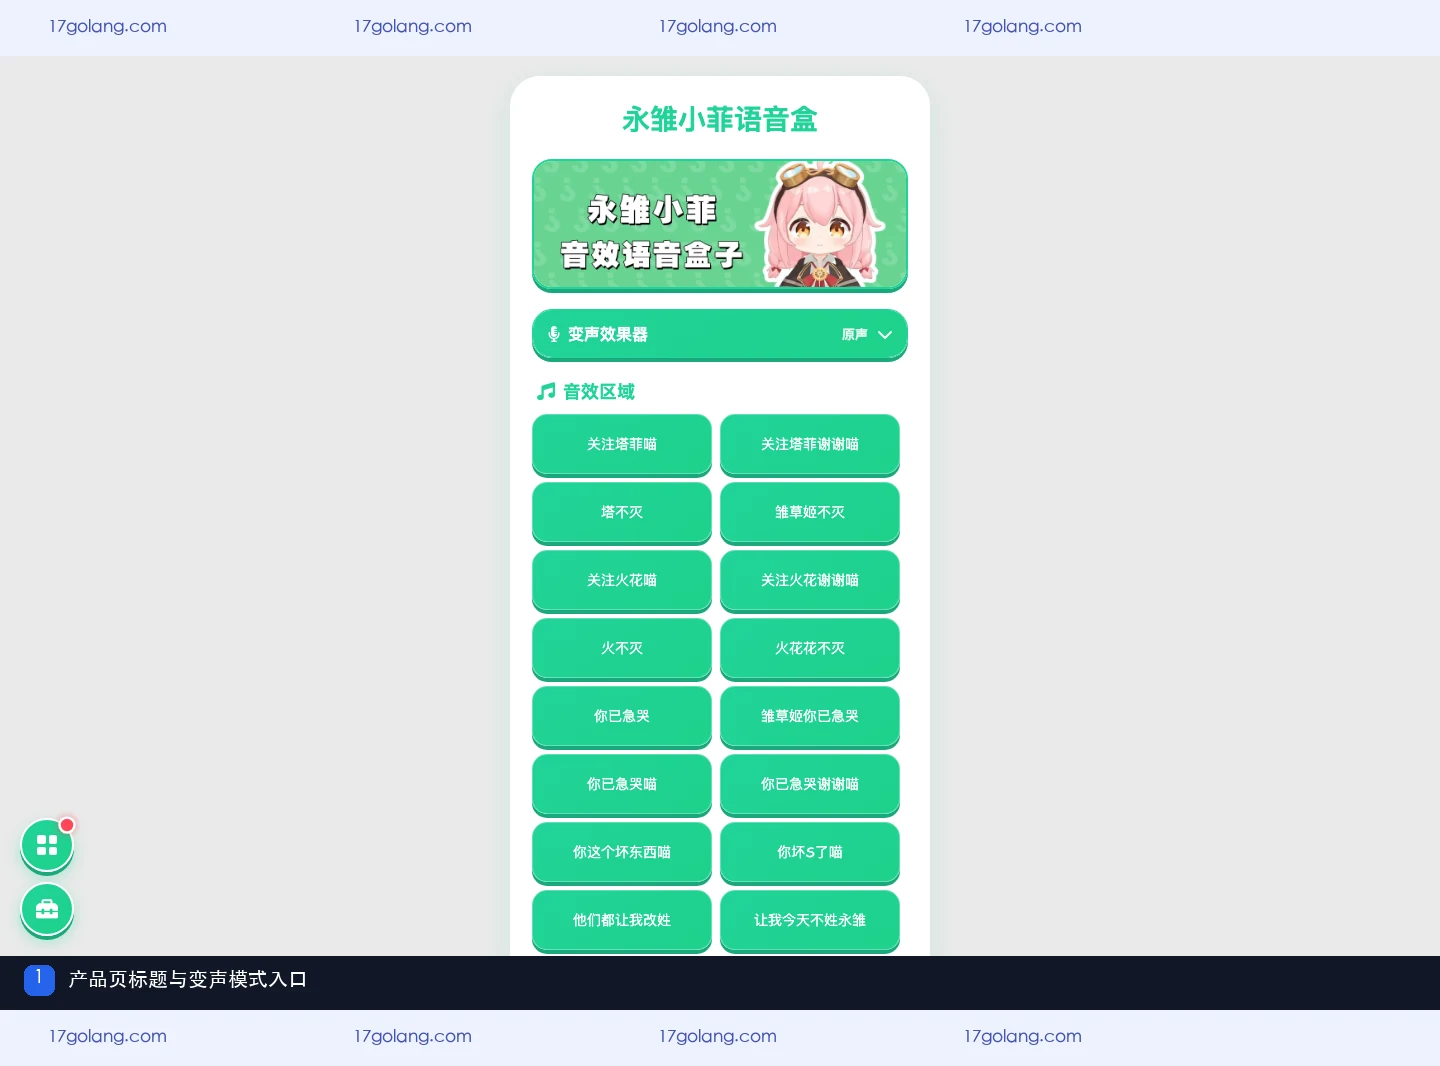
永雏小菲语音盒音乐区有哪些功能?音效分类、播放与循环设置说明
永雏小菲语音盒公开产品资料页展示了变声模式、音效区和音乐区,本文按页面可见内容说明分类、播放控制、延迟、