
Web Worker 怎样传输大数组减少复制
我在页面线程里把大数组交给 Web Worker 做解析时,最容易误判的一点是:把数据放进 postMessage() 并不等于把原来的内存直接交过去。普通结构化克隆会生成另一份数据;如果消息里是几十 MB 的二进制内容,复制本身就可能成为卡顿来源。
真正适合这个场景的写法是把底层 ArrayBuffer 同时放进消息对象和第二个参数的 transfer list。这样移动的是缓冲区的所有权,主线程发送完成后不再拥有它。
传输大数组时优先传TypedArray或包含它的消息,并在 transfer list 中写入它的.buffer。传输后,主线程的旧视图会失去底层内存,不能再当作可读写数组使用。
官方资料:https://developer.mozilla.org/en-US/docs/Web/API/Web_Workers_API/Transferable_objects
关键差别:复制的是视图,移动的是底层 ArrayBuffer
Uint8Array、Int32Array 这类对象是建立在缓冲区之上的视图。视图记录元素类型、偏移量和长度,但真正占用大块内存的是 ArrayBuffer。TypedArray 可以被结构化克隆,却不是可转移对象;它的 .buffer 才是可放入 transfer list 的资源。
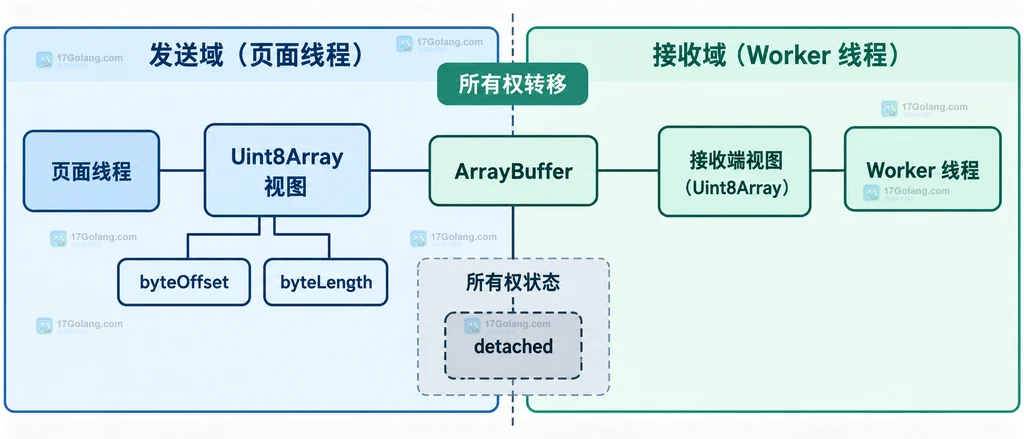
还有一个容易忽略的规则:transfer list 只说明哪些资源要移动,并不会自动把资源放进消息。下面两种信息必须对应:消息中能让接收端取得缓冲区,数组参数中声明这个同一个缓冲区要转移。
最小写法:把 buffer 放进 transfer 列表
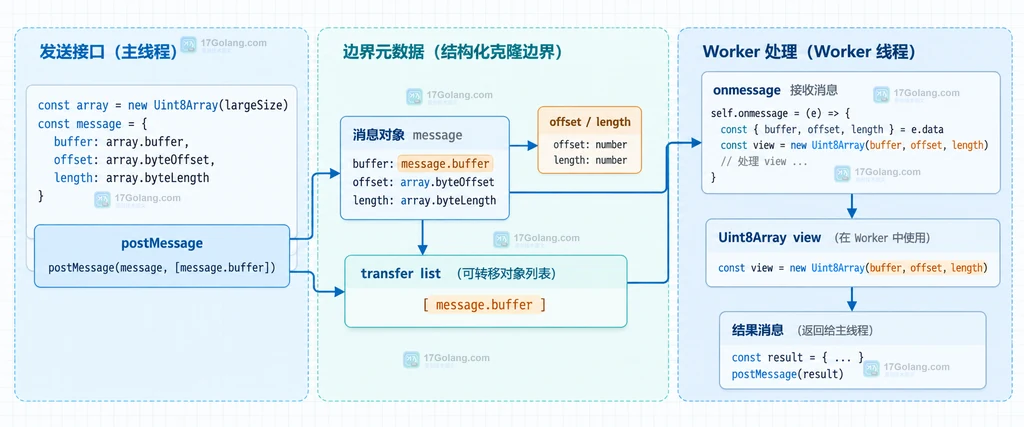
主线程可以把一个视图作为消息的一部分,同时把视图背后的缓冲区交给 Worker。示例中故意传递 offset 和 length,这样 Worker 不会误把整个底层缓冲区都当成有效区间。
// main.js:把大数组的所有权交给 Worker,发送后不要再使用 view
const worker = new Worker("worker.js", { type: "module" });
const buffer = new ArrayBuffer(16 * 1024 * 1024);
const view = new Uint8Array(buffer, 1024, 4096);

worker.postMessage(
  { buffer, offset: view.byteOffset, length: view.byteLength },
  [buffer], // 中文说明:第二个参数声明移动同一个底层缓冲区
);

// 中文说明:传输完成后原 buffer 已 detached,byteLength 会变为 0
console.log(buffer.byteLength);
// worker.js:接收已经转移所有权的缓冲区,再按元数据重建视图
self.onmessage = (event) => {
  const { buffer, offset, length } = event.data;
  // 中文说明:只读取消息声明的有效区间,避免误处理其他字节
  const input = new Uint8Array(buffer, offset, length);
  const checksum = input.reduce((sum, value) => (sum + value) % 65536, 0);

  // 中文说明:结果很小,直接复制回主线程即可;大块结果也可再次转移
  self.postMessage({ length: input.length, checksum });
};
Worker 取得的是同一块底层内存的所有权,而不是页面线程继续持有的一份共享副本。主线程后续如果需要保留原数据,应在发送前明确复制一份,不能指望 transfer 同时满足“零复制”和“发送端继续修改”这两个互相冲突的目标。
我实际最容易踩到的三个坑
第一,发送后继续读旧视图。转移成功后原 ArrayBuffer 被 detached,相关视图的长度也会变成 0;对它做读取、写入或部分方法调用可能抛出异常。需要继续使用的数据,应在 transfer 前复制,或把后续计算也放到 Worker 中。
第二,只传视图却没有传底层 buffer。把 view 放进消息能让结构化克隆处理它,但把 view 放进 transfer list 并不能代替 view.buffer。传输列表中的对象必须是可转移资源,并且资源还要能从消息对象到达接收端。
第三,忽略 byteOffset。一个视图可能只覆盖底层缓冲区的一段。若 Worker 直接执行 new Uint8Array(event.data.buffer),就可能把前后的无效字节也纳入处理。把偏移量和有效长度作为消息元数据,是比假设“视图从 0 开始”更稳妥的接口约定。
兼容与取舍:什么时候退回复制
业务代码可以先检测 Worker、postMessage 和 ArrayBuffer 是否存在,再选择转移路径。对于不支持 Worker 的环境,主线程直接处理或保留普通结构化克隆通常比强行模拟所有权移动更可靠。
// feature-check.js:能力不足时回到可读性更好的复制式路径
function sendBytes(worker, view) {
  if (typeof Worker === "undefined" || !(view.buffer instanceof ArrayBuffer)) {
    // 中文说明:没有 Worker 时交给当前线程处理,避免调用不存在的 API
    return processOnMainThread(view);
  }

  // 中文说明:转移后 view 不再归当前线程使用,调用方必须遵守所有权约定
  worker.postMessage({ buffer: view.buffer }, [view.buffer]);
  return undefined;
}
structuredClone(value, { transfer: [buffer] }) 也能表达“克隆消息结构、转移指定资源”,但它仍然会让原缓冲区失去所有权。SharedArrayBuffer 则是共享内存模型,不是 ArrayBuffer 的简单替代;它需要额外的跨线程同步与部署安全条件,不能仅因为想少一次复制就直接换用。
相关问题
问:为什么 transfer list 里不能直接写 Uint8Array?
答:TypedArray 是视图,不是可转移对象;通常把它的 .buffer 放入 transfer list。
问:传输是不是永远零复制?
答:ArrayBuffer 的所有权转移通常可以避免应用层再复制一份,但具体实现细节由浏览器负责,文章不能把它当成所有对象都零复制。
问:主线程还要保留原数组怎么办?
答:在发送前复制,或使用结构化克隆保留独立副本;不要在转移后继续依赖原视图。
 IntersectionObserver 怎样避免滚动监听抖动
- 上一篇
- IntersectionObserver 怎样避免滚动监听抖动
- 下一篇
- URLSearchParams 怎样保留重复查询参数
-
- 文章 · 前端 | 39分钟前 | 中文 · javascript · 前端开发 · JavaScript 文本处理 国际化 中文分词 Intl.Segmenter
- JavaScript Intl.Segmenter 怎样按中文词边界切分文本
- 102浏览 收藏
-
- 文章 · 前端 | 52分钟前 |
- URLSearchParams 怎样保留重复查询参数
- 499浏览 收藏
-
- 文章 · 前端 | 59分钟前 | IntersectionObserver 前端性能 rootMargin threshold 滚动监听抖动
- IntersectionObserver 怎样避免滚动监听抖动
- 477浏览 收藏
-
- 文章 · 前端 | 1小时前 | javascript · JavaScript Fetch ReadableStream 流式响应 TextDecoderStream
- JavaScript ReadableStream 怎样逐块处理响应
- 150浏览 收藏
-
- 文章 · 前端 | 1小时前 |
- JavaScript fetch 怎样设置超时并可取消
- 100浏览 收藏
-
- 文章 · 前端 | 1小时前 |
- CSS :has() 按表单校验状态切换父级样式
- 214浏览 收藏
-
- 文章 · 前端 | 1小时前 |
- Service Worker 怎样只缓存同源静态资源
- 189浏览 收藏
-
- 文章 · 前端 | 16小时前 |
- 前端 WebSocket 退避重连 怎样处理
- 278浏览 收藏
-
- 文章 · 前端 | 16小时前 |
- 前端 Vue watch 深度监听 怎样处理
- 192浏览 收藏
-
- 文章 · 前端 | 16小时前 | React 竞态 Fetch AbortController useEffect 前端异步
- 前端 React useEffect 竞态 怎样处理
- 107浏览 收藏
-
- 文章 · 前端 | 16小时前 |
- 前端 Vite alias 测试失效 怎样处理
- 483浏览 收藏
-
- 文章 · 前端 | 17小时前 |
- 前端 Vite 环境变量前缀 怎样处理
- 161浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 616次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 656次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 688次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 651次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 479次使用
-
- go zero微服务实战性能优化极致秒杀
- 2022-12-27 207浏览
-
- Go pprof 排查慢接口:别只会看火焰图,先把问题问对
- 2026-06-01 101浏览
-
- Go JSON v2 实战:别急着替换 encoding/json,先搞懂这些变化
- 2026-06-01 437浏览
-
- Go 1.25 容器感知 GOMAXPROCS:K8s 里别再让 CPU limit 偷偷拖垮 P99
- 2026-06-01 473浏览
-
- Go map 新实现实战:Swiss Tables 变快了,但别急着改业务代码
- 2026-06-01 218浏览


