
Python csv 换行字段 怎样处理
Python 的 csv 模块遇到字段内换行时,最稳妥的做法不是先把换行符替换成空格,而是让 CSV 解析器自己识别引号边界:读写文件时使用 newline='',让包含换行的字段保持在同一条记录里。写出时再根据接收方要求选择 lineterminator,不要把“字段里的换行”和“记录结束换行”混为一谈。
官方地址:https://docs.python.org/3.15/library/csv.html
一句话记住:newline=''交给csv模块处理通用换行;字段中的换行要放在带引号的 CSV 字段里;lineterminator只负责 writer 输出的记录结束符。
先分清三种“换行”
一条 CSV 记录可以跨越多行物理文本。例如备注字段是 第一行\n第二行,只要这个字段被双引号包住,它仍然属于同一条记录。文件本身还可能使用 \n 或 \r\n 作为记录结束符,写入层又有一个 lineterminator 设置。三者混在一起时,就会出现“读取多了一行”“Windows 下空行变多”这类现象。
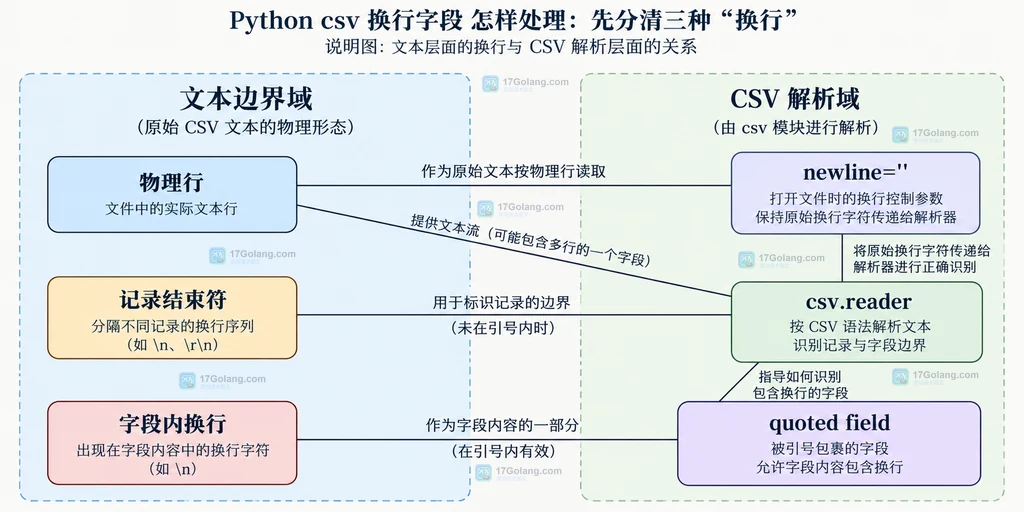
因此不要先用 splitlines() 拆文件,再把每行交给 csv.reader。那样会在解析器看到引号闭合之前截断字段,原本的一条记录就可能被拆成多条。
读取换行字段时为什么要写 newline=''
官方文档明确建议:传给 csv.reader 的文件对象应使用 newline='' 打开。如果省略它,带引号字段中的换行可能无法正确解释;在使用 \r\n 的平台写文件时,还可能得到额外的 \r。
import csv

def read_notes(path):
    # newline='' 让 csv 模块保留字段内换行并自行处理记录边界
    with open(path, "r", encoding="utf-8", newline="") as csv_file:
        reader = csv.DictReader(csv_file)
        for row in reader:
            # 备注字段里的换行会保留在同一条字典记录中
            yield row["name"], row["note"]

for name, note in read_notes("contacts.csv"):
    # 这里只展示读取结果,不要把换行字段先 split 成多条记录
    print(name, repr(note))
如果输入文件的编码不是 UTF-8,应明确传入对应的 encoding;编码问题和换行问题是两层不同的边界。DictReader 会把第一条记录作为字段名,后续每条记录映射成字典,适合导入带备注、描述等多行文本的表格。
写出字段内换行时让引号规则接管
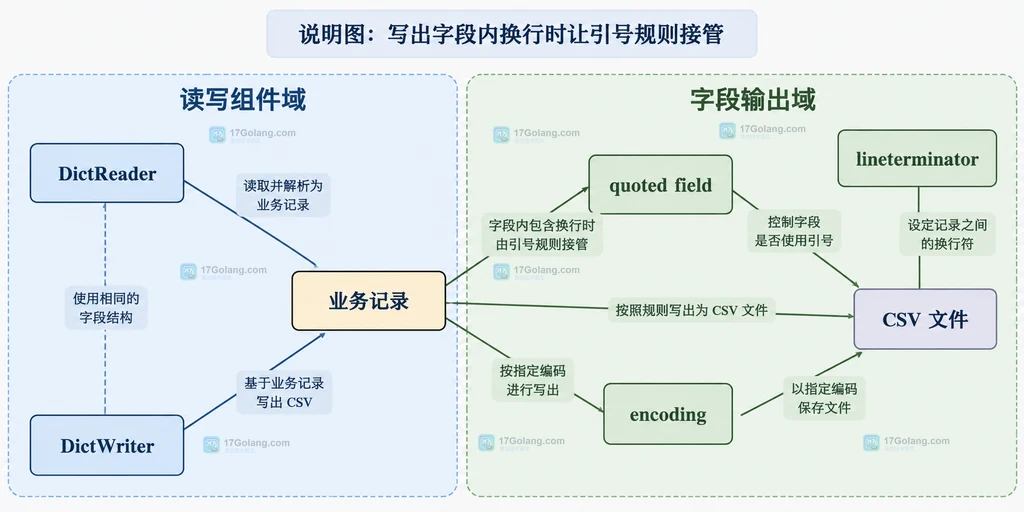
默认的 QUOTE_MINIMAL 会在字段包含分隔符、引号或换行时加引号。只要不要把 quoting 改成不适合当前数据的模式,csv.writer 就会把多行字段写成合法的 quoted field。lineterminator 决定每条记录写完后的结束符,但不会把字段内部的换行改成记录边界。
import csv

rows = [
    {"name": "小林", "note": "第一行备注\n第二行备注"},
    {"name": "小周", "note": "没有换行的备注"},
]

with open("contacts-out.csv", "w", encoding="utf-8", newline="") as csv_file:
    # 用换行空字符串避免文本层再次改写 CSV 的记录结束符
    writer = csv.DictWriter(csv_file, fieldnames=["name", "note"])
    writer.writeheader()
    # writer 会按 CSV 引号规则保护 note 中的换行
    writer.writerows(rows)
如果对接方明确要求 Unix 风格的记录结束符,可以设置 lineterminator="\n";如果对方要求其他方言,则应同时确认分隔符、引号和编码。不要用 QUOTE_NONE 处理含换行字段,除非你同时提供可用的 escapechar 并确认接收方支持这一套规则,否则 writer 可能抛出 csv.Error,或者下游无法还原字段边界。
导入代码里的三个收尾点
第一,涉及多行字段时不要用普通字符串分割代替 CSV 解析。第二,输入数据可能不规范时,可以把解析错误和行号一起记录:
import csv
import sys

def load_rows(path):
    # 保留 csv 模块的换行语义,并由调用方决定如何处理坏数据
    with open(path, "r", encoding="utf-8", newline="") as csv_file:
        reader = csv.reader(csv_file)
        try:
            for row in reader:
                # line_num 是物理行号,含换行字段时不等于记录数量
                yield row
        except csv.Error as exc:
            # 把解析位置带回日志,便于定位未闭合引号等输入问题
            raise ValueError(f"CSV 第 {reader.line_num} 行解析失败") from exc

try:
    for row in load_rows("contacts.csv"):
        print(row)
except ValueError as exc:
    print(exc, file=sys.stderr)
第三,reader.line_num 统计的是读过的物理行数,不是返回的记录条数;一个字段跨三行时,这个差异是正常的。若业务只允许单行备注,应在解析完成后检查字段值并明确拒绝,而不是依赖换行拆分来“清洗”。
常见问题
为什么读取 CSV 后备注被拆成两条记录?
通常是输入字段没有正确使用引号,或者代码先按物理行拆分再交给 CSV 解析器。先确认多行字段被双引号包住,再用 open(..., newline="") 直接交给 csv.reader 或 DictReader。
为什么写出的文件每条记录之间像多了一个空行?
常见原因是写文件时没有指定 newline="",文本层和 CSV writer 同时转换了记录结束符。固定使用 newline="",需要时再显式设置 lineterminator。
处理 Python CSV 换行字段时,核心是保持三层职责清晰:文本文件负责编码和原始换行,csv 模块负责引号与记录解析,业务代码负责字段校验。这样既能保留备注中的换行,也能避免把物理行数误当成记录数量。
 Python pathlib 替换文件 怎样处理
- 上一篇
- Python pathlib 替换文件 怎样处理
- 下一篇
- Python logging 请求 ID 怎样处理
-
- 文章 · python教程 | 1小时前 | 开发环境 · python · Python 虚拟环境 pip pyproject.toml editable install
- Python editable install 更新 怎样处理
- 356浏览 收藏
-
- 文章 · python教程 | 1小时前 |
- Python 进程池异常 怎样处理
- 319浏览 收藏
-
- 文章 · python教程 | 1小时前 |
- Python logging 请求 ID 怎样处理
- 377浏览 收藏
-
- 文章 · python教程 | 1小时前 |
- Python pathlib 替换文件 怎样处理
- 188浏览 收藏
-
- 文章 · python教程 | 1小时前 |
- Python TypeGuard 类型收窄 怎样处理
- 212浏览 收藏
-
- 文章 · python教程 | 1小时前 | python · Python 可变默认值 dataclass default_factory
- Python dataclass 默认工厂 怎样处理
- 488浏览 收藏
-
- 文章 · python教程 | 1小时前 | 异步编程 · Python教程 · asyncio · Python 清理 asyncio CancelledError TaskGroup Task.cancel
- Python asyncio 取消清理 怎样处理
- 410浏览 收藏
-
- 文章 · python教程 | 13小时前 | 热点分析 Python 3.15 Tachyon profiling.sampling 采样分析器
- Python 3.15 sampling profiler 怎样采集热点
- 340浏览 收藏
-
- 文章 · python教程 | 20小时前 |
- Python csv.Sniffer 怎样减少小样本分隔符误判
- 389浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 587次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 623次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 657次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 625次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 439次使用
-
- Go encoding/csv 处理不齐列文件:FieldsPerRecord、LazyQuotes 与逐行错误定位
- 2026-08-09 216浏览
-
- Go 怎么按指定顺序合并多个文本文件
- 2026-09-06 120浏览
-
- Go encoding/xml 怎么用 CharData 读取混合文本而不丢空白
- 2026-09-08 168浏览
-
- Go encoding/csv 怎么保留字段里的换行
- 2026-09-08 434浏览
-
- Go encoding/csv 遇到不齐列数据怎么保留记录
- 2026-09-09 203浏览


