
MySQL 复制延迟区分线程 怎样处理
MySQL 复制延迟区分线程 怎样处理
MySQL 复制延迟要先分清接收侧和应用侧:接收线程负责从源端取得事件,应用侧负责在副本执行;并行复制还要分别看协调线程与工作线程。不能只凭 Seconds_Behind_Source,或看到 IO、SQL 都是 Yes,就直接认定网络或磁盘故障。正确做法是按通道保留各线程状态、错误和事务进度,再决定调查方向。
下面组织一个小型“只读复制状态报告”:输入副本实例和通道名,输出接收、协调、工作线程三组记录,以及一次后续采样的变化。范围限定 MySQL 8.4 传统异步复制,不覆盖 Group Replication 的完整诊断。文中的 SQL 未在本地数据库运行,不附虚构现场数据。官方入口:https://dev.mysql.com/doc/refman/8.4/en/show-replica-status.html。
先定义报告里的三个职责边界
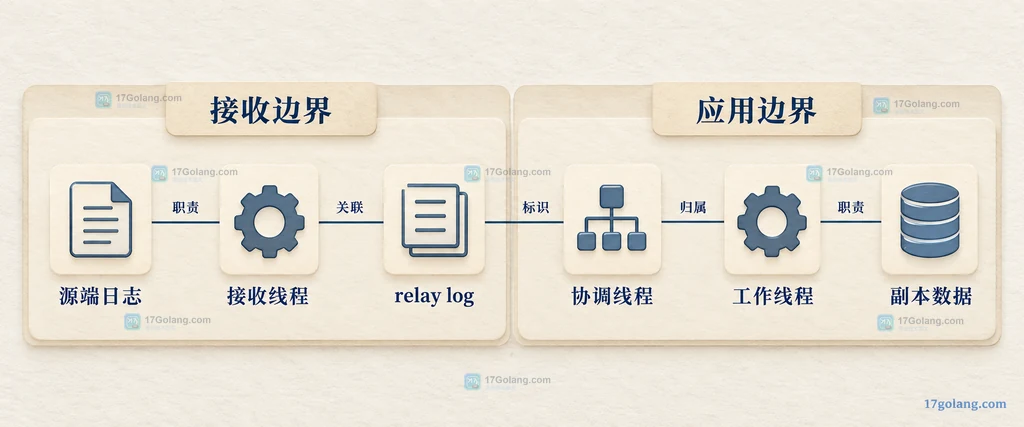
接收侧从源端二进制日志接收事件并写入 relay log;并行应用侧由协调线程分配工作,工作线程执行事务。报告按 CHANNEL_NAME 组织,不把不同源、不同通道的错误和进度混在一起。
静态结构中,源端日志与接收线程有关,接收线程与 relay log 有关,协调线程与 relay log、工作线程有关,工作线程负责副本数据的应用。图中的关系线只表达职责依赖,不表示这些组件总在某个固定顺序串行执行。
本项目只做观察与分类,不自动重启复制、跳过事务、重置元数据或改并行度。延迟本身不是足够的修改依据,数据一致性错误尤其不能用“先跳过去”处理。
准备通道名与一次可比较的采样
-- 在目标副本连接中记录实例和采样时间;默认通道名为空字符串。
SELECT NOW(6) AS sampled_at, @@server_uuid AS replica_uuid,
       @@version AS mysql_version;
SET @channel_name = '';

-- 查看当前连接对应副本的通道总览,不修改复制状态。
SHOW REPLICA STATUS;
SET 在这里只设置当前连接的用户变量,不修改服务器复制配置。后续 SELECT 必须在同一连接执行;连接池切换连接时应重新设置变量,或改用驱动参数绑定通道名。SHOW 的多通道输出可能有多行,要选中与你的 CHANNEL_NAME 相同的那一行。
由管理员配置合适的监控权限;SHOW REPLICA STATUS 需要相应复制查看权限,Performance Schema 查询还取决于账号授权和实例配置。查询报权限错误应保留失败信息,不能把“没有读到状态”当作线程停止或健康。记录时不要把连接凭据、完整业务语句或内部地址公开。
每份报告至少保存实例 UUID、版本、采样时间、通道、查询是否成功。几组状态表不是同一个冻结快照,采集期间线程可能继续变化;需要在记录中保留这个限制。
接收、协调、工作线程分别采集
-- 接收侧:每个通道一行,错误字段必须与服务状态一起记录。
SELECT CHANNEL_NAME, THREAD_ID, SERVICE_STATE,
       LAST_ERROR_NUMBER, LAST_ERROR_MESSAGE, LAST_ERROR_TIMESTAMP,
       RECEIVED_TRANSACTION_SET
FROM performance_schema.replication_connection_status
WHERE CHANNEL_NAME = @channel_name;

-- 协调侧:并行复制中负责工作分配,不代表所有工作线程都无异常。
SELECT CHANNEL_NAME, THREAD_ID, SERVICE_STATE,
       LAST_ERROR_NUMBER, LAST_ERROR_MESSAGE, LAST_ERROR_TIMESTAMP
FROM performance_schema.replication_applier_status_by_coordinator
WHERE CHANNEL_NAME = @channel_name;

-- 工作线程逐行保留,不能只取一行或用 MAX 状态替代。
SELECT CHANNEL_NAME, WORKER_ID, THREAD_ID, SERVICE_STATE,
       LAST_ERROR_NUMBER, LAST_ERROR_MESSAGE, LAST_ERROR_TIMESTAMP,
       LAST_APPLIED_TRANSACTION, APPLYING_TRANSACTION,
       APPLYING_TRANSACTION_START_APPLY_TIMESTAMP
FROM performance_schema.replication_applier_status_by_worker
WHERE CHANNEL_NAME = @channel_name
ORDER BY WORKER_ID;
接收侧的 SERVICE_STATE 表示该接收服务的状态;结合 LAST_ERROR_NUMBER、MESSAGE 和 TIMESTAMP 看是否发生停止或连接问题。RECEIVED_TRANSACTION_SET 是收到的事务集合,在使用 GTID 的场景可作为进度线索,但其字符串长度不是积压事务数。
协调侧和工作侧的 ON 表示线程存在,可能正忙也可能空闲,并不等于“没有延迟”。协调线程的概览也不能替代每个工作线程的状态。逐个保留 WORKER_ID,才能发现只有某个工作线程持续处理同一事务的情况。
工作侧的 APPLYING_TRANSACTION 表示正在应用的 GTID,LAST_APPLIED_TRANSACTION 表示该工作线程最近应用的事务。前者为空不自动等于故障,可能是空闲;起始时间较早也不能直接断言死锁,还要看后续样本和等待信息。非 GTID 环境不能强行把这些事务字段当作完整进度依据。
用线程标识补充等待状态
-- THREAD_ID 与 Performance Schema 的 THREAD_ID 关联,不是连接 ID。
SELECT w.CHANNEL_NAME, w.WORKER_ID, w.THREAD_ID,
       w.SERVICE_STATE, w.APPLYING_TRANSACTION,
       t.PROCESSLIST_ID, t.PROCESSLIST_STATE
FROM performance_schema.replication_applier_status_by_worker AS w
LEFT JOIN performance_schema.threads AS t
  ON t.THREAD_ID = w.THREAD_ID
WHERE w.CHANNEL_NAME = @channel_name
ORDER BY w.WORKER_ID;
CHANNEL_NAME 把同一复制通道的记录归组,WORKER_ID 区分工作槽位,THREAD_ID 用于关联 performance_schema.threads。后者提供 PROCESSLIST_ID 和 PROCESSLIST_STATE;不要拿 PROCESSLIST_ID 直接连接 THREAD_ID。线程退出、监控可见性不足等情况都可能使关联列为空,所以这里使用 LEFT JOIN 保留原工作线程记录。
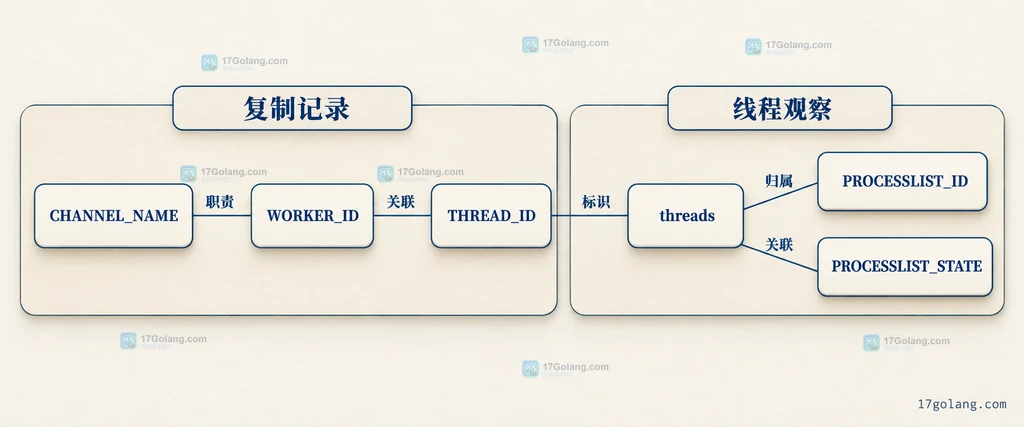
如果观察到锁等待状态,再结合受授权的锁等待信息调查阻塞者;若是提交顺序或依赖等待,应分析事务依赖,而不是把等待的工作线程数量当作 CPU 不足的证明。没有等待记录也不能排除磁盘、CPU 或采集配置问题。这份报告给出的是下一步方向,不是自动根因裁定。
整理成报告,再按证据选择处理范围
| 观察组合 | 优先调查方向 | 不能直接下的结论 |
|---|---|---|
| 接收连接异常,并有对应错误时间 | 源端可用性、链路、认证及连接限制 | 不是所有延迟都由网络导致 |
| 接收有进展,应用侧出现错误停止 | 具体工作线程错误、相关事务与数据一致性 | 重启不能自动修复冲突数据 |
| 接收持续前进,某个工作线程长期不变 | 大事务、等待、资源和依赖证据 | 不能仅凭这一项就增加工作线程 |
| 各线程 ON,业务仍读到旧值 | 端到端延迟、路由、通道和数据范围 | ON 不代表业务已追平 |
报告集成时保留原始状态与判断理由,而不是只生成一个“延迟正常”布尔值。可用已有采集器按业务允许的间隔重复查询,避免无限轮询和高频刷屏;每个样本保留独立时间。连接中断、字段不存在和权限不足要作为采集失败单独上报。
只有收集到对应证据后,才讨论具体处理:连接错误由负责源端或链路的人员修复;应用报错先解释事务和数据差异;工作线程等待先确认阻塞及影响。停止复制、终止连接、重建副本、调整并行配置都属于有影响的操作,不应由这份只读报告擅自执行。
恢复要看进度变化,不能只看一个零
Seconds_Behind_Source 是有条件的时间指示,不是所有事务从源提交到副本可见的完整度量。接收较慢、应用却已处理完当前 relay log 时,数值可能为零;NULL 也不能转换成零当作成功。源端和副本时钟变化、级联复制及并行提交都可能影响解读。
完成报告后,读者应能够回答:采的是哪个实例和通道,哪个线程存在异常,错误是什么时候出现的,事务或位置是否有持续进展,还有哪些信息缺失。恢复时要结合新的进度样本、错误时间与业务允许的读一致性确认,而不是看到旧错误文本仍在就断言仍失败,或只看到线程恢复 ON 就宣布所有数据一致。
SQL 线程是 Yes,为什么还落后?线程存在不等于处理能力足够,可能仍在执行、等待或按依赖提交;需要工作线程级观察。
某个工作线程空闲,是否该增加并行度?不能这样推断。空闲可能没有可分配任务,也可能任务之间有依赖;增加数量不保证单个大事务能被拆开。
没有查询结果就是没有复制吗?先核对通道过滤、实例身份、权限、配置及查询错误。报告应把“未配置”“未观察到”和“采集失败”区分开。
 MySQL INTERSECT 怎样合并两组去重结果
- 上一篇
- MySQL INTERSECT 怎样合并两组去重结果
- 下一篇
- MySQL LOAD DATA 读取 CSV 怎样处理
-
- 数据库 · MySQL | 48分钟前 | 连接池 · 故障排查 · MySQL教程 · mysql 连接池 wait_timeout database/sql SetConnMaxIdleTime SetConnMaxLifetime 空闲连接 PingContext
- MySQL 连接池空闲连接失效 怎样处理
- 350浏览 收藏
-
- 数据库 · MySQL | 49分钟前 | MySQL · 数据库 · csv · 数据导入 · CSV导入 MySQL LOAD DATA LOAD DATA LOCAL INFILE MySQL批量导入
- MySQL LOAD DATA 读取 CSV 怎样处理
- 307浏览 收藏
-
- 数据库 · MySQL | 52分钟前 |
- MySQL INTERSECT 怎样合并两组去重结果
- 358浏览 收藏
-
- 数据库 · MySQL | 56分钟前 |
- MySQL COERCIBILITY 怎样判断表达式使用哪个排序规则
- 361浏览 收藏
-
- 数据库 · MySQL | 59分钟前 |
- MySQL JSON 查询数组对象 怎样处理
- 467浏览 收藏
-
- 数据库 · MySQL | 1小时前 |
- MySQL 联合索引没有命中 怎样处理
- 415浏览 收藏
-
- 数据库 · MySQL | 1小时前 | MySQL · 执行计划 · sql优化 · mysql explain ANALYZE TABLE
- MySQL EXPLAIN 看行数偏差 怎样处理
- 437浏览 收藏
-
- 数据库 · MySQL | 1小时前 |
- MySQL CTE 拆分复杂查询 怎样处理
- 413浏览 收藏
-
- 数据库 · MySQL | 1小时前 | MySQL · JSON · 故障排查 · mysql JSON数组 JSON_TABLE NESTED PATH SQL排查
- MySQL JSON_TABLE 嵌套数组为空时为什么还会返回一行
- 437浏览 收藏
-
- 数据库 · MySQL | 1天前 | MySQL · JSON · 性能优化 · mysql 部分更新 JSON_SET JSON_STORAGE_FREE
- MySQL JSON 部分更新什么时候真的生效
- 132浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 583次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 621次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 655次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 622次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 436次使用
-
- MySQL JSON_TABLE 展开数组时如何保留缺失字段
- 2026-09-10 501浏览
-
- MySQL 分区表怎么处理跨分区唯一键:分区列约束与建表取舍
- 2026-08-30 501浏览
-
- MySQL权限管理设置全攻略
- 2026-03-29 501浏览
-
- MySQL分片实现方法及常见方案解析
- 2025-06-24 501浏览
-
- MySQL表空间碎片怎么清理?超详细优化教程
- 2025-06-13 501浏览


