
Go MultiWriter 为什么一个输出失败仍继续写
Go MultiWriter 为什么一个输出失败仍继续写
io.MultiWriter 在同一次 Write 中遇到某个 Writer 返回错误,会立即返回,不会继续调用列表中后面的 Writer。看到“失败后仍有输出”,通常要区分:输出来自失败之前的目标、外层再次调用了 Write,还是缓冲或异步组件当时没有把错误返回出来。它不会自动停止业务循环,更不会回滚已写数据。
设想订单记录同时显示在内存预览、写入归档端,并保留第三份副本。归档失败后,预览仍有一条记录,并不证明 MultiWriter 忽略错误。下面从旧调用方式迁移到显式错误传播;这不是声称某次 Go 版本升级改变了语义。官方文档入口:https://pkg.go.dev/io#MultiWriter。
需要迁移的是调用方的失败策略
本例只讨论同步 io.Writer 的一次写入及其调用者,不把消息入队成功当成最终保存成功。先明确需求:任一目标同步报错后,当前业务函数应返回错误;已经接受的数据允许保留;不自动重试。若你要求“所有目标全部提交,或全部撤销”,MultiWriter 不是事务接口,改调用顺序也不能实现这个要求。
这次改造不更换标准库 API,而是把“调用写入后继续处理”改成“读取 n 和 err,并由上层决定是否继续”。它可能使以前被忽略的错误真正影响业务返回值,因此上线时要确认调用者不会重新吞掉错误。
先把单次写入、缓冲与后续调用分开
| 观察到的现象 | 实际边界 | 改造重点 |
|---|---|---|
| 前面的目标已有内容,后面的目标报错 | 前面已完成的副作用不会撤销 | 不要把错误返回理解为全局零写入 |
| 失败后下一条记录又出现 | 外层可能发起新的 Write | 业务循环显式返回或选择降级 |
| Write 没报错,Flush 才失败 | 缓冲层先接受了字节 | 把 Flush 错误纳入结果 |
| 异步目标稍后失败 | 入队与最终投递是两个事件 | 另建完成回执或错误通道 |
MultiWriter 按参数列表同步写入。某个目标返回非空 err 时,本次调用在该处结束;若它无错误却返回不足长度,MultiWriter 会返回 io.ErrShortWrite。返回的 n 不是所有目标累计字节数,也不能概括每个目标已接收多少;遇错时它来自出错或短写的那个目标。
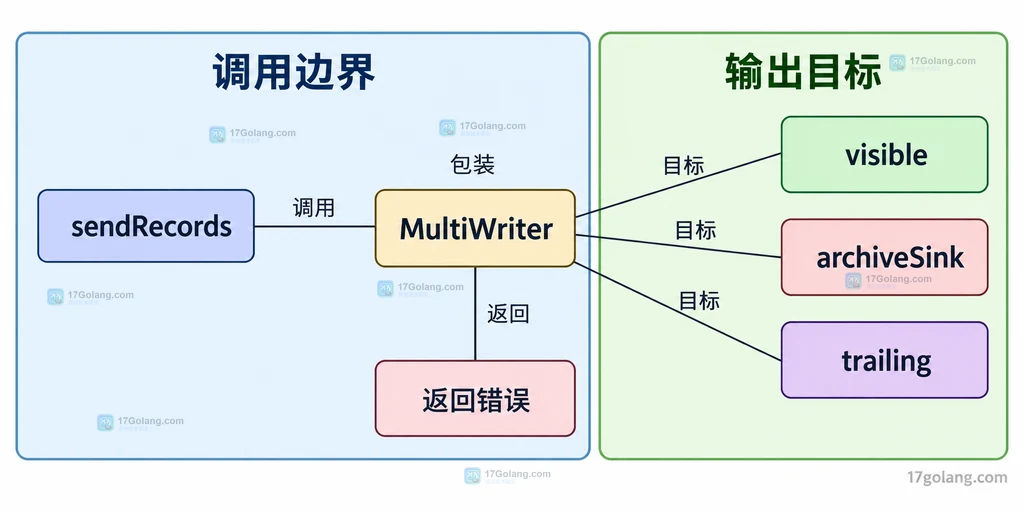
旧写法为什么会产生继续写的假象
将 Write 的两个返回值都丢弃,外层循环自然会进入下一轮。MultiWriter 没有“失败后永久关闭”的状态,下一次调用仍会从列表开头尝试;已经成功的前置目标可能不断接收新内容,而某个后置目标持续失败。
日志包装也需要关注返回签名。log.Logger.Print 或 Printf 不向调用者返回 error,不能因为业务代码没有接到 err 就判断底层成功;需要显式获得写入错误时,可根据接口选用返回 error 的 Logger.Output,或直接使用自己可控的 io.Writer 调用。不能一概认为所有日志库都采取相同策略。
另一个误区是整条数据无条件重试。若 visible 已接受完整记录,archiveSink 才失败,再对同一 MultiWriter 重发整条,会使 visible 重复。对审计、归档等场景,应先设计记录 ID、各目标确认状态和幂等策略,而不是仅根据 n 从原始数据切一个公共后缀重试。
新写法把错误带回业务函数
下面的单文件示例使用三个自定义或内存目标,不涉及实际磁盘和网络。archiveSink 通过同步返回错误模拟归档不可用;sendRecords 是唯一持有记录循环的业务入口。
package main

import (
    "bytes"
    "errors"
    "fmt"
    "io"
)

var errSink = errors.New("archive unavailable")

type archiveSink struct {
    calls int
}
func (s *archiveSink) Write(p []byte) (int, error) {
    s.calls++
    // 模拟归档端同步失败,没有接收本次数据。
    return 0, errSink
}

func sendRecords(dst io.Writer, records []string) error {
    for _, record := range records {
        p := []byte(record + "\n")
        n, err := dst.Write(p)
        if err != nil {
            // 停止的是业务循环,不能仅依赖 MultiWriter 内部短路。
            return fmt.Errorf("record %q: wrote %d: %w", record, n, err)
        }
        if n != len(p) {
            return io.ErrShortWrite
        }
    }
    return nil
}

func main() {
    var visible, trailing bytes.Buffer
    archive := &archiveSink{}
    // 顺序有实际影响:失败前的 visible 不会被撤销。
    dst := io.MultiWriter(&visible, archive, &trailing)
    err := sendRecords(dst, []string{"order=R7", "order=R8"})
    fmt.Printf("archive calls=%d, trailing bytes=%d\n",
        archive.calls, trailing.Len())
    fmt.Printf("visible=%q, archive failure=%v\n",
        visible.String(), errors.Is(err, errSink))
}
按代码推导,archive.calls 应为 1,trailing.Len() 应为 0,visible 只含 order=R7\n,错误链能够匹配 errSink。第二条 order=R8 不应进入写入,因为 sendRecords 已返回。这些是供读者运行时对照的预期,并非本文已执行的日志。
对照现象时要同时看三项:前置目标是否收到第一条、后置目标有没有被调用、外层是否又送入第二条。只看一个目标有无文字,无法区分短路与重复调用。实际工程应由顶层调用者记录错误或选择退出,不能只打印错误后无条件继续。
缓冲输出必须单独处理 Flush
如果用 bufio.Writer 包住归档端,MultiWriter 实际调用的是 buffered,而不是直接调用归档存储。当缓冲区有足够空间时,一次小写入可能成功进入缓冲,随后 visible 也被调用;直到 Flush 才接触到底层故障。并非所有写入都延迟,缓冲填满或大块数据也可能在 Write 时触发底层调用。
// 此片段放入已有返回 error 的函数内;需要导入 bufio、fmt 和 io。
buffered := bufio.NewWriter(archive)
dst := io.MultiWriter(buffered, visible)
if _, err := dst.Write([]byte("order=R7\n")); err != nil {
    return fmt.Errorf("write record: %w", err)
}
// Write 成功只代表缓冲层接受,必须单独收集 Flush 错误。
if err := buffered.Flush(); err != nil {
    return fmt.Errorf("flush archive: %w", err)
}
这个片段中的 archive 和 visible 代表已有 io.Writer。若 Write 阶段已失败,上面的策略立即返回,不再强制 Flush;实际业务若要求尽力保存残留缓冲,应显式设计清理和多错误汇总,不能把错误处理藏在不检查结果的 defer 中。MultiWriter 自身不会统一调用各目标的 Flush、Close 或文件 Sync,它只组合写入接口;Flush 也不等于已经持久化到物理介质。
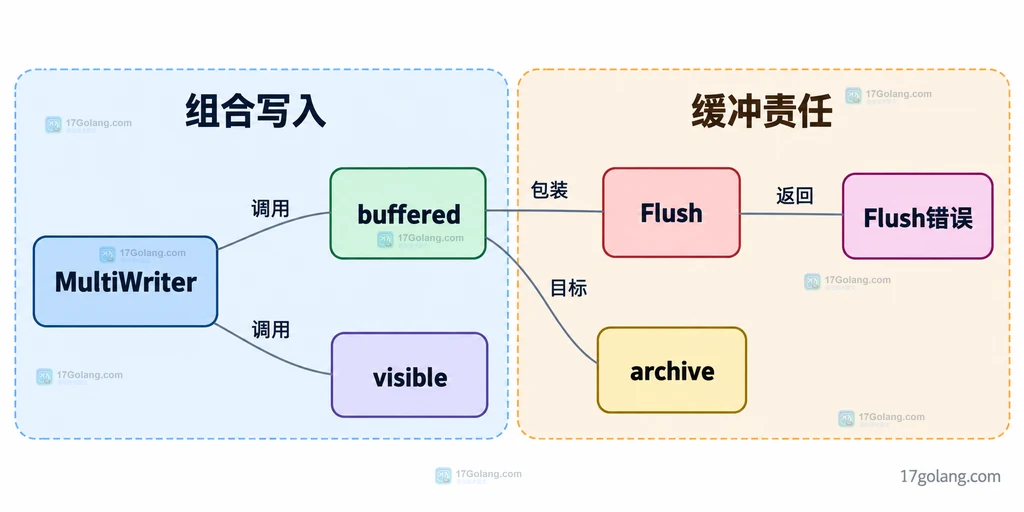
回归时同时检查内容、调用次数和返回值
迁移前后建议覆盖五种独立情况:所有目标成功;首个目标失败;中间目标失败;某目标短写;缓冲在刷新时失败。中间失败的场景还要检查前置副作用仍存在、后置目标未被调用,避免把“无回滚”误当成“仍继续向后写”。本文没有运行这些测试,示例仅提供确定的输入和预期。
能否让一个失败后仍尝试所有目标?可以另写尽力分发逻辑,逐个调用并汇总各目标结果,但那是不同的契约,不是给 MultiWriter 加一个忽略错误开关。每个目标的字节数和错误都应独立记录。
把最重要的目标放前面就可靠了吗?只能改变某次失败时哪些目标已被尝试,不能保证全体一致、持久化或自动重试。并发调用还需额外保证共享目标和整次组合写入的同步;MultiWriter 不会自动提供全局互斥。
迁移后怎样避免二次丢错?让每层调用者都明确处理返回值,把 Flush 等资源操作纳入结束策略,并确认业务是否允许部分成功。对当前问题,先坚持一条判断线:同次 Write 遇错会短路,之后仍有内容要从前置副作用、包装层和外层新调用解释。
 Go 反射为什么修改字段没有生效
- 上一篇
- Go 反射为什么修改字段没有生效
- 下一篇
- Go 接口为什么看起来不是 nil
-
- Golang · Go问答 | 48分钟前 |
- Go 接口为什么看起来不是 nil
- 163浏览 收藏
-
- Golang · Go问答 | 51分钟前 |
- Go 反射为什么修改字段没有生效
- 101浏览 收藏
-
- Golang · Go问答 | 52分钟前 |
- Go gzip 为什么生成文件无法解压
- 488浏览 收藏
-
- Golang · Go问答 | 54分钟前 |
- Go tar 为什么遍历目录时内容为空
- 255浏览 收藏
-
- Golang · Go问答 | 57分钟前 |
- Go ZIP 为什么打开条目后资源未释放
- 197浏览 收藏
-
- Golang · Go问答 | 57分钟前 |
- Go heap 为什么修改元素后 Pop 顺序不变
- 461浏览 收藏
-
- Golang · Go问答 | 1小时前 | go · base64 Go URLEncoding 填充字符 RawURLEncoding URL安全编码
- Go base64 为什么两种 URL 编码不能互解
- 209浏览 收藏
-
- Golang · Go问答 | 1小时前 |
- Go RawMessage 为什么二次解析后字段为空
- 321浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 583次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 621次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 655次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 622次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 436次使用
-
- 用Nginx反向代理部署go写的网站。
- 2023-01-17 502浏览
-
- GoLand调式动态执行代码
- 2023-01-13 502浏览
-
- Go JSONJSON null 解码到指针后状态不符合预期怎么办
- 2026-10-18 501浏览
-
- Go crypto/rand.Text 的长度为什么不是固定字符数
- 2026-10-04 501浏览
-
- Go strings.ToValidUTF8 清洗日志内容的边界
- 2026-10-03 501浏览


