
流式生成接口的增量文本拼接策略
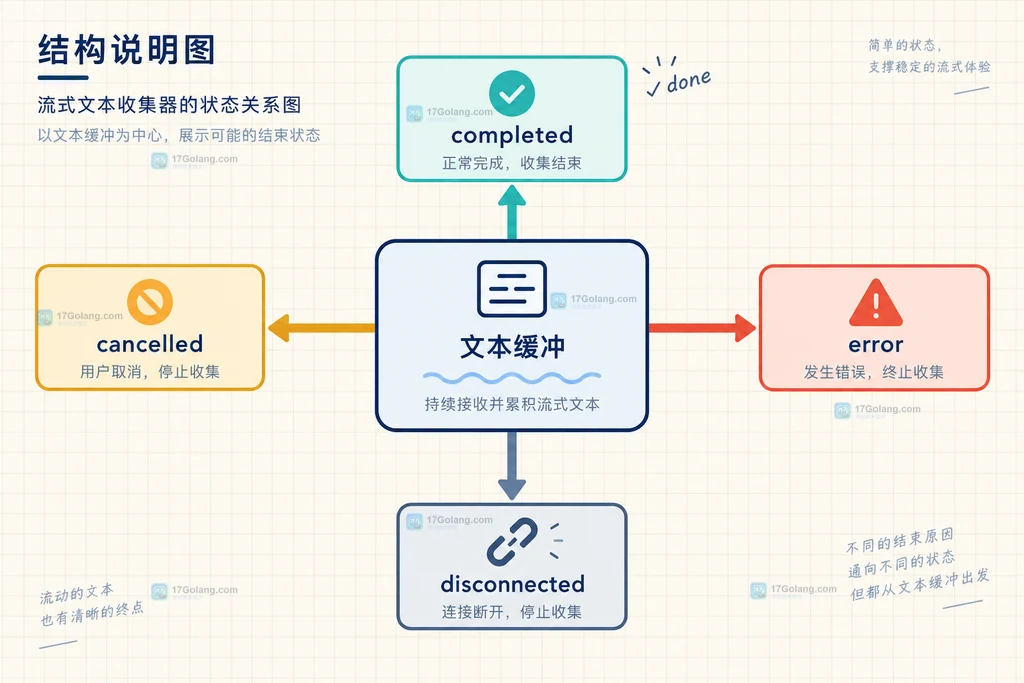
流式生成接口最容易出错的地方,不是把字符串加起来,而是没有分清“网络分片”“事件边界”和“生成结束”。一个事件可能跨越多次读取才收全,也可能在最后只返回结束标记而没有文本。可靠的增量拼接策略是:先按协议组装事件,再提取文本增量;同时用状态记录正常结束、主动取消、服务端错误和连接中断。
- 网络读取块不能直接当作一段可显示文本,必须先按空行还原事件。
- 文本缓冲区与 done、error、disconnected 状态分开保存,避免“有内容就算成功”。
- 最终渲染只认正常结束或明确的可恢复结果,断线要保留原因并决定是否重试。
先把用户看到的“逐字出现”拆成三层
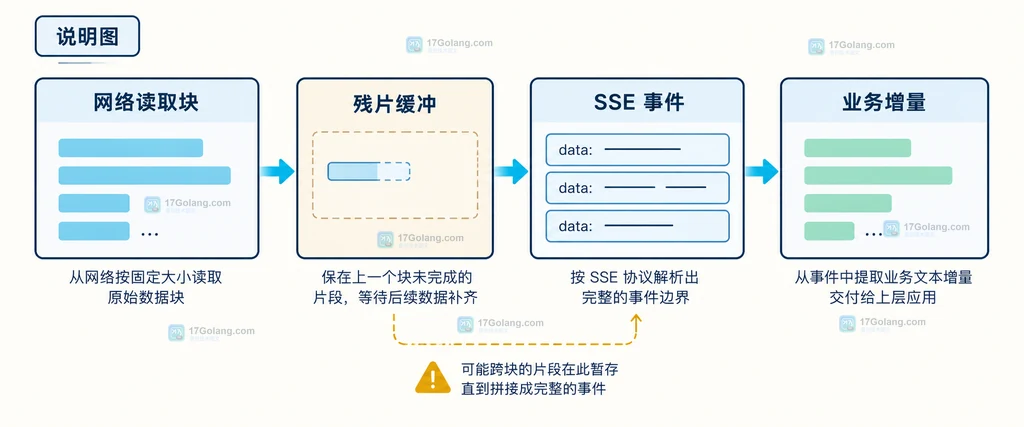
从接口返回到页面文字,中间至少有三层边界:网络读取块、SSE 事件、业务增量。读取块可能在任意 UTF-8 字节处截断;SSE 通常用空行结束一个事件;业务层才知道字段名是 delta、text 还是结束标记。直接对每个 ReadableStream chunk 调用 JSON.parse,遇到半个 JSON 就会误判为接口错误。
| 状态/数据 | 含义 | 处理方式 |
|---|---|---|
| buffer | 已确认的文本增量 | 只追加业务文本 |
| done | 服务端明确结束 | 允许提交最终文本 |
| error | 协议或服务端错误 | 停止渲染并展示原因 |
| disconnected | 连接提前断开 | 标为未完成,按策略重试 |
用事件解析器承接网络分片
解析器的职责应当很窄:保存上一次读取留下的残片,遇到完整事件后再交给业务处理。下面的示例假定每个事件只有一行 data:,真实项目如果允许多行 data,应先把同一事件的多行按协议拼接,再解析 JSON。
async function* readEvents(response) {
  const reader = response.body.getReader();
  const decoder = new TextDecoder();
  let pending = "";

  try {
    while (true) {
      const { value, done } = await reader.read();
      // 网络分片不等于事件,先把字节解码后放进残片缓冲区。
      pending += decoder.decode(value || new Uint8Array(), { stream: !done });
      const parts = pending.split("\n\n");
      pending = parts.pop() || "";

      for (const part of parts) {
        const line = part.split("\n").find(item => item.startsWith("data:"));
        if (!line) continue; // 心跳或空事件不产生文本增量。
        const payload = line.slice(5).trim();
        if (payload === "[DONE]") return;
        yield JSON.parse(payload); // 解析失败应由上层转为协议错误。
      }
      if (done) break;
    }
  } finally {
    // 无论正常结束还是取消,都释放读取器占用的响应体。
    reader.releaseLock();
  }
}
如果服务端使用 \r\n\r\n,应统一换行符后再切分;如果数据可能包含换行,不能用“找到第一行就结束”的简化逻辑。这里的图是静态结构说明图,展示的是职责边界,不代表某次真实请求的截图。
让渲染组件只消费可信的增量
解析器负责“把事件交出来”,渲染组件负责“把已经确认的文字显示出来”,两者不要共用一套临时变量。这样做有两个直接好处:组件可以用 textContent 更新文本,避免把模型输出当成 HTML 插入;同时可以用 aria-live="polite" 告诉辅助技术内容正在变化,但不必为每个网络块创建一个 DOM 节点。
function appendDelta(view, state, delta) {
  if (typeof delta !== "string" || delta.length === 0) return;
  state.text += delta;
  // 只写入纯文本,避免把流式内容当作 HTML 执行。
  view.textContent = state.text;
  view.dataset.status = "streaming";
}
如果增量频率很高,可以把更新合并到下一帧或一个短定时窗口内,再一次性刷新视图。缓冲只影响绘制频率,不应改变事件顺序。
把文本、结束和断线做成独立状态
业务层不要用 buffer.length > 0 判断成功,因为模型可能先发空的元数据事件,也可能在输出半句时断线。更稳妥的做法是只在收到明确结束标记时设置 done,在读取异常时设置 disconnected,并让最终提交函数统一检查。
async function collectText(response, signal) {
  let text = "";
  let done = false;
  let error = null;

  try {
    for await (const event of readEvents(response)) {
      if (event.type === "error") throw new Error(event.message || "stream error");
      if (event.type === "done") { done = true; break; }
      // 只追加明确的文本字段,避免把 token 用量等元数据混入正文。
      if (typeof event.delta === "string") text += event.delta;
    }
  } catch (cause) {
    error = cause;
  }

  if (signal.aborted) return { text, status: "cancelled", error };
  if (error) return { text, status: "error", error };
  if (!done) return { text, status: "disconnected", error: new Error("未收到结束标记") };
  return { text, status: "completed", error: null };
}
这里把“用户主动取消”和“网络意外断开”分开,前者通常不需要报警,后者才进入重试或草稿保留逻辑。非 2xx 响应也应在调用 collectText 前拦截,并读取错误体中的可展示信息;不要把错误页面当作流事件解析。
从单次响应迁移时要补上的检查点
迁移旧代码时,重点不是把一个布尔参数改成 stream: true,而是把原来的“一次返回即成功”拆成几个可观察状态。
- 请求层:检查
response.ok、Content-Type 和取消信号,非 2xx 直接结束。 - 解析层:保留残片,按事件边界解包,识别心跳、增量、错误和结束标记。
- 渲染层:追加已确认文本,避免每次事件都重建完整对象;结束前显示“生成中”。
- 恢复层:断线保留已拼接文本和原因,重试必须带新的请求标识,防止重复追加。
可把一次回归测试写成四组输入:结束标记紧跟最后文本、结束标记单独成事件、一个 JSON 被拆成多个网络块、连接在半句文本后断开。只有前两组能进入 completed;后两组应保留已有文本但不能假装完成。
常见问题
为什么已经看到文字,接口仍然不能算成功?
文字只说明收到过增量,不说明服务端完成。应以明确结束事件作为提交条件,并保留断线状态。
收到 [DONE] 后还需要再拼一段吗?
通常不需要。[DONE] 是边界信号,不是正文;先处理它之前已经确认的增量,再结束迭代。
断线后能不能直接把当前文本展示为最终答案?
可以作为草稿或部分结果展示,但状态应标记为未完成,并让用户知道重试会不会从头生成。
 量化模型本地推理的显存估算方法
- 上一篇
- 量化模型本地推理的显存估算方法
- 下一篇
- 提示词缓存减少重复上下文开销的设计
-
- 科技周边 · 人工智能 | 1小时前 | 性能优化 · AI工程 · 缓存失效 提示词缓存 AI工程 Prompt Cache 稳定前缀
- 提示词缓存减少重复上下文开销的设计
- 263浏览 收藏
-
- 科技周边 · 人工智能 | 1小时前 |
- 多模态模型提取表格布局的结果约束
- 359浏览 收藏
-
- 科技周边 · 人工智能 | 1小时前 |
- Hugging Face Inference Providers 选择模型路由的接入方式
- 292浏览 收藏
-
- 科技周边 · 人工智能 | 12小时前 |
- Embedding 批量请求的长度和失败重试设计
- 383浏览 收藏
-
- 科技周边 · 人工智能 | 2天前 |
- RAG 文档切片怎样决定 overlap
- 278浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 501次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 560次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 587次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 539次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 351次使用
-
- Go 大文件 CSV 导出怎么做稳:从全量查询到流式写出架构
- 2026-07-08 251浏览
-
- Go 批量 CSV 导入怎么控内存:流式读取、资源预算和失败行回传实战
- 2026-07-20 407浏览
-
- Go JSON 严格解码上线后请求变 400:DisallowUnknownFields 的兼容性故障复盘
- 2026-07-26 174浏览
-
- Go 流式响应怎么做:ResponseController.Flush、SSE 与断开回收的取舍
- 2026-07-26 463浏览
-
- Go 分页接口怎么设计:游标参数、错误码与兼容返回
- 2026-07-26 427浏览