Go csvutil 怎么为业务字段实现自定义文本转换
CSV 里的字段通常是文本,但业务对象不一定只包含 string、int 这些基础类型。比如订单号想用十六进制文本交换,状态值想使用团队约定的短码,时间字段也可能要求固定格式。遇到这类字段时,csvutil 的关键不是重写整套 CSV 解析,而是把“文本如何变成业务值、业务值如何写回文本”收敛到类型方法或局部注册器中。
官方地址:https://github.com/jszwec/csvutil
推荐的落地顺序是:先给业务类型定义双向转换方法;如果同一个类型在不同导入任务中有多套格式,再用 Decoder 和 Encoder 的注册转换器覆盖局部场景。这样 CSV 结构仍由 csvutil 管理,业务字段的文本规则则有明确归属。
一、升级范围:只改业务字段的文本边界
本文假定有一个订单导入结构体,CSV 中的 order_id 使用十六进制文本,例如 1a2b,Go 代码里希望得到一个有业务含义的 HexID。本文只处理这个字段的转换,不把问题扩展成 CSV 分隔符、无表头文件或大文件流式读取教程。
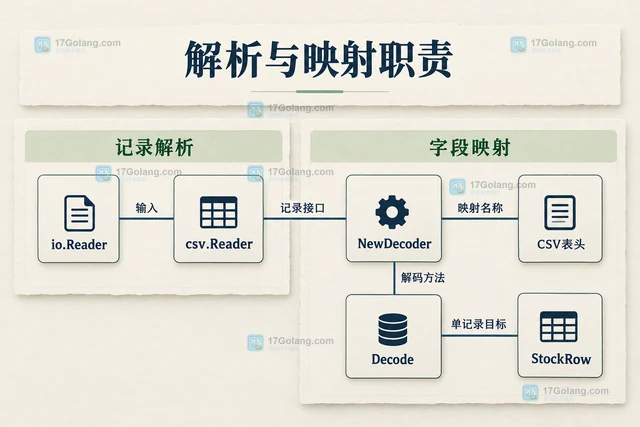
csvutil 官方项目定位是 Go 值与 CSV 之间的映射,它基于标准库的 Reader 和 Writer 接口,并提供 Decoder、Encoder 以及自定义类型覆盖能力。因而改造点应放在字段类型的边界,而不是在每个调用点手工解析字符串。
二、变更表:旧写法和推荐写法有什么区别
| 处理方式 | 适合场景 | 边界 | 维护重点 |
|---|---|---|---|
| 先读 string,再在业务层转换 | 临时脚本或一次性导入 | 转换规则散落在调用方 | 每个入口都要重复处理错误 |
| 类型实现 UnmarshalCSV/MarshalCSV | 同一业务类型始终使用同一文本格式 | 规则跟随类型生效 | 方法中的空值、非法值和格式化要稳定 |
| 实现 encoding.TextUnmarshaler/TextMarshaler | 希望复用 Go 生态中的文本接口 | 语义比 CSV 更通用 | 确认其他编码器也接受这套文本规则 |
| WithUnmarshalers/WithMarshalers 注册 | 同一类型在不同任务有不同格式 | 规则只对当前 Decoder/Encoder 生效 | 把注册范围和优先级写进初始化代码 |
这里的“旧写法”不是错误,而是适用范围较窄。真正需要迁移的信号通常是:同一个字段在多个 CSV 入口重复出现,或者导入代码同时承担了字段查找、字符串解析和错误包装。
三、旧代码风险:把业务字段当普通字符串会发生什么
如果结构体先把订单号声明成 string,csvutil 只能完成列到字符串的映射,无法知道 1a2b 应该如何变成业务 ID。调用方随后需要再写一次循环,手工解析每条记录,并决定错误应该带哪一行、哪一列。
package main

import (
    "encoding/csv"
    "fmt"
    "strconv"
    "strings"
)

type OrderRow struct {
    OrderID string `csv:"order_id"`
}

func parseRows(rows []OrderRow) ([]uint64, error) {
    result := make([]uint64, 0, len(rows))
    for index, row := range rows {
        // 这里把格式规则留在调用方,错误需要额外补充记录位置。
        id, err := strconv.ParseUint(row.OrderID, 16, 64)
        if err != nil {
            return nil, fmt.Errorf("第 %d 行 order_id 无效: %w", index+2, err)
        }
        result = append(result, id)
    }
    return result, nil
}

func readText() *csv.Reader {
    // 这里只展示输入边界,真正的字段转换不应继续堆在 Reader 周围。
    return csv.NewReader(strings.NewReader("order_id\n1a2b\n"))
}
这段写法可以工作,但它把“字符串是什么格式”与“订单行如何导入”绑在了一起。下一次订单号改成带前缀的格式,或者另一个入口需要把同一个类型写回 CSV,就会出现一组新的分支。
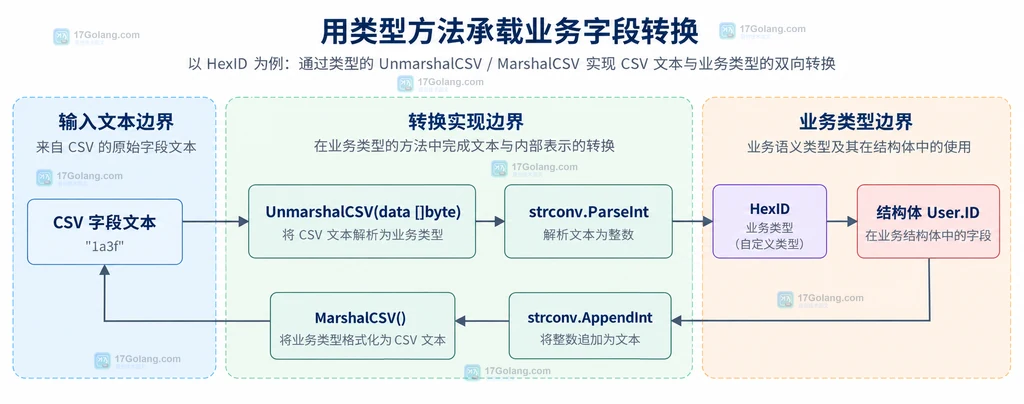
四、新写法:让业务类型拥有双向转换方法
当 HexID 的文本约定是稳定的,最直观的改法是把转换规则放进类型本身。csvutil 官方 README 给出的自定义类型方案包含 csvutil.Marshaler 和 csvutil.Unmarshaler;接收文本时解析到接收者,输出文本时返回字节切片。
package main

import (
    "fmt"
    "strconv"
)

type HexID uint64

func (id *HexID) UnmarshalCSV(data []byte) error {
    // 空字段是否代表零值要先定规则;这里将空字段视为未设置。
    if len(data) == 0 {
        *id = 0
        return nil
    }

    value, err := strconv.ParseUint(string(data), 16, 64)
    if err != nil {
        // 保留底层解析错误,便于上层区分非法十六进制文本。
        return fmt.Errorf("HexID 必须是十六进制文本: %w", err)
    }
    *id = HexID(value)
    return nil
}

func (id HexID) MarshalCSV() ([]byte, error) {
    // 使用小写十六进制,保证同一个值写出时格式稳定。
    return []byte(strconv.FormatUint(uint64(id), 16)), nil
}

type User struct {
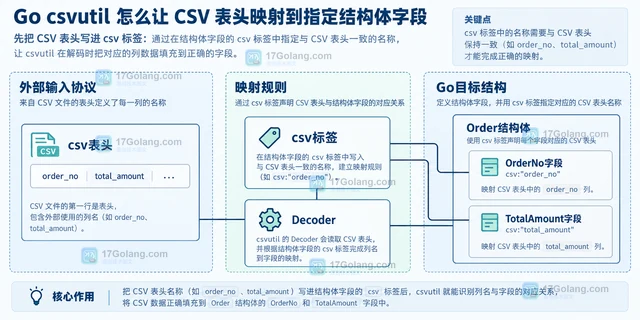
    ID   HexID `csv:"order_id"`
    Name string `csv:"name"`
}
这里有三个关键点:
UnmarshalCSV使用指针接收者,因为解码过程需要把结果写回字段。MarshalCSV使用值接收者,因为编码只需要读取当前值。- 空字段策略必须与业务约定一致。若空值不是零值,而是“缺失”,就应改用指针类型或额外的有效性字段,不能悄悄把两种状态混为一谈。
五、接入 csvutil:解码和编码要保持同一规则
定义好类型方法后,结构体可以直接交给 csvutil。下面的示例同时展示解码和编码,重点是让读取与写出共享同一套 HexID 规则。
package main

import (
    "bytes"
    "encoding/csv"
    "fmt"
    "io"

    "github.com/jszwec/csvutil"
)

func convert(input []byte) ([]byte, error) {
    reader := csv.NewReader(bytes.NewReader(input))
    decoder, err := csvutil.NewDecoder(reader)
    if err != nil {
        return nil, fmt.Errorf("创建解码器失败: %w", err)
    }

    var users []User
    for {
        var user User
        if err := decoder.Decode(&user); err == io.EOF {
            break
        } else if err != nil {
            // 解码错误在边界处返回,不把坏数据静默写入业务层。
            return nil, fmt.Errorf("解码订单失败: %w", err)
        }
        users = append(users, user)
    }

    var output bytes.Buffer
    writer := csv.NewWriter(&output)
    encoder := csvutil.NewEncoder(writer)
    for _, user := range users {
        if err := encoder.Encode(user); err != nil {
            return nil, fmt.Errorf("编码订单失败: %w", err)
        }
    }
    writer.Flush()
    if err := writer.Error(); err != nil {
        return nil, fmt.Errorf("写出 CSV 失败: %w", err)
    }
    return output.Bytes(), nil
}
业务代码不再关心 HexID 的解析细节。它只需要处理“这一行能否映射到 User”以及“输出目标是否写入成功”两个边界。对批量导入来说,这也更容易统一错误日志和失败策略。
六、局部转换:同一个类型需要不同格式怎么办
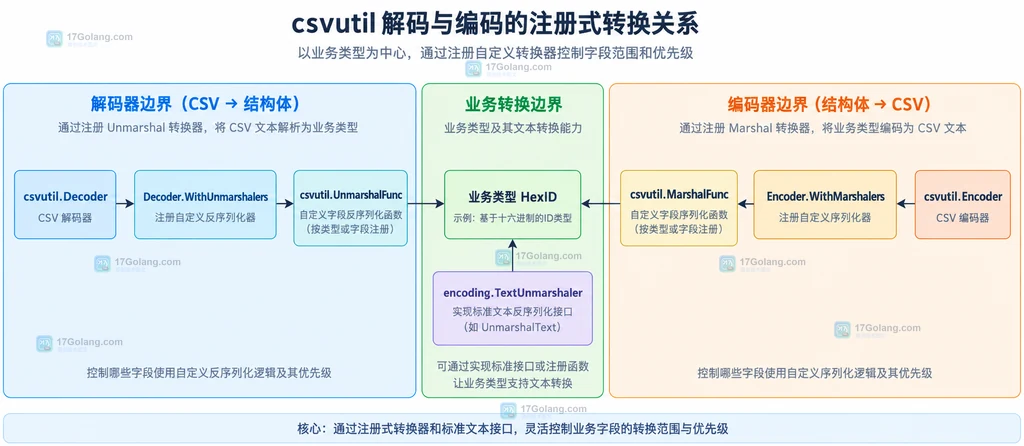
类型方法适合全局一致的规则。如果老系统有一份 CSV 使用十六进制,另一份内部交换文件使用十进制,就不要为了一个局部入口修改 HexID 的默认语义。此时可使用 WithUnmarshalers 和 WithMarshalers 注册函数。
package main

import (
    "fmt"
    "strconv"

    "github.com/jszwec/csvutil"
)

func registerDecimal(dec *csvutil.Decoder) {
    dec.WithUnmarshalers(
        csvutil.UnmarshalFunc(func(data []byte, id *HexID) error {
            // 当前导入任务明确约定十进制,避免改变 HexID 的默认十六进制语义。
            value, err := strconv.ParseUint(string(data), 10, 64)
            if err != nil {
                return fmt.Errorf("十进制订单号无效: %w", err)
            }
            *id = HexID(value)
            return nil
        }),
    )
}

func registerDecimalEncoder(enc *csvutil.Encoder) {
    enc.WithMarshalers(
        csvutil.MarshalFunc(func(id HexID) ([]byte, error) {
            // 只有这个 Encoder 使用十进制写出,其他入口仍使用类型默认格式。
            return []byte(strconv.FormatUint(uint64(id), 10)), nil
        }),
    )
}
注册式写法的价值在“作用域”:它不会把一个临时文件格式写进全局类型。初始化 Decoder 或 Encoder 时,应在旁边写明当前文件的格式约定,避免后续维护者把注册器误当成全局设置。
七、接口选择:csvutil 方法、encoding.Text 还是注册函数
csvutil 官方资料列出的覆盖路径不止一种,选择时可以按“规则归属”判断:
- 只有 CSV 需要这套格式:优先实现
MarshalCSV和UnmarshalCSV,语义最直接。 - JSON、配置或其他文本编码也应复用:可以让类型实现
encoding.TextMarshaler与encoding.TextUnmarshaler,但要确认这套文本表示对所有调用方都合理。 - 同一类型有多套输入格式:使用当前 Decoder/Encoder 的注册器,不要修改类型默认方法去迎合单个文件。
- 一组类型共享某种接口:可以注册面向接口的转换函数,但要让接口范围足够窄,避免把不相关的业务类型一起匹配。
csvutil 的选择优先级需要作为迁移注意事项记录下来:显式注册的类型转换优先,其次是已注册接口,再到类型实现的 csvutil 接口,最后才是 encoding.Text 接口。若同一个类型同时实现了多套方法,实际采用哪条路径就不能靠猜,应该在代码审查时明确注册关系。
八、回归检查:迁移后至少核对这五项
自定义转换不是把字符串换成新类型就结束了。上线前建议用小范围表格或单元测试覆盖以下边界:
| 检查项 | 应确认的结果 |
|---|---|
| 正常文本 | 1a2b 能得到预期 HexID,写出时格式稳定。 |
| 空字段 | 明确是零值、缺失还是错误,不允许由默认行为偶然决定。 |
| 非法文本 | 错误保留字段语义,导入层能补充记录位置并决定是否停止。 |
| 指针与值接收者 | 解码方法能写回值,编码方法不会因为接收者不匹配而失效。 |
| 多格式入口 | 局部注册器只影响目标 Decoder/Encoder,不改变其他任务的默认格式。 |
尤其要注意“读得进”和“写得出”不一定天然对称。导入格式可以允许前导零,导出格式却可能统一成小写无前导零;这应是有意的协议设计,而不是解析与格式化函数各自做出的偶然决定。
九、迁移清单
- 为业务字段建立明确的类型,而不是让所有入口都接收裸字符串。
- 在类型方法中固定稳定的默认 CSV 文本规则,并为错误添加字段语义。
- 需要跨编码器复用时,再考虑
encoding.TextUnmarshaler和encoding.TextMarshaler。 - 需要兼容多种文件格式时,使用 Decoder/Encoder 的注册函数隔离局部规则。
- 给空值、非法值、读写对称性和注册优先级留下回归用例。
这样改造后,csvutil 负责 CSV 的列映射,HexID 负责自己的文本表示,导入任务只负责选择合适的转换范围。字段规则从散落的循环里回到清晰的类型或 Decoder/Encoder 边界,后续再增加业务字段时也更容易复用。
相关问题
csvutil 能不能直接解析业务枚举?
可以。枚举类型可以实现 csvutil 的自定义解码方法,或通过注册函数把短文本映射为枚举值;重点是对未知枚举值返回明确错误。
为什么只实现 UnmarshalCSV 但编码仍然失败?
读取和写出是两条独立路径。若业务类型也会被导出,就需要同时提供 MarshalCSV,或者为 Encoder 注册对应的 MarshalFunc。
注册转换器会修改所有 csvutil Decoder 吗?
不会。注册器挂在具体 Decoder 或 Encoder 上,适合隔离某个文件、租户或历史格式;类型方法则更接近默认行为。
自定义转换里应该把错误吞掉吗?
不建议。转换函数应返回可包装的错误,让上层补充行号、列名或任务标识;静默使用零值会把坏数据变成难以追踪的业务结果。
 Go csvutil 怎么让 CSV 表头映射到指定结构体字段