
Python contextvars 如何在异步任务间传递请求标识
在 asyncio 并发处理请求时,最稳妥的做法是用 ContextVar 保存请求级标识,而不是把一个可变字典塞进全局变量。进入请求边界时调用 set(),业务深层函数用 get() 读取,离开边界时在 finally 中用 reset(token) 恢复旧值。通过 asyncio.create_task() 创建任务时,当前上下文会被复制,因此不同任务可以各自携带自己的 request_id。
ContextVar是任务级上下文,不是跨请求共享的普通全局变量。- 请求入口保存
set()返回的 token,清理一定放在finally。 - 任务创建时复制上下文;如果要传入指定上下文,再使用
copy_context()和context=。
先定义带默认值的 ContextVar
我通常先把变量声明在日志或请求上下文模块中,让需要记录日志的函数只依赖一个稳定的读取入口。默认值不要省略,否则某个入口忘记设置标识时,get() 会抛出 LookupError,排查起来反而打断了原始业务。
import contextvars

# 默认值用于覆盖漏设请求标识的边界情况
request_id_var = contextvars.ContextVar("request_id", default="-")

def current_request_id() -> str:
    # 深层函数不需要层层接收 request_id 参数
    return request_id_var.get()
官方资料把 ContextVar 定义为上下文局部状态,适合异步框架使用。它解决的是“当前执行上下文是谁”,不是把数据自动写入所有线程或所有进程。
在请求边界 set 并保存 token
set() 返回的 token 记录了设置前的状态。把它和请求处理放在同一个边界里,清理逻辑就不会依赖调用方是否记得恢复。这个习惯对连接池、任务复用和测试用例尤其重要。
async def handle_request(request) -> dict:
    # 请求入口生成或读取唯一标识
    token = request_id_var.set(request.headers.get("X-Request-ID", "req-local"))
    try:
        # 深层函数、日志适配器都能读取同一请求上下文
        result = await load_profile(request.user_id)
        return {"request_id": current_request_id(), "data": result}
    finally:
        # 无论成功、异常还是取消,都恢复进入前的上下文
        request_id_var.reset(token)
这里的关键不是“把值设进去”,而是成对管理 set 与 reset。如果只 set 不 reset,当前任务后续继续执行的代码可能读到已经结束请求的标识。
创建任务时利用上下文复制
当父任务先设置了请求标识,再创建子任务,子任务会取得创建瞬间的上下文副本。任务之间不会因为随后某个任务修改自己的 ContextVar 而直接覆盖对方,这正是它比共享可变字典更适合请求日志的地方。

async def run_parallel_jobs() -> list[str]:
    # 父任务先确定本次请求的标识
    request_id_var.set("req-1001")

    # create_task 在创建时复制当前上下文
    tasks = [
        asyncio.create_task(fetch_part("users")),
        asyncio.create_task(fetch_part("orders")),
    ]
    return await asyncio.gather(*tasks)

async def fetch_part(part: str) -> str:
    # 每个子任务都能读取创建时继承的请求标识
    return f"{part}:{current_request_id()}"
如果任务要使用一个明确构造的上下文,可以这样传入:
def make_task(coro, request_id: str):
    # 复制调用点上下文,再只修改副本中的请求标识
    ctx = contextvars.copy_context()
    ctx.run(request_id_var.set, request_id)
    return asyncio.create_task(coro, context=ctx)  # 把副本交给 Task
这段代码表达的是上下文边界,不代表所有库的后台任务都会自动继承它;跨线程、跨进程或由外部队列重新消费时,需要在新的执行边界重新注入标识。
把 request_id 接入日志并排查边界
日志适配器只要在真正输出的那一刻调用 current_request_id(),就能把深层业务函数的日志和请求关联起来。下面的示例用一个简单函数表达这个位置,生产环境再接入标准库 logging 的 Filter、LoggerAdapter 或结构化日志处理器。

def log_event(event: str) -> None:
    # 在日志写出前读取当前任务的上下文
    print({"event": event, "request_id": current_request_id()})
| 现象 | 优先检查 | 处理方式 |
|---|---|---|
| 日志里总是 “-” | 入口是否执行 set | 把 set 放在请求处理最外层 |
| 并发日志串号 | 是否共享可变字典 | 改用 ContextVar,并在任务创建前设置 |
| 请求结束后仍读到旧值 | 是否缺少 reset | 保存 token,在 finally 中 reset |
| 线程函数读不到标识 | 执行边界是否换了线程 | 显式传值或用 to_thread 的上下文传播能力 |
还要注意创建时机:先 set 再 create_task,子任务才会复制目标值;先创建后 set,已经创建的任务不会因为父任务后来修改而回溯更新。对于必须人工控制的场景,使用 copy_context() 构造明确副本,比猜测调用链更容易维护。
常见问题
ContextVar 能完全替代函数参数吗?
不能。它适合请求标识、租户标识、语言环境这类隐式上下文;核心业务输入仍建议使用显式参数,避免依赖隐藏状态。
为什么不用 threading.local?
threading.local() 按线程隔离,而 asyncio 的多个任务通常共享一个线程。ContextVar 按执行上下文隔离,更贴合协程切换。
copy_context() 会深拷贝所有业务对象吗?
不会把每个值递归复制成独立对象。它复制的是上下文到变量值的绑定关系;如果值本身是可变对象,仍要避免跨任务共享并修改。
官方文档在哪里?
可以复制 Python 官方资料地址:https://docs.python.org/3/library/contextvars.html;任务 API 说明见 https://docs.python.org/3/library/asyncio-task.html。
 Go slices.Clip 如何释放切片多余容量
- 上一篇
- Go slices.Clip 如何释放切片多余容量

- 下一篇
- Go 文件在 Linux 能打开但 Windows 路径失败怎么办
-
- 文章 · python教程 | 2小时前 |
- Python contextvars Token 怎样撤销临时上下文修改
- 353浏览 收藏
-
- 文章 · python教程 | 3小时前 |
- Python io.BufferedReader.peek 怎样预读字节
- 356浏览 收藏
-
- 文章 · python教程 | 3小时前 | 面向对象 · Python教程 · 字段默认值 slots Python dataclasses 继承字段 weakref_slot
- Python dataclasses slots 与继承字段的设计
- 399浏览 收藏
-
- 文章 · python教程 | 3小时前 |
- Python inspect.get_annotations 怎样安全读取函数注解
- 440浏览 收藏
-
- 文章 · python教程 | 3小时前 | 网络编程 · 标准库 · Python教程 · Python 网段判断 ipaddress IPv4Network IPv4Address
- Python ipaddress.IPv4Network 怎样判断地址是否属于网段
- 365浏览 收藏
-
- 文章 · python教程 | 3小时前 | 标准库 · Python教程 · Python 附件 MIME email.message EmailMessage add_attachment
- Python email.message.EmailMessage 怎样添加 MIME 附件
- 170浏览 收藏
-
- 文章 · python教程 | 3小时前 | 标准库 · Python教程 · Python 命令行 位置参数 argparse parse_intermixed_args
- Python argparse.parse_intermixed_args 怎样处理混合位置参数
- 342浏览 收藏
-
- 文章 · python教程 | 3小时前 | Python教程 · Python 保留关键字 str.isidentifier keyword.iskeyword 名称校验
- Python str.isidentifier 为什么不能排除保留关键字
- 282浏览 收藏
-
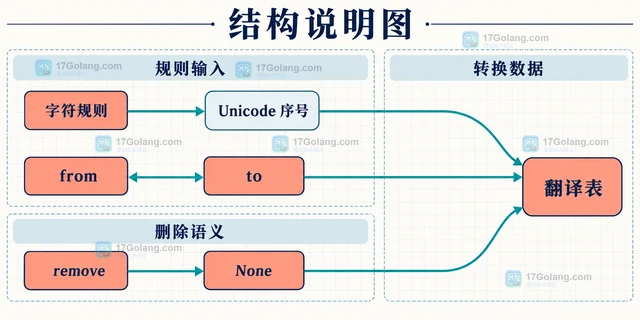
- 文章 · python教程 | 3小时前 | 字符串 · Python教程 · Python 字符替换 str.maketrans str.translate 字符串清理
- Python str.maketrans 怎样同时替换字符并删除指定符号
- 264浏览 收藏
-
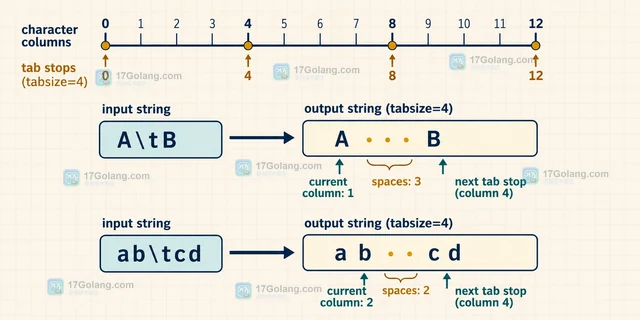
- 文章 · python教程 | 3小时前 | 字符串 · Python教程 · Python 制表符 str.expandtabs tabsize 字符串排版
- Python str.expandtabs 怎样按制表位展开空格
- 284浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 757次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 754次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 836次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 803次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 635次使用
-
- go格式“占位符”输入输出 类似python的input
- 2023-01-19 346浏览
-
- Golang如何调用Python代码详解
- 2023-01-07 235浏览
-
- HTTP 的 response 中的响应体和头部是分开发送的吗?
- 2023-01-28 387浏览
-
- B站等视频网站的弹幕用的是 websocket 还是轮询?
- 2023-02-16 447浏览
-
- Linux 下有什么命令行工具以时序显示 CPU 占用率?
- 2023-01-13 360浏览


