
Go 并发读写 map 为什么偶发 fatal error
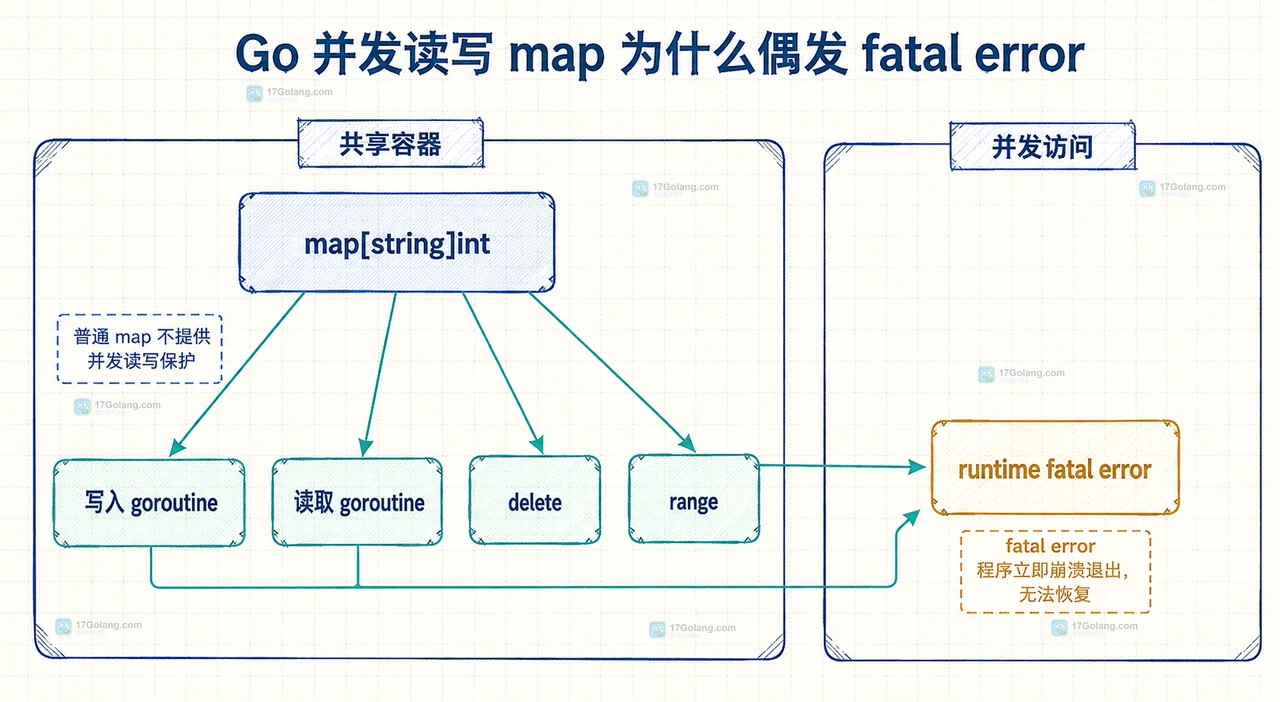
如果日志里出现 fatal error: concurrent map read and map write,根因通常不是 map “偶发坏掉”,而是普通 map 被多个 goroutine 同时访问,至少有一个访问会修改它。解决办法是让所有读、写、删、遍历都经过同一个同步边界;只有在数据模型适合时,才考虑 sync.Map。
- 普通 map 本身不提供并发读写保护,读和写同时发生也不安全。
RWMutex必须覆盖完整的 map 操作,不能只锁写入而放任读取或遍历。sync.Map适合特定读写模式,普通业务数据优先保留类型安全的 map 加锁方案。
先复现:读写 map 共用同一个无保护容器
做一个最小计数器就能看出问题:一个 goroutine 不断累加键值,另一个 goroutine 同时读取。普通 map 的元素读写和内部结构调整可能交叉,运行时会主动终止进程,因此它不是可以靠 recover 稳定兜住的普通业务 panic。
package main

import "sync"

func main() {
	counts := make(map[string]int)
	var wg sync.WaitGroup

	// 写入 goroutine 和读取 goroutine 共享同一个普通 map。
	wg.Add(2)
	go func() {
		defer wg.Done()
		for i := 0; i
这里的关键不是循环次数,而是共享状态没有明确的所有权。即使低并发时“多数时候没事”,也不能把偶然没触发当作安全证明。
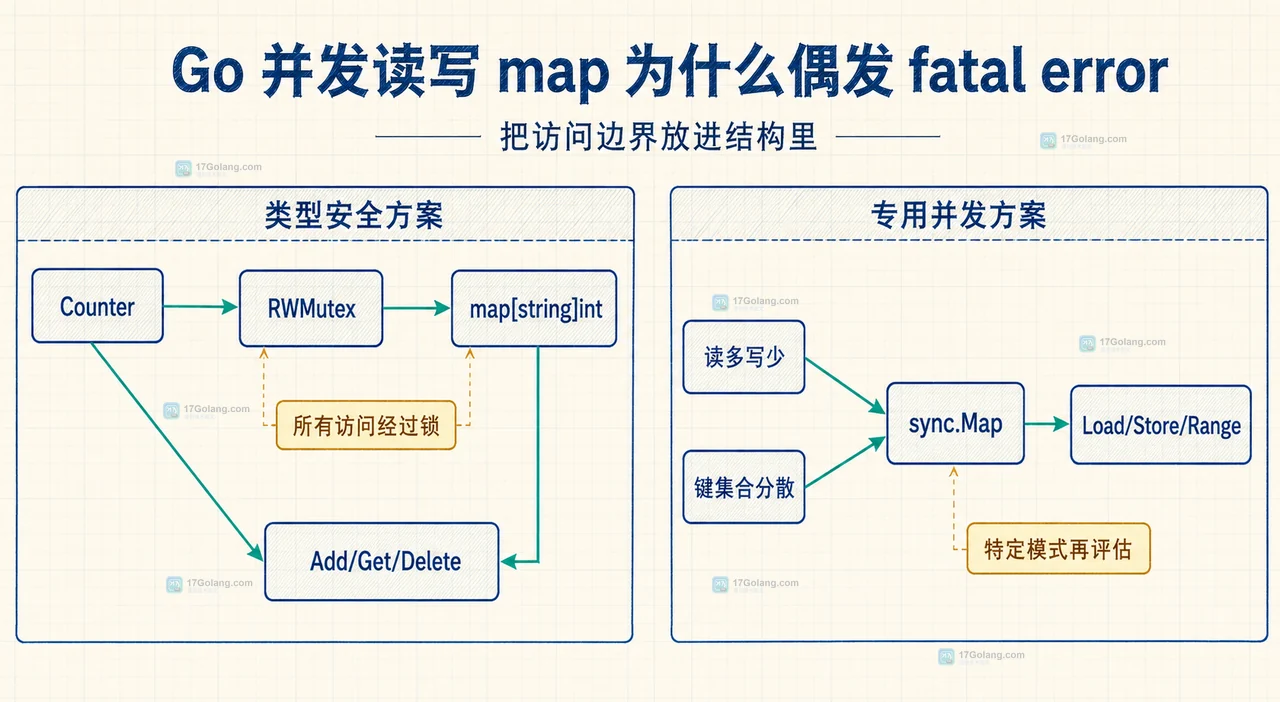
把访问边界放进结构里
对于类型明确的业务数据,我更建议保留 map[string]int,在封装层统一使用 sync.RWMutex。读方法用 RLock,修改和删除用 Lock;不要让调用方拿到内部 map 后绕过封装。
type Counter struct {
	mu sync.RWMutex
	m  map[string]int
}

func NewCounter() *Counter {
	return &Counter{m: make(map[string]int)} // 初始化后再提供并发方法。
}

func (c *Counter) Add(key string) {
	c.mu.Lock()
	defer c.mu.Unlock() // 覆盖整个读改写过程,避免丢失更新。
	c.m[key]++
}

func (c *Counter) Get(key string) (int, bool) {
	c.mu.RLock()
	defer c.mu.RUnlock() // 读取也必须进入同一个同步边界。
	v, ok := c.m[key]
	return v, ok
}

func (c *Counter) Delete(key string) {
	c.mu.Lock()
	defer c.mu.Unlock() // delete 会修改 map 的内部状态。
	delete(c.m, key)
}
锁保护的是“访问路径”,不是某一行代码。若返回值是指向可变结构的指针,解锁后继续修改该结构仍可能产生新的竞态;这时要复制值,或把值的修改也封装进锁内。
| 场景 | 建议 | 原因 |
|---|---|---|
| 键和值类型明确,读写混合 | map + Mutex/RWMutex | 类型安全,容易维护附加不变量 |
| 键只写入一次,之后大量读取 | 评估 sync.Map | 符合其典型使用模式 |
| 多个 goroutine 操作不相交的键 | 评估 sync.Map | 可减少锁竞争,但仍需接受 any 类型 |
用 race 检查锁是否真的覆盖了共享数据
修完后先跑竞态检测,而不是只观察程序是否“没再退出”。把并发场景写成测试,命令如下:
# 竞态检测会给出冲突访问的调用栈。
go test -race ./...
检查清单有三项:所有读写是否经过同一把锁;遍历期间是否保持读锁或先复制快照;map 的 value 如果是 slice、指针或嵌套 map,解锁后是否仍被多个 goroutine 修改。第三项经常被忽略:外层 map 安全,不等于内部对象自动安全。
什么时候换成 sync.Map
sync.Map 的确支持多个 goroutine 并发使用,但它不是普通 map 的无脑升级版。它牺牲了静态类型便利,取值后通常还要做类型断言;Range 也不代表一次一致性快照。
如果缓存键通常只写一次、之后反复读取,或者不同 goroutine 主要操作互不相同的键,可以做基准测试后评估它。若业务需要同时维护计数、过期时间、容量等不变量,类型明确的 map 加锁往往更直观。
常见问题
只给写操作加锁,读操作需要锁吗?
需要。读与写同时发生仍是不安全访问,读取、删除和遍历都应进入同一个同步策略。
出现 fatal error 后用 recover 能恢复吗?
不能把它当作普通 panic 设计恢复流程。应修复共享访问关系,并用 -race 找剩余竞态。
RWMutex 一定比 Mutex 快吗?
不一定。读多写少且临界区合适时才可能受益;锁竞争、临界区大小和调度开销仍要用基准测试判断。
判断这类问题可以记成一句话:先找出谁拥有 map,再让所有访问都经过同一个边界;只有读写模式明确匹配时,才把替代结构纳入测试。
 MySQL EXPLAIN ANALYZE 怎么判断实际行数偏差
- 上一篇
- MySQL EXPLAIN ANALYZE 怎么判断实际行数偏差
- 下一篇
- Redis Stream 裁剪时 KEEPREF 和 ACKED 怎么选
-
- Golang · Go问答 | 3小时前 |
- Go 接口为什么看起来不是 nil
- 163浏览 收藏
-
- Golang · Go问答 | 3小时前 |
- Go MultiWriter 为什么一个输出失败仍继续写
- 310浏览 收藏
-
- Golang · Go问答 | 3小时前 |
- Go 反射为什么修改字段没有生效
- 101浏览 收藏
-
- Golang · Go问答 | 3小时前 |
- Go gzip 为什么生成文件无法解压
- 488浏览 收藏
-
- Golang · Go问答 | 3小时前 |
- Go tar 为什么遍历目录时内容为空
- 255浏览 收藏
-
- Golang · Go问答 | 3小时前 |
- Go ZIP 为什么打开条目后资源未释放
- 197浏览 收藏
-
- Golang · Go问答 | 3小时前 |
- Go heap 为什么修改元素后 Pop 顺序不变
- 461浏览 收藏
-
- Golang · Go问答 | 3小时前 | go · base64 Go URLEncoding 填充字符 RawURLEncoding URL安全编码
- Go base64 为什么两种 URL 编码不能互解
- 209浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 586次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 622次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 656次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 622次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 438次使用
-
- Go map 并发写 panic 怎么办:从共享 map 到可控写入路径
- 2026-06-30 123浏览
-
- 详解如何在Go语言中循环数据结构
- 2022-12-22 406浏览
-
- Go语言读写锁RWMutex的源码分析
- 2022-12-31 319浏览
-
- Golang中map的深入探究
- 2022-12-23 369浏览
-
- Golang中map数据类型的使用方法
- 2022-12-30 443浏览


