
MySQL 慢 SQL 优化工作流:从慢日志到 EXPLAIN 和索引回归验证
MySQL 慢 SQL 优化不能只靠“看起来该加索引”。比较稳的做法是把它当成一条工作流:先从慢查询日志找到高影响语句,再聚合同类 SQL,接着用 EXPLAIN 看访问方式、索引命中和扫描行数,最后做索引改造与回归验证。
这篇文章不追求一次讲完所有优化技巧,而是给出一套能复用的路线图。你可以把它用在列表页变慢、后台查询卡顿、定时任务拖库、接口 p95 飙升等场景。
- 目标和边界:慢 SQL 优化先看影响面
- 全流程总览:从慢日志到回归验证
- 阶段一:打开慢查询日志并筛出候选 SQL
- 阶段二:聚合同类 SQL,先处理高影响语句
- 阶段三:用 EXPLAIN 看访问方式和扫描行数
- 阶段四:按 WHERE 与 ORDER BY 设计联合索引
- 阶段五:上线前后做回归验证
- 我的推荐流程
- 容易踩坑的地方
- 落地速查表
目标和边界:慢 SQL 优化先看影响面
先说结论:慢 SQL 优化的目标不是让某条语句在本地跑得很快,而是让线上高频、重要、可复现的查询稳定下降延迟,同时不破坏写入性能和业务结果。
开始动手前,先把边界定清楚:
- 优先处理高频、耗时高、扫描行数大的 SQL。
- 不要只看单次耗时,还要看 p95、总耗时和调用次数。
- 索引改造要关注写入成本、磁盘占用和已有索引冗余。
- 上线后必须验证业务结果、延迟变化和扫描行数变化。
全流程总览:从慢日志到回归验证
一条完整的慢 SQL 治理链路通常分五步:慢日志发现候选语句,按指纹聚合同类 SQL,用 EXPLAIN 看访问路径,按查询条件设计索引,最后用监控和真实请求回归。
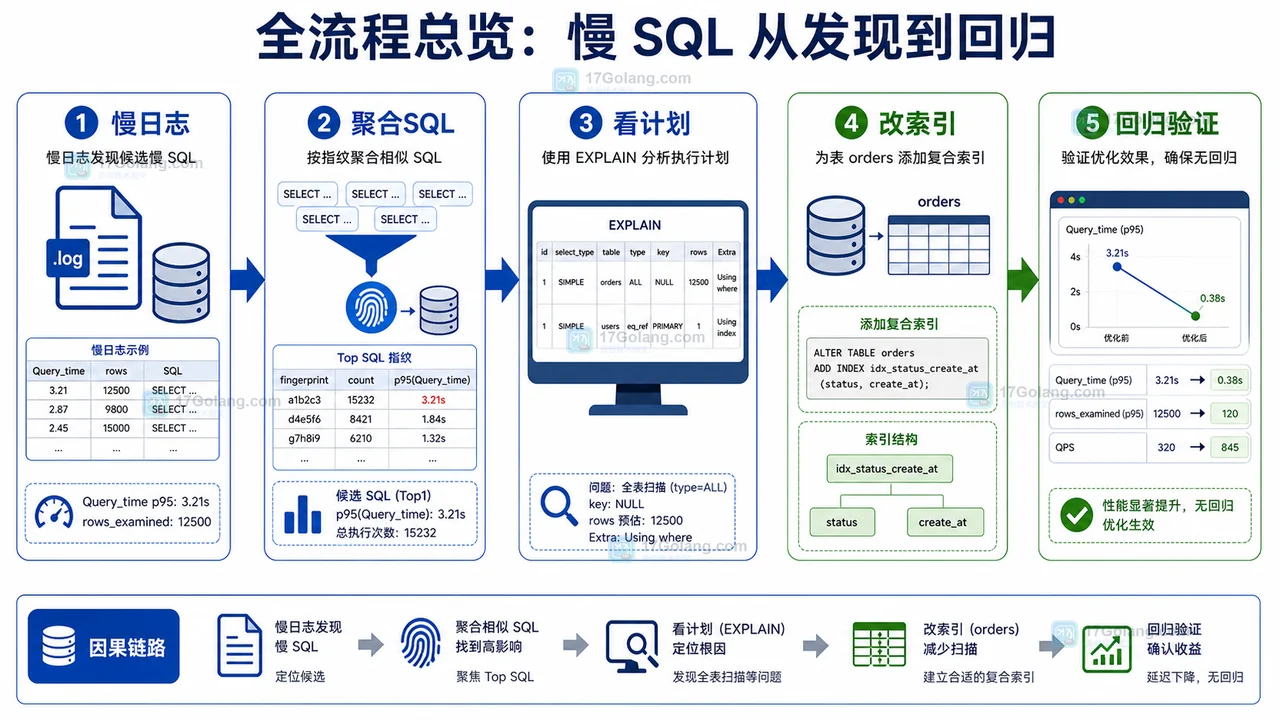
| 阶段 | 目标 | 关键动作 | 检查点 |
|---|---|---|---|
| 发现 | 找出真实慢查询 | 开启慢查询日志,记录耗时和扫描行数 | 能看到 Query_time、Rows_examined |
| 聚合 | 排出优先级 | 按 SQL 指纹归类,统计次数和 p95 | 明确 Top SQL |
| 分析 | 定位访问路径 | 查看 type、key、rows、Extra | 知道是否全表扫描、排序或临时表 |
| 改造 | 减少扫描和排序 | 设计联合索引或改写查询 | 扫描行数下降,索引命中 |
| 回归 | 确认优化有效 | 对比延迟、扫描行数和结果一致性 | 收益稳定,没有新风险 |
阶段一:打开慢查询日志并筛出候选 SQL
目标:先拿到线上真实慢查询,而不是凭感觉猜。
关键动作:确认慢查询日志是否开启,设置合理阈值。测试环境可以短一些,生产环境要结合业务峰值谨慎调整。
SHOW VARIABLES LIKE 'slow_query_log';
SHOW VARIABLES LIKE 'long_query_time';
SHOW VARIABLES LIKE 'slow_query_log_file';
如果需要临时观察,可以在低风险窗口调整阈值:
SET GLOBAL slow_query_log = 'ON';
SET GLOBAL long_query_time = 1;
检查点:日志里至少要看到这些信息:
Query_time: 3.210
Lock_time: 0.001
Rows_sent: 20
Rows_examined: 12500
SET timestamp=1781600000;
SELECT id, status, create_at
FROM orders
WHERE status = 1
ORDER BY create_at DESC
LIMIT 20;
Rows_examined 很高但 Rows_sent 很低,通常说明 MySQL 为了返回少量结果扫描了大量记录,这类查询就值得继续分析。
阶段二:聚合同类 SQL,先处理高影响语句
目标:不要被一两条偶发 SQL 带偏,先找“总耗时高”的查询形态。
关键动作:把参数不同、结构相同的 SQL 聚合在一起。可以用 mysqldumpslow 快速看概况,也可以用日志平台或性能视图做更细统计。
mysqldumpslow -s t -t 10 /var/lib/mysql/slow.log
这个命令会按总耗时排序,取前 10 类语句。排查时建议同时看三个指标:
- count:出现次数,代表影响范围。
- avg time 或 p95:代表单次请求体验。
- rows:代表扫描压力。
检查点:你应该能选出一个明确候选,例如“订单列表查询每天出现 1.5 万次,p95 超过 3 秒,扫描行数一万以上”。到这一步不要急着建索引,先看它当前怎么访问表。
阶段三:用 EXPLAIN 看访问方式和扫描行数
目标:确认慢的原因是全表扫描、索引选择不佳、排序、临时表,还是返回数据本身太多。
EXPLAIN
SELECT id, status, create_at
FROM orders
WHERE status = 1
ORDER BY create_at DESC
LIMIT 20;
常看这几列:
| 列名 | 怎么看 | 常见信号 |
|---|---|---|
| type | 访问方式 | ALL 往往意味着扫描范围大 |
| key | 实际使用索引 | NULL 表示没有命中合适索引 |
| rows | 估算扫描行数 | 远高于返回行数时要警惕 |
| Extra | 额外处理 | Using filesort、Using temporary 需要关注 |
如果看到 type=ALL、key=NULL、rows 很高,说明查询没有走到合适索引;如果同时出现 Using filesort,排序也可能在放大耗时。
阶段四:按 WHERE 与 ORDER BY 设计联合索引
目标:让 MySQL 先通过筛选条件缩小范围,再按索引顺序拿到排序结果,尽量减少回表、扫描和额外排序。
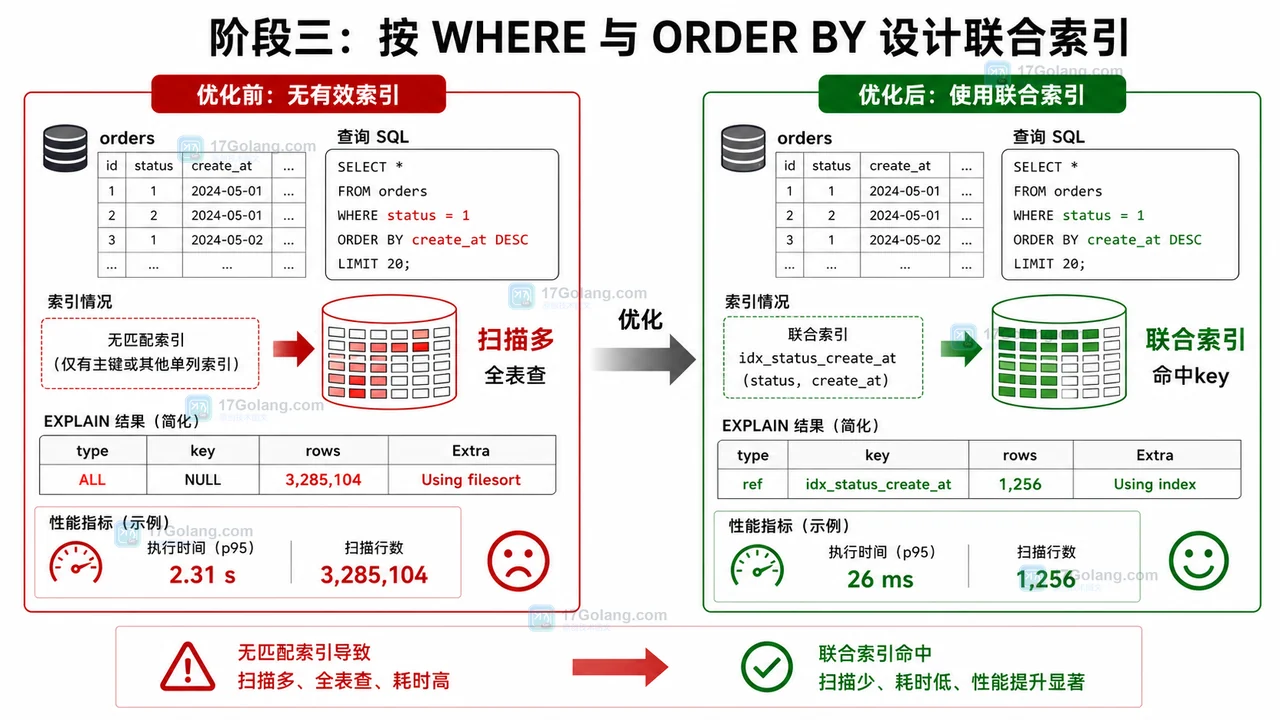
以订单列表为例,查询条件是 status = 1,排序字段是 create_at DESC,可以先考虑联合索引:
ALTER TABLE orders
ADD INDEX idx_status_create_at (status, create_at);
这个索引不是万能模板,而是服务于当前查询形态。设计时可以按下面的顺序判断:
- 等值筛选字段通常放前面,例如
status、tenant_id。 - 范围字段和排序字段要结合查询形态看,避免索引顺序被过早截断。
- 只为真实高频查询建索引,不为每个可能条件都建一个索引。
- 检查是否已有相似索引,避免重复索引增加写入成本。
改完后再次查看:
EXPLAIN
SELECT id, status, create_at
FROM orders
WHERE status = 1
ORDER BY create_at DESC
LIMIT 20;
检查点:理想变化是 key 命中新的联合索引,rows 明显下降,排序开销减少。实际效果仍要以数据分布和真实请求为准。
阶段五:上线前后做回归验证
目标:确认优化收益真实存在,并且没有引入新问题。
上线前可以做三类验证:
- 结果一致性:优化前后返回的数据顺序和条数一致。
- 访问路径:
EXPLAIN里索引命中和扫描行数符合预期。 - 写入影响:确认新增索引不会让高频写入明显变慢。
上线后观察这些指标:
- 接口 p95、p99 是否下降。
- 慢日志中同类 SQL 是否减少。
- 数据库 CPU、IO、锁等待是否稳定。
- 业务错误率和返回结果是否正常。
我的推荐流程
- 先开慢日志或读取现有日志,拿到真实候选 SQL。
- 按 SQL 指纹聚合,优先处理调用多、总耗时高、扫描行数大的语句。
- 复制一条代表性 SQL,用接近生产的数据量查看
EXPLAIN。 - 根据
WHERE、JOIN、ORDER BY和返回字段设计索引。 - 改完后再次看
EXPLAIN,确认key、rows、Extra变化。 - 用业务用例验证结果一致性,再灰度上线。
- 上线后至少观察一个业务高峰,确认慢日志和接口延迟都下降。
容易踩坑的地方
- 只看单次耗时,不看调用次数,导致优化了低影响 SQL。
- 看见慢就加索引,却没有确认当前查询是否真的能用上。
- 联合索引字段顺序凭感觉排,没有结合筛选、排序和数据分布。
- 新增多个相似索引,读性能提升一点,写入和维护成本却上升很多。
- 只在本地小数据量验证,线上数据分布完全不同。
- 上线后没有回归指标,无法判断优化是否真的生效。
落地速查表
| 你看到的现象 | 优先检查 | 可能动作 |
|---|---|---|
| Query_time 高 | 慢日志、接口 p95 | 确认是否高频,再进入分析 |
| Rows_examined 高 | EXPLAIN rows | 减少扫描范围,补合适索引 |
| key 为 NULL | WHERE 和索引字段 | 设计联合索引或调整条件写法 |
| Using filesort | 排序字段和索引顺序 | 让筛选和排序尽量走同一索引 |
| 优化后不稳定 | 数据分布和统计信息 | 补充回归数据,观察线上真实指标 |
慢 SQL 优化最重要的不是记住某个固定索引模板,而是形成稳定判断链路:真实日志发现问题,聚合后确定优先级,计划表定位访问路径,索引或查询改造减少扫描,最后用线上指标证明收益。
 AI 知识库检索不到答案排查:从分块到重排的 RAG 修复流程
- 上一篇
- AI 知识库检索不到答案排查:从分块到重排的 RAG 修复流程
- 下一篇
- Go 1.26.4 安全更新怎么跟进:从版本盘点到回归验证
-
- 数据库 · MySQL | 2天前 |
- MySQL EXPLAIN ANALYZE定位排序临时表的排查方法
- 434浏览 收藏
-
- 数据库 · MySQL | 2天前 | MySQL · JSON ·
- MySQL JSON多值索引处理数组成员检索的设计要点
- 404浏览 收藏
-
- 数据库 · MySQL | 2天前 | MySQL · 数据库 · mysql SQL JSON JSON_TABLE
- MySQL JSON_TABLE为缺失字段提供默认值的映射方法
- 445浏览 收藏
-
- 数据库 · MySQL | 2天前 |
- MySQL CTE拆分多阶段聚合查询的维护方法
- 418浏览 收藏
-
- 数据库 · MySQL | 2天前 | MySQL · 数据库 · mysql 窗口函数 ROW_NUMBER RANK DENSE_RANK
- MySQL窗口函数按分组取排名前N条的查询设计
- 465浏览 收藏
-
- 数据库 · MySQL | 2天前 | MySQL · InnoDB · MySQL锁等待 performance_schema.data_lock_waits data_locks锁对象 InnoDB事务阻塞 锁等待链定位
- MySQL 锁等待定位事务锁等待链的实现方法
- 497浏览 收藏
-
- 数据库 · MySQL | 3天前 | MySQL · 连接池 · database/sql ·
- MySQL 连接池配置连接池避免拿到失效连接的实现方法
- 392浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 184次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 240次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 194次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 175次使用
-

- CMMLU
- 深入了解CMMLU中文评估基准,涵盖67个学科主题,提供数据集下载、Zero-shot/Five-shot评估方法及排行榜,助力优化中文语言模型性能。
- 166次使用
-
- MySQL 明明加了索引,为什么查询还是很慢?先查这 6 个点
- 2026-06-27 374浏览
-
- 接口返回的数据和数据库不一致怎么办?按数据生命周期排查
- 2026-06-27 398浏览
-
- 接口列表页越查越慢怎么办:N+1 查询从 120 次降到 3 次
- 2026-06-29 180浏览
-
- golang MySQL实现对数据库表存储获取操作示例
- 2022-12-22 499浏览
-
- golang 基于 mysql 简单实现分布式读写锁
- 2023-01-07 384浏览


