这篇写一个 Java 线上很常见的线程池事故:接口一慢,队列开始堆,用户已经超时了,后台任务还在慢慢排队执行。很多人以为把 maxPoolSize 调大、队列调大就安全,结果只是把故障藏得更深。
本文适用于 Java 17/21、Spring Boot 3.x、ThreadPoolExecutor、ThreadPoolTaskExecutor。资料只用于核对事实:JDK 线程池由 corePoolSize、maximumPoolSize、BlockingQueue、RejectedExecutionHandler 等共同决定行为;Spring 的 ThreadPoolTaskExecutor 也暴露了 core、max、queueCapacity 等配置。正文按生产复盘写,不搬 API 手册。
业务场景:异步订单任务把队列堆满
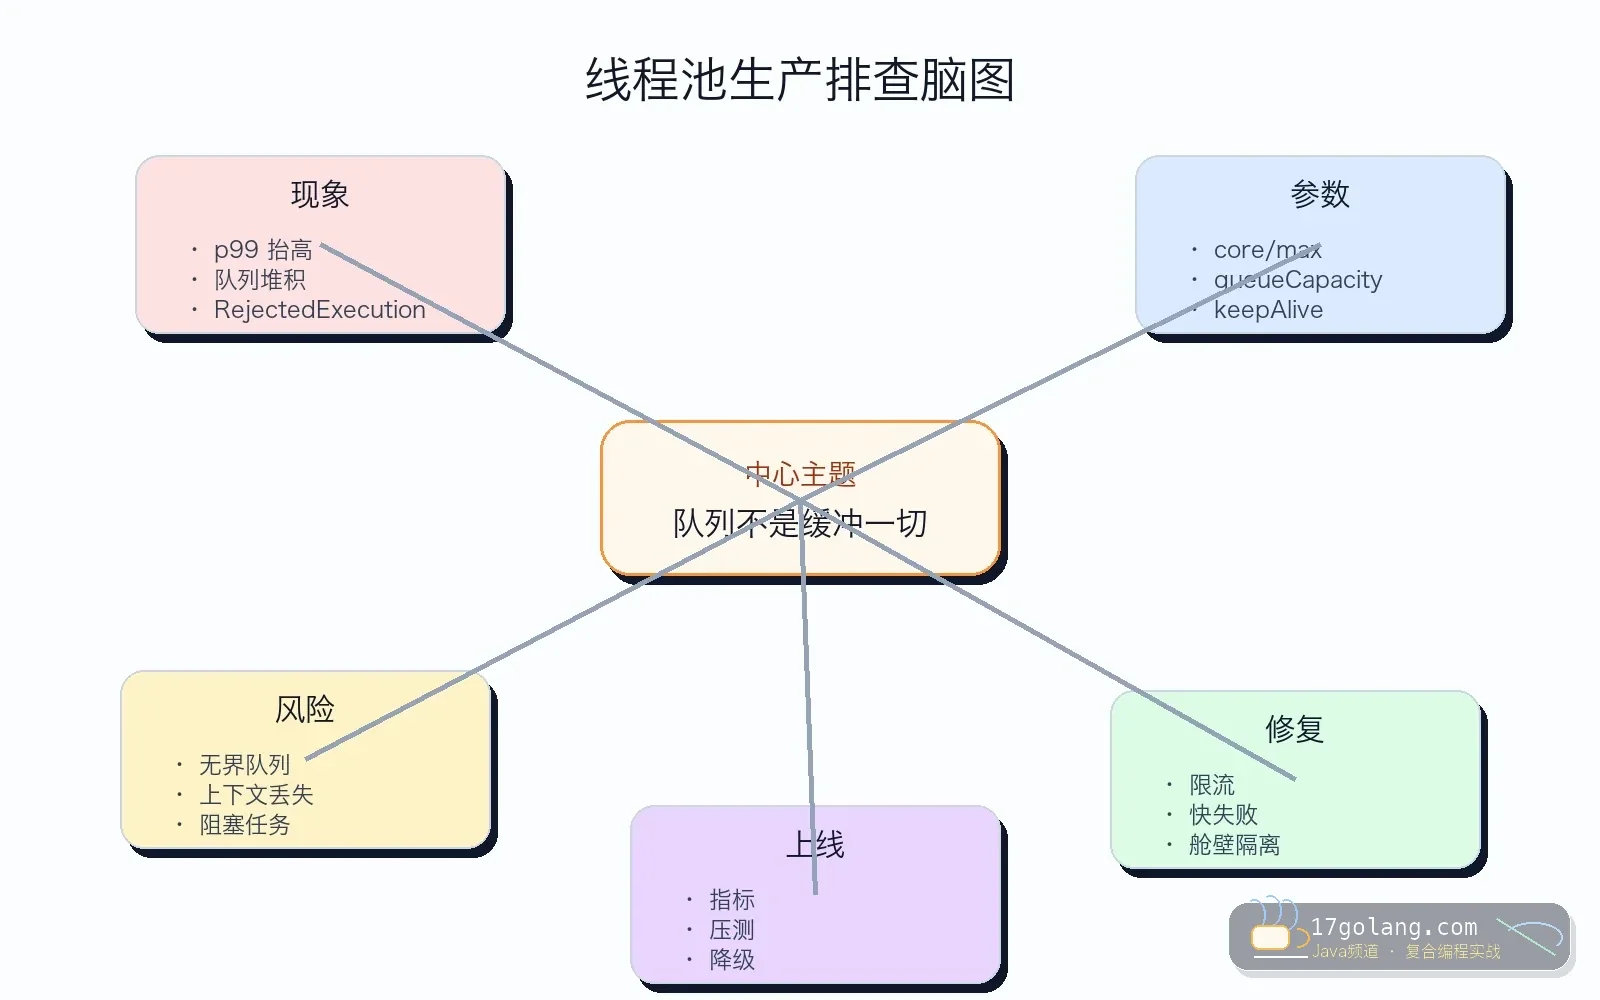
订单提交后会异步做积分、通知、风控补偿。某次下游通知接口变慢,异步线程池队列从几十涨到几千,主流程看起来还能返回,但补偿任务延迟越来越大,最终触发拒绝异常。
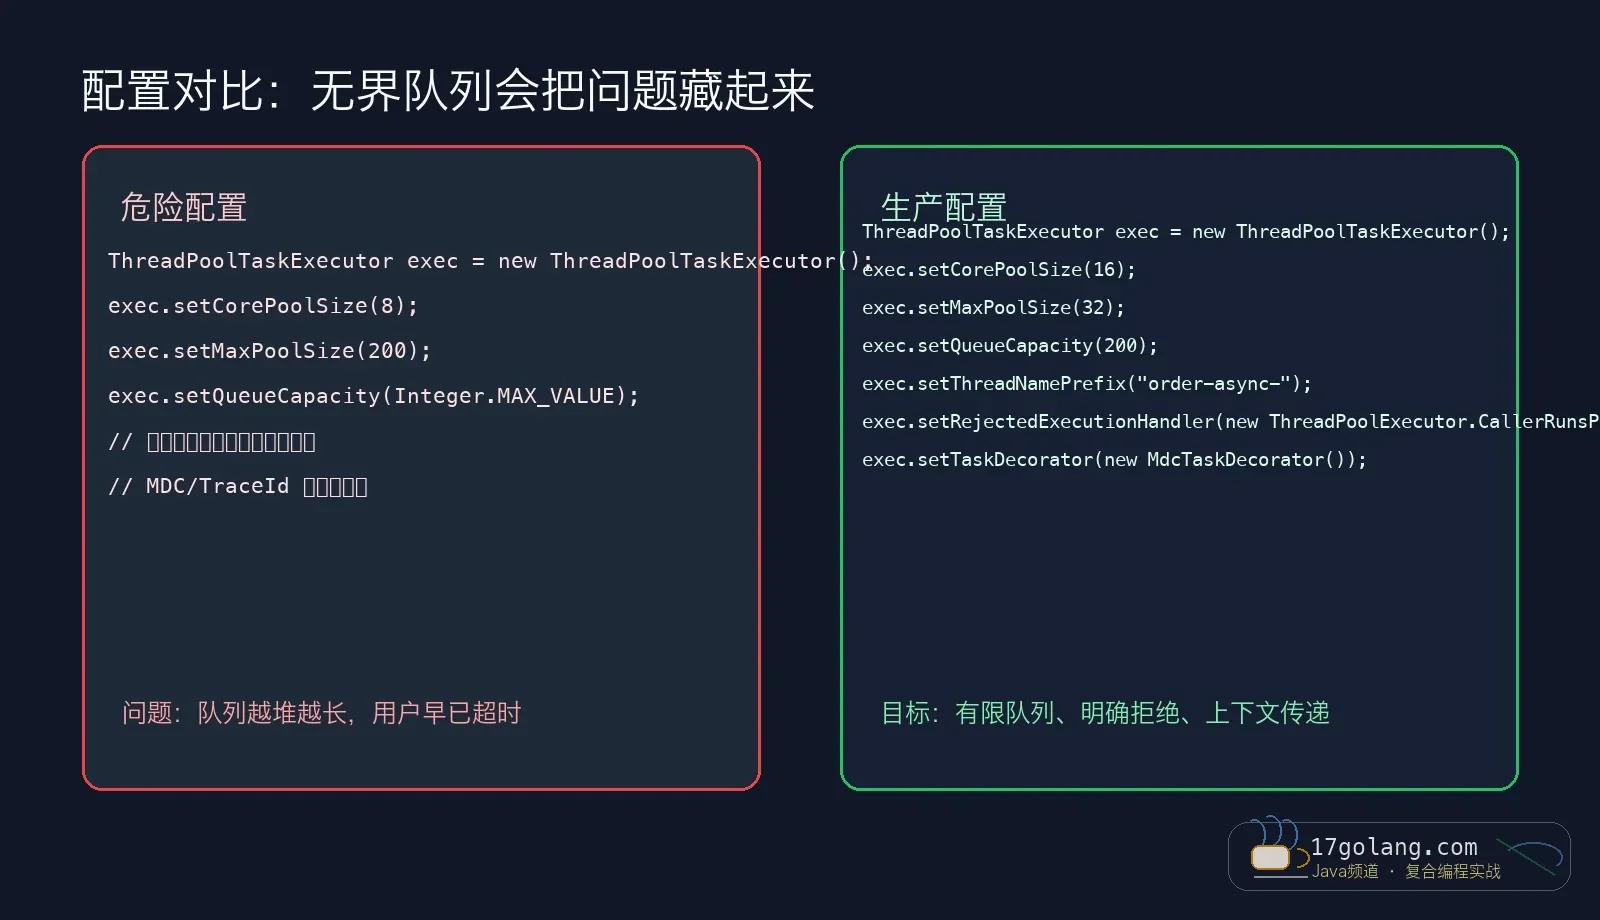
事故复盘时发现,线程池配置非常“豪迈”:最大线程 200,队列接近无界。短期能吞掉突发流量,长期会把延迟、内存和故障影响面一起放大。
问题复现:队列先保护系统,也会拖垮系统
把下游接口延迟设成 800ms,再用 100 QPS 提交异步任务。如果队列很大,前几分钟看不到拒绝,大家会误以为系统扛住了。但用户请求可能早就超时,队列里的任务还在执行过期动作。
线程池不是消息队列。它适合做有界并发,不适合无限缓存业务压力。需要可靠异步,就该用真正的消息队列和幂等消费。
踩坑原因:只看线程数,不看队列时间
很多监控只看 active 线程数,忽略 queue size 和任务等待时间。线程都忙时,队列里的任务等待越久,业务语义越可能过期。比如库存补偿、超时关闭订单、用户通知,延迟几分钟再执行可能已经没意义。
另一个坑是上下文丢失。异步线程里没有 MDC、traceId、租户信息,出了问题日志串不起来。生产线程池必须考虑上下文传递和脱敏。
配置案例:有限队列和明确拒绝
下面这张图展示了常见错误:无界队列吞掉压力,等发现时已经积压很久。生产上我更倾向有限队列、明确拒绝策略、任务耗时指标和降级路径。
@Bean
public ThreadPoolTaskExecutor orderAsyncExecutor() {
    ThreadPoolTaskExecutor executor = new ThreadPoolTaskExecutor();
    executor.setCorePoolSize(16);
    executor.setMaxPoolSize(32);
    executor.setQueueCapacity(200);
    executor.setThreadNamePrefix("order-async-");
    executor.setRejectedExecutionHandler(new ThreadPoolExecutor.CallerRunsPolicy());
    executor.setTaskDecorator(new MdcTaskDecorator());
    executor.initialize();
    return executor;
}
CallerRunsPolicy 不是银弹,它会让提交线程自己执行任务,相当于把压力反馈给入口。对于用户请求链路,要评估是否会拉高响应时间;对于后台调度任务,可能更合适。拒绝策略必须结合业务语义选择。
诊断步骤:我会这样查
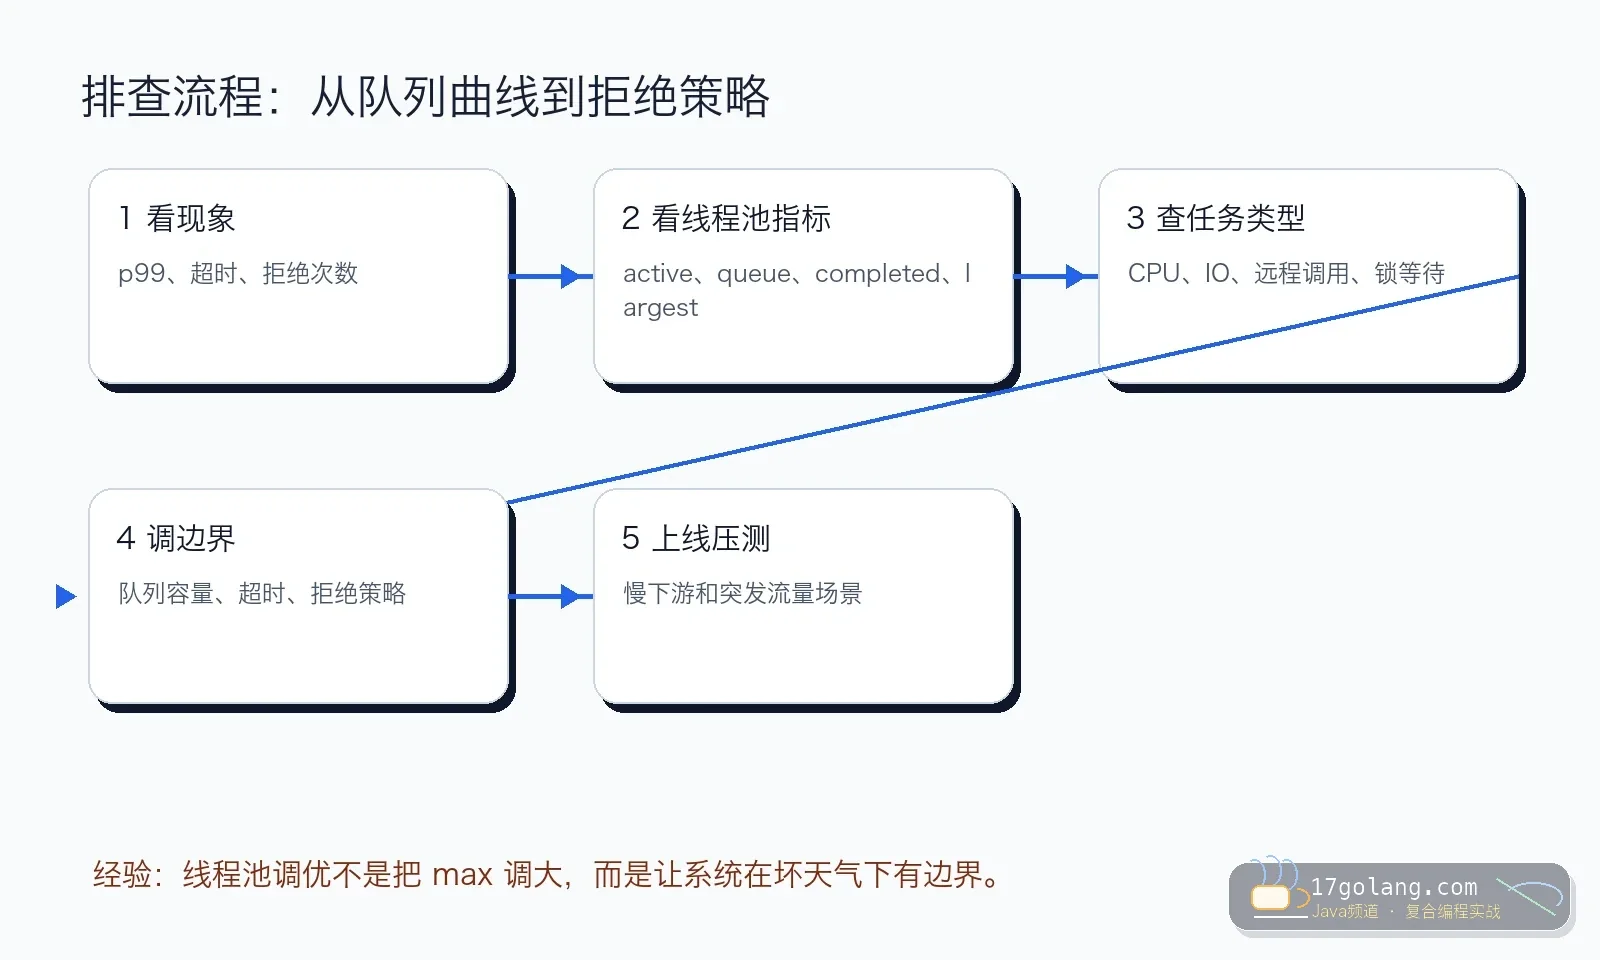
第一步,看 p99 和拒绝次数。 拒绝异常出现时,往往已经晚了。队列长度和等待时间要更早报警。
第二步,看线程池指标。 active、pool size、queue size、completed task、largest pool size 要一起看。
第三步,看任务类型。 CPU 任务、IO 任务、远程调用、锁等待不能混在同一个池里,否则互相拖累。
第四步,看下游慢点。 很多线程池事故根因不在线程池,而是某个下游变慢后没有超时和降级。
第五步,看上下文。 异步日志里是否有 traceId、userId 脱敏标识、业务单号,能不能串回原请求。
上线检查
- 每个业务线程池都命名,不共用默认池。
- 队列容量有限,拒绝策略和降级路径明确。
- 任务有超时,下游调用也有超时。
- 指标覆盖 active、queue、reject、task duration。
- 异步任务传递必要 MDC/traceId,不传敏感明文。
我的经验总结
线程池调优不是把数字调大,而是定义系统在坏天气下怎么退让。有限队列让问题更早暴露,明确拒绝让调用方知道失败,指标让你在用户投诉前发现趋势。
我的建议是:按业务域拆池,按任务类型设边界,按坏天气压测验证。Java 生产系统里,线程池最重要的不是“能跑多少”,而是“跑不动时怎么安全失败”。
 MySQL 8.4 函数索引实战:字段一包函数,索引为什么就不走了