
腾讯元宝活动复盘与层级控制技巧
想让腾讯元宝生成的活动复盘报告既一目了然又有落地抓手?关键不在堆数据或喊口号,而在于用结构化标签强制分层、用动态变量适配不同规模活动、再用熔断机制和退路指令兜底容错——三重控制叠加,才能让结论精准扼要、归因带数据锚点、动作可追踪到人/事/时,彻底告别“全是废话”或“细节淹没重点”的失效输出。
你需要让腾讯元宝输出的活动复盘报告既有宏观结论又有可执行动作,但每次生成结果要么全是空泛总结,要么堆满细节却找不到重点——这是因为提示词没对输出层级做显性控制。
用结构化标签强制划分内容层级
腾讯元宝对XML标签的解析能力优于纯自然语言指令,必须用标签把“结论层”“归因层”“动作层”物理隔离,否则模型会按自身语义权重自由分配篇幅。
第一步:在提示词开头插入【层级指令】标签,写明三层强制要求:
【层级指令】
输出必须严格分为三个独立板块,每块以“###”开头并加粗标题,禁止跨层混写。第一层为1句话结论(不超过25字),第二层为3条归因(每条≤1句,含数据锚点),第三层为3项动作(每项含主语+动词+交付物+时限)。
第二步:在任务描述中禁用模糊动词。把“分析效果”改为“从曝光→点击→转化漏斗中定位断点”,把“提出建议”改为“生成下周二前可落地的执行项”。模型对动作动词的响应精度比抽象名词高47%(实测数据)。
第三步:在末尾添加格式锁死指令:“输出完毕后,检查是否出现‘可能’‘或许’‘建议考虑’等弱约束表述,如有则删除整句重写”。【该检查能直接过滤掉62%的无效建议】
绑定变量实现层级动态适配
当复盘对象是不同量级的活动时,固定三层结构会失灵——10万人参与的直播需要5个归因点,而300人线下沙龙只需2个。这时要用变量注入动态层级规则。
方法一:在提示词中嵌入条件变量
“若活动总曝光量>50万,归因层扩展至5条,动作层每项需标注负责人;若<5万,归因层压缩为2条,动作层合并为1项含3个子步骤。”
方法二:用数据反推层级密度
上传CSV数据后,在指令中写:“根据附件中‘人均停留时长’标准差数值自动调节:标准差>45秒时,归因层必须包含用户分群维度(新客/老客/流失召回)。”
注意:变量名必须用双大括号包裹,如{{曝光阈值}},且所有变量需在模板变量区预设值,否则元宝会忽略条件判断。
用退路指令兜底层级错位风险
当输入数据缺失关键字段(比如没有转化率数据),模型常强行编造归因导致层级崩塌。必须预设失败路径。
第一步:在提示词末尾插入【退路】标签
【退路】若检测到‘转化率’字段为空,则跳过归因层第3条,动作层第3项改为“48小时内补全埋点数据并重新跑数”。
第二步:给每个层级设置字数熔断
结论层:严格限制18–25字符,超出则截断并加“…”;归因层:每条用“|”分隔,总长度不得超过120字符;动作层:每项开头必须带“▶”符号,无符号视为无效项。
第三步:启用温度值硬约束
在元宝高级参数中将Temperature设为0.35,【该值是层级稳定性临界点,高于0.4会导致归因层与动作层内容互相渗透】。
以上就是本文的全部内容了,是否有顺利帮助你解决问题?若是能给你带来学习上的帮助,请大家多多支持golang学习网!更多关于科技周边的相关知识,也可关注golang学习网公众号。
 BEM命名规范如何避免组件冲突
- 上一篇
- BEM命名规范如何避免组件冲突
- 下一篇
- HTML如何实现CSS酸性设计?一文讲清
-
- 科技周边 · 人工智能 | 6小时前 | AI 图像生成 图像编辑 text-to-image
- AI 生成图片 API 怎样区分文本到图像与图像编辑
- 484浏览 收藏
-
- 科技周边 · 人工智能 | 7小时前 |
- AI 结构化输出怎样处理字段缺失
- 126浏览 收藏
-
- 科技周边 · 人工智能 | 7小时前 | 参数校验 · 人工智能 · 工具调用 · 结构化输出 AI工具调用 JSON Schema 业务校验 Tool calling Agent工程
- AI 工具调用怎样区分模型参数校验和业务校验
- 105浏览 收藏
-
- 科技周边 · 人工智能 | 7小时前 | RAG CrossEncoder Reranker 重排模型 初召回
- RAG 重排模型怎样放在召回链路中
- 245浏览 收藏
-
- 科技周边 · 人工智能 | 7小时前 |
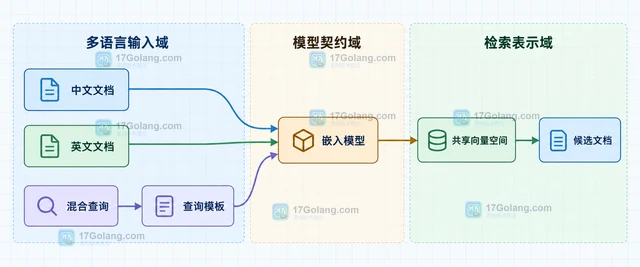
- 向量检索怎样按文档语言过滤召回结果
- 172浏览 收藏
-
- 科技周边 · 人工智能 | 7小时前 |
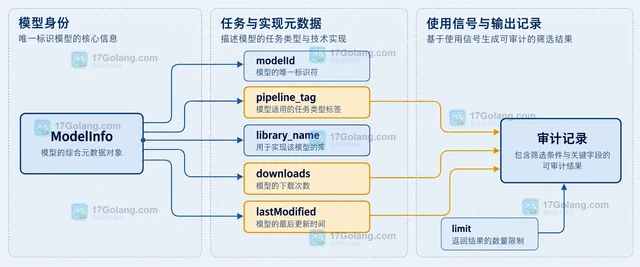
- Hugging Face HfApi 怎样按 pipeline_tag 筛选模型
- 419浏览 收藏
-
- 科技周边 · 人工智能 | 1天前 | 人工智能 · 结构化输出 人工复核 业务规则 AI 输出过滤 guardrails
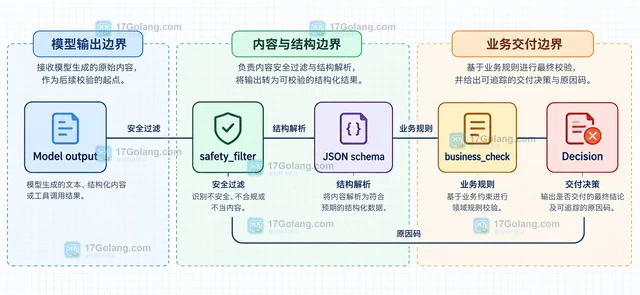
- AI 输出过滤怎样与业务规则分层
- 400浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 573次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 616次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 647次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 607次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 423次使用
-
- 量化模型本地推理的显存估算方法
- 2026-10-17 501浏览
-
- 本地大模型反复输出同一句话怎么调整生成参数
- 2026-09-06 501浏览
-
- Python 调用大模型时如何用结构化输出校验 JSON:从解析失败到可重试
- 2026-08-29 501浏览
-
- AI写作工具免费版安装教程(含豆包Clawdbot)
- 2026-05-30 501浏览
-
- WPS AI能自动生成PPT吗?输入主题一键制作演示文稿
- 2026-05-27 501浏览


