
JavaScriptWorker使用教程:后台线程执行任务详解
JavaScript Worker 是实现浏览器后台多线程任务的关键机制,但它并非“开箱即用”的函数式线程——必须通过独立的 HTTPS 脚本文件初始化,完全隔离于主线程,仅支持通过 postMessage 进行结构化克隆数据通信,且不兼容 alert、localStorage、document 等 DOM API;正确使用需规避 file:// 协议陷阱、合理加载依赖(importScripts)、善用 transferable 对象提升大数据传输效率,并主动 terminate 防止内存泄漏;它虽能解耦耗时计算、保障 UI 流畅,却不是魔法——复杂任务仍需分块处理、谨慎管理生命周期,甚至结合 WebAssembly 或 SharedArrayBuffer 进阶优化。

Worker 构造函数必须传入脚本 URL,不能直接传函数
JavaScript 的 Worker 无法像 Python 的 threading.Thread(target=func) 那样直接传入一个函数执行。它强制要求你把逻辑写在**单独的 JS 文件里**,然后用这个文件路径初始化:
const worker = new Worker('path/to/worker.js');如果你试图写成 new Worker(() => { ... }) 或内联字符串(如 new Worker('console.log(1)')),浏览器会直接抛出 SyntaxError: Failed to construct 'Worker': Script URL must be of scheme 'http' or 'https'。
常见错误场景包括:开发时用 file:// 协议打开 HTML —— 这会导致 Worker 加载失败(CORS 策略限制),必须通过本地服务器(如 python3 -m http.server 或 Vite/Vue CLI 启动)运行。
主线程与 Worker 之间只能靠 postMessage 通信,不能共享变量
Worker 是完全独立的执行上下文,没有 window、document,也无法访问主线程的任何变量。所有数据交换必须显式调用 postMessage(),且只支持结构化克隆(即 JSON 可序列化的值)。Date、RegExp、function、undefined、Map/Set(部分浏览器)、循环引用对象都会被忽略或报错。
实操建议:
- 传递大数据前先
JSON.stringify()+JSON.parse()测试是否可克隆; - 需要频繁通信时,避免发送大对象,改用分块或只传关键字段;
- 主线程监听用
worker.onmessage = e => { ... },Worker 内部用self.onmessage = e => { ... }; - 若需传 ArrayBuffer 或 TypedArray 并避免拷贝,可用
transferable第二参数:worker.postMessage(data, [data.buffer])。
Worker 中不能使用 alert、fetch(旧版 Safari)、localStorage 等主线程 API
Worker 支持的全局对象很有限:self、console、setTimeout、fetch(现代浏览器)、importScripts()、atob/btoa 等。但以下常见操作会失败:
alert()→ 报错ReferenceError: alert is not defined;localStorage.getItem()→ReferenceError: localStorage is not defined;document.querySelector()→ReferenceError: document is not defined;fetch()在 iOS Safari 15.4 之前不支持,需检查兼容性或降级为XMLHttpRequest。
如果任务依赖第三方库(比如 moment.js 或 lodash),不能直接 import,得用 importScripts('lodash.js') 同步加载(注意:这是阻塞的,且不支持 ES 模块语法)。
复杂计算任务要防阻塞,但 Worker 本身不是“自动多线程”
Worker 确实能避免冻结 UI,但它只有一个线程(除非你再嵌套创建 Worker)。如果任务本身是纯 CPU 密集型(如大数组排序、图像像素处理),仍可能让 Worker 线程卡住,导致 postMessage 延迟甚至丢失消息。
优化方向:
- 用
self.onmessage接收后立刻self.postMessage({ status: 'started' }),让主线程知道已响应; - 长任务拆成小块,配合
setTimeout或queueMicrotask让出控制权; - 考虑使用
SharedArrayBuffer+Atomics实现主线程与 Worker 的低开销同步(但需开启跨域策略COOP/COEP头,部署门槛高); - 对 WebAssembly 场景,可把计算逻辑编译为 wasm,再在 Worker 中实例化,性能更稳。
真正容易被忽略的是:Worker 实例一旦创建,就持续运行直到调用 worker.terminate() 或页面卸载。忘记终止长期存活的 Worker,会悄悄吃掉内存和 CPU。
今天关于《JavaScriptWorker使用教程:后台线程执行任务详解》的内容介绍就到此结束,如果有什么疑问或者建议,可以在golang学习网公众号下多多回复交流;文中若有不正之处,也希望回复留言以告知!
:指定要提取的分隔符的位置。](/uploads/20260529/17800270746a190ec28ccb3.jpg) TEXTBEFORE函数是Excel365和Excel2021中新增的函数,用于从文本字符串中提取分隔符之前的内容。它的基本语法如下:TEXTBEFORE(text,delimiter,[instance_num],[match_case])参数说明:text:需要处理的文本字符串。delimiter:分隔符,可以是单个字符或字符串。[instance_num](可选):指定要提取的分隔符的位置。
- 上一篇
- TEXTBEFORE函数是Excel365和Excel2021中新增的函数,用于从文本字符串中提取分隔符之前的内容。它的基本语法如下:TEXTBEFORE(text,delimiter,[instance_num],[match_case])参数说明:text:需要处理的文本字符串。delimiter:分隔符,可以是单个字符或字符串。[instance_num](可选):指定要提取的分隔符的位置。

- 下一篇
- Canvas像素绘图教程详解
-
- 文章 · 前端 | 24分钟前 |
- 前端怎样把非关键任务放到空闲时间
- 458浏览 收藏
-
- 文章 · 前端 | 24分钟前 | 前端 · 性能监控 · javascript · 浏览器API · 静态资源 前端性能 PerformanceObserver PerformanceResourceTiming 资源等待时间
- 前端怎样统计静态资源等待时间
- 215浏览 收藏
-
- 文章 · 前端 | 27分钟前 |
- 前端组件尺寸变化怎样避免循环更新
- 389浏览 收藏
-
- 文章 · 前端 | 27分钟前 |
- 前端怎样观察动态节点并及时断开监听
- 479浏览 收藏
-
- 文章 · 前端 | 30分钟前 |
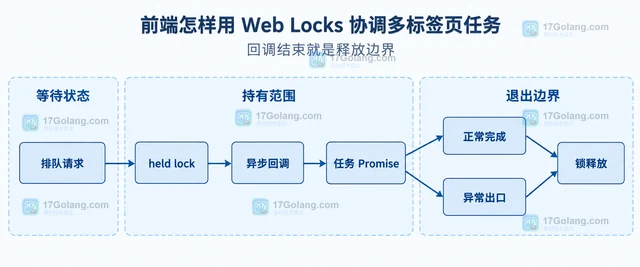
- 前端怎样用 Web Locks 协调多标签页任务
- 329浏览 收藏
-
- 文章 · 前端 | 34分钟前 |
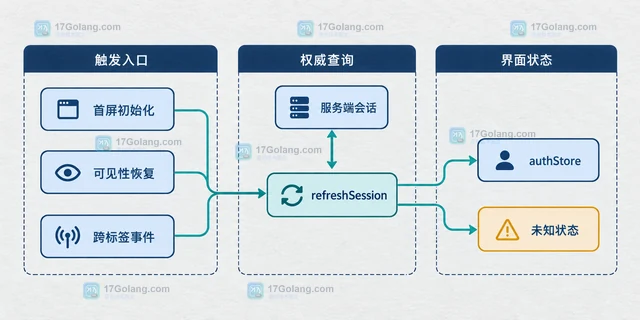
- 前端多个标签页怎样同步登录状态变化
- 243浏览 收藏
-
- 文章 · 前端 | 37分钟前 |
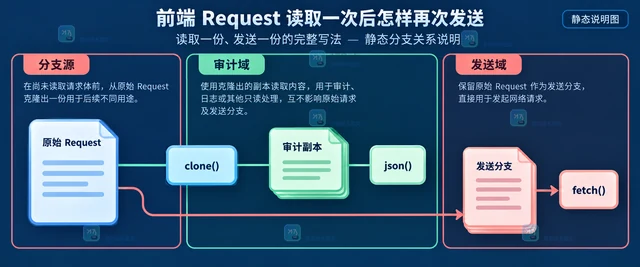
- 前端 Request 读取一次后怎样再次发送
- 301浏览 收藏
-
- 文章 · 前端 | 37分钟前 |
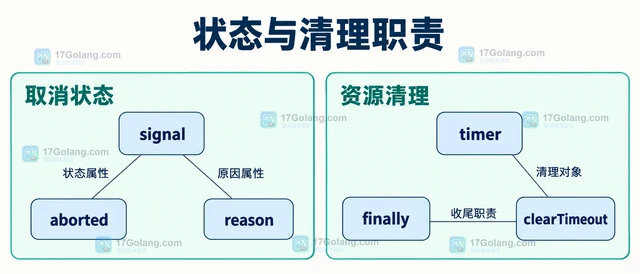
- 前端怎样合并多个取消信号
- 490浏览 收藏
-
- 文章 · 前端 | 17小时前 | 前端 · typescript ·
- TypeScript 自定义类型守卫收窄 API 响应
- 493浏览 收藏
-
- 文章 · 前端 | 17小时前 | 浏览器缓存 首屏加载 依赖图 JavaScript性能 ES module modulepreload
- ES module preload 减少首屏依赖等待的方法
- 254浏览 收藏
-
- 文章 · 前端 | 17小时前 | 环境变量 · javascript · 前端工程 · 敏感信息 前端构建 import.meta.env Vite环境变量 VITE_
- Vite 环境变量暴露边界与构建替换
- 256浏览 收藏
-
- 文章 · 前端 | 17小时前 |
- 前端用 PerformanceObserver 采集核心指标的结构
- 298浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 510次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 570次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 596次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 548次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 364次使用
-
- JavaScript函数定义及示例详解
- 2025-05-11 502浏览
-
- 智能体安全引领产业升级——国内AI安全产品市场深度分析
- 2026-08-21 501浏览
-
- CSS变量简化按钮悬停效果技巧
- 2026-05-31 501浏览
-
- JavaScript符号类型详解与应用
- 2026-05-31 501浏览
-
- HTML剪贴板复制粘贴怎么用
- 2026-05-26 501浏览