
G1 GC Region 活跃度分析与缓存优化技巧
本文深入剖析了G1垃圾收集器在缓存类应用(如电商商品、会话、店铺缓存)中遭遇的Mixed GC性能瓶颈,直击核心矛盾:并非对象存活率高导致GC停顿,而是Remembered Set(RSet)因高频跨Region引用(如本地Map中大量Value指向其他Region)而急剧膨胀,引发RSet扫描耗时飙升(>20ms)或内存占比超堆1.5%;文章给出一套实战级优化组合拳——精准调优RegionSize以匹配缓存块大小(如4MB缓存块设为4M Region)、收紧Old CSet准入阈值至5%、拉长Mixed GC轮次以捕获冷缓存、收拢缓存写入降低RSet并发更新,并警示大对象误入Humongous区、软引用清理过激、RSet线程不足等隐性陷阱,帮助开发者从“看GC日志”跃升到“读懂缓存与Region的共生关系”。

Region 活跃度高但 GC 停顿不降,说明 RSet 扫描成了瓶颈
缓存类应用(如商品、店铺、会话)常出现“Region 分配多、存活对象少、但 Mixed GC 耗时飙升”的现象。这不是因为对象没回收,而是每个 Region 的 Remembered Set(RSet)被高频更新——比如本地缓存 Map 里存了大量跨 Region 引用的 Value 对象,每次更新都会触发 write barrier,导致 RSet 条目暴涨。
关键判断:RSet 内存占比超过堆的 1.5% 或 GC 日志中 [RSet: XMB, Y entries] 后紧跟 [scan: Zms] 超过 20ms,基本可确认是 RSet 扫描拖慢 Mixed GC。
- 用
jstat -gc查看HU(Humongous Used)列,若持续 >5%,说明大对象频繁,RegionSize 太小,被迫进 Humongous 区,绕过 RSet 管理,反而让引用关系漏检 - 加
-Xlog:gc+remset*=debug(JDK 11+),重点观察Total remembered set memory占比和Scanned cards per region是否集中在少数几个 Region - 避免用
-XX:+PrintGCDetails试图找“卡表命中率”——G1 已弃用全局 Card Table,日志里没有这个指标
RegionSize 不是越大越好,得匹配缓存块大小
电商小时购系统批量更新商品缓存时,常分配 2–8MB 的 PooledByteBuf 或 byte[] 缓冲区。若仍用默认 1MB Region,一个缓冲区就得跨 2–8 个 Region,每个 Region 都要维护指向它的 RSet 条目,引用密度翻倍。
实测有效策略:把 -XX:G1HeapRegionSize 设为常见缓存块大小的 1.2 倍,例如:
- 主流缓存块为 4MB → 设
-XX:G1HeapRegionSize=4M - 存在较多 6MB 商品快照 → 设
-XX:G1HeapRegionSize=8M(必须是 2 的幂) - 若
jstat显示 Young GC 频次骤增、Eden 区 Region 数跳变,说明G1NewSizePercent和G1MaxNewSizePercent未同步调整,需用jstat -gc验证新生代 Region 实际数量
混合回收(Mixed GC)阶段优先级错位,导致老缓存滞留
G1 回收不是按“代”而是按 Region 活跃度排序。缓存系统里,刚写入的热点数据(如新上架商品)和长期未访问的冷数据(如半年前下架商品)可能混在同一个 Old Region 里。G1 默认按“垃圾占比”选 Region,结果冷数据 Region 因存活率低被优先回收,而真正该清理的旧缓存(因引用链长、存活率虚高)却被跳过。
解决办法不是关掉 Mixed GC,而是引导它盯住缓存生命周期:
- 给缓存对象加业务标记字段(如
cacheTTL),在 GC 前主动System.gc()触发一次并发标记,再用-XX:G1MixedGCCountTarget=8(默认 8)拉长 Mixed GC 轮次,让冷数据有更多机会暴露 - 若使用
WeakReference或SoftReference管理缓存,注意 G1 对软引用的清理策略更激进,-XX:SoftRefLRUPolicyMSPerMB可能需要调小(如设为 1000) - 禁用
-XX:G1OldCSetRegionThresholdPercent的默认值(默认 10%),对缓存密集型服务设为 5%,让更小比例的“低价值” Old Region 进入回收集
Region 划分影响跨节点缓存一致性延迟
分布式缓存更新常伴随远程调用(如发 MQ、调下游服务)。这些调用对象(如 KafkaProducerRecord、OkHttpClient 请求体)若分配在不同 Region,且彼此强引用,就会推高 RSet 更新频率。更隐蔽的问题是:RSet 更新本身不保证顺序,当多个线程并发修改跨 Region 引用时,可能导致某次 Mixed GC 扫描到“半更新”状态,进而漏掉应清理的缓存条目。
这不是 GC bug,而是设计约束。缓解方式很务实:
- 把缓存写入逻辑尽量收拢到单个线程或 Actor 模型中,减少跨 Region 引用的并发写入点
- 避免在
finalize()或 Cleaner 中做缓存清理——G1 下finalize触发不可控,容易堆积 - RegionSize 改动后,务必验证
G1ConcRefinementThreads(默认 3)是否足够:若日志中频繁出现Concurrent refinement overflow,说明 RSet 更新线程跟不上,需设为 CPU 核数的 1/4
Region 活跃度分析不能只看 GC 日志里的“回收了多少”,得结合缓存访问模式反推哪些 Region 其实是“伪活跃”——比如一个 Region 里全是 String key 和 WeakReference value,它物理上没多少垃圾,但 RSet 会被反复更新,这种 Region 就是隐形瓶颈。
好了,本文到此结束,带大家了解了《G1 GC Region 活跃度分析与缓存优化技巧》,希望本文对你有所帮助!关注golang学习网公众号,给大家分享更多文章知识!
 CSS实现移动端滑动标签页效果
- 上一篇
- CSS实现移动端滑动标签页效果
- 下一篇
- Windows免费视频播放器推荐,自带与第三方全解析
-
- 文章 · java教程 | 1天前 | Java · ServiceLoader module-info.java Java模块
- Java 模块服务加载的可选实现与回退路径
- 363浏览 收藏
-
- 文章 · java教程 | 2天前 |
- Java VarHandle 内存序选择与可见性验证
- 226浏览 收藏
-
- 文章 · java教程 | 2天前 |
- Java JFR 事件流定位短时延迟尖峰
- 213浏览 收藏
-
- 文章 · java教程 | 2天前 |
- Java Record 序列化兼容字段演进方案
- 483浏览 收藏
-
- 文章 · java教程 | 2天前 |
- Java ServiceLoader 隔离模块化插件实现
- 414浏览 收藏
-
- 文章 · java教程 | 2天前 |
- Java Pattern Matching switch 处理密封层级
- 189浏览 收藏
-
- 文章 · java教程 | 2天前 | Stream · Java教程 · java Stream Collector Collectors.teeing 统计汇总
- Java Collectors.teeing 汇总两条统计管道
- 385浏览 收藏
-
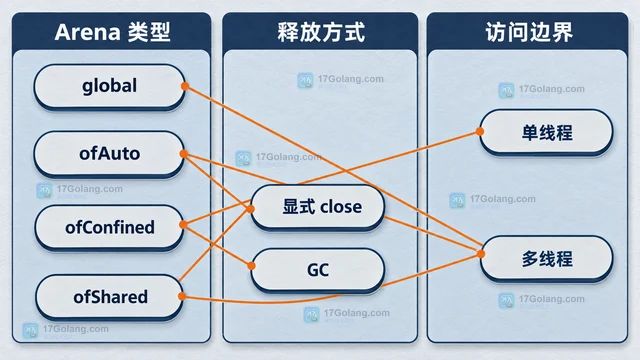
- 文章 · java教程 | 2天前 |
- Java Foreign Function Memory API 管理本地内存生命周期
- 385浏览 收藏
-
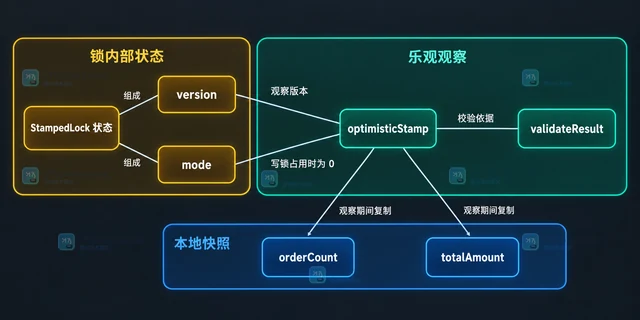
- 文章 · java教程 | 2天前 |
- Java StampedLock 乐观读校验失败的回退方式
- 165浏览 收藏
-
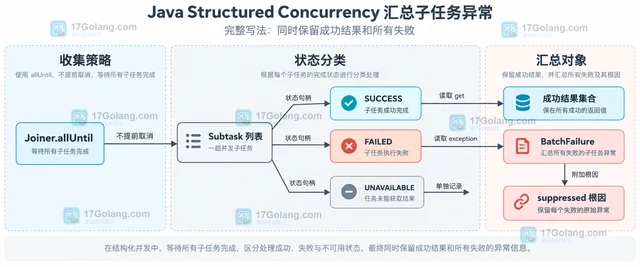
- 文章 · java教程 | 2天前 | 异常处理 · 并发编程 · Java教程 · StructuredTaskScope Java Structured Concurrency Joiner allUntil 子任务异常 聚合异常
- Java Structured Concurrency 汇总子任务异常
- 260浏览 收藏
-
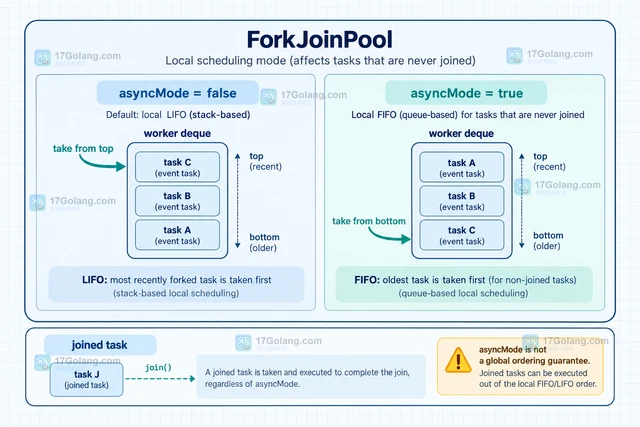
- 文章 · java教程 | 2天前 |
- Java ForkJoinPool asyncMode 调整任务队列顺序
- 121浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 444次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 516次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 529次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 474次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 300次使用
-
- Java try-with-resources 多个资源关闭顺序是什么
- 2026-09-10 501浏览
-
- 矩阵主副对角线快速定位技巧
- 2026-05-31 501浏览
-
- Java多态优化流程代码与行为分发改进
- 2026-05-26 501浏览
-
- JVM 类元数据双亲委派链表深度解析
- 2026-05-21 501浏览
-
- 反射异常处理:InvocationTargetException解析与应用
- 2026-05-16 501浏览


