
多线程zlib压缩内存占用分析
多线程 zlib 压缩的内存开销远比直觉中低得多——zlib 自身每线程仅需约 256 KB 固定工作内存,与输入数据大小无关;真正决定内存占用的是开发者主动分配的原始数据和压缩结果缓冲区,而非 zlib 内部机制。这意味着在 Go 中并发压缩大量数据时,只要合理复用缓冲区、避免为每个 goroutine 预留冗余空间,就能以极小的额外内存代价实现高效并行压缩,彻底打破“线程数 × 输入大小 = 内存爆炸”的常见误解。
多线程并行执行 zlib 压缩时,实际内存占用远低于输入数据总和;核心开销来自原始数据与压缩结果的缓冲区,zlib 自身每线程仅需约 256 KB 内存。
在 Go 中使用 zlib(如通过 compress/zlib 包)对大量数据进行并发压缩时,开发者常误以为“10 线程 × 100 MB 输入 = 至少 1 GB 内存占用”,进而担忧内存溢出或性能瓶颈。实际上,这一估算严重高估了真实内存需求——关键在于区分用户数据缓冲区与zlib 内部工作内存。
✅ zlib 自身内存开销极小
根据 zlib 官方技术文档 的 “Memory Footprint” 章节,zlib 在默认配置(Z_DEFAULT_COMPRESSION)下,每个压缩流(即每个 zlib.Writer 实例)所需的内部工作内存上限约为 256 KB。该内存用于滑动窗口、哈希表、压缩状态等,且与输入数据大小无关。即使压缩 100 MB 或 1 GB 数据,单个 zlib 流的固定开销仍稳定在此量级。
⚠️ 真正的内存主力:你的输入/输出缓冲区
若你为每个 goroutine 分配独立的 []byte 存储 100 MB 原始数据,并预留同等或更大空间存放压缩后数据(例如 make([]byte, 0, 100<<20)),那么这部分用户缓冲区才是内存消耗主体。例如:
// 示例:每个 goroutine 持有原始数据 + 预估压缩缓冲区
data := make([]byte, 100<<20)           // 100 MB 原始数据(必须)
buf := make([]byte, 0, 50<<20)          // 预留 50 MB 输出缓冲(典型压缩率 2:1)

var b bytes.Buffer
zw := zlib.NewWriter(&b)
zw.Write(data)   // 数据拷贝进 zlib 内部缓冲(非额外 100 MB!)
zw.Close()
compressed := b.Bytes() // 最终结果,可复用 buf 切片
注意:zw.Write(data) 并不会复制一份完整的 data 到 zlib 内部——它仅按需读取、分块处理,并利用内部环形缓冲区(≤256 KB)完成压缩。因此,zlib 不会为每份 100 MB 输入额外分配同量内存。
? 实测建议与优化策略
- 使用 runtime.ReadMemStats() 监控 AllocBytes 和 Sys,验证实际增长是否接近 10 × (100 MB + 输出缓冲),而非 10 × (100 MB + 100 MB + 256 KB);
- 复用 []byte 缓冲池(如 sync.Pool)避免频繁 GC,尤其适用于固定大小场景;
- 对超大文件,优先采用流式处理(io.Pipe + zlib.NewWriter),避免一次性加载全部数据到内存;
- 若内存极度受限,可调低 zlib.BestSpeed 级别(减少窗口大小),进一步压低 zlib 内部开销(最低可至 ~16 KB/流)。
? 总结:1 GB RAM 完全可支撑 10 线程并发压缩 100 MB 数据——只要合理管理用户缓冲区(例如复用、分块、及时释放),zlib 自身带来的内存压力可忽略不计。真正决定成败的,是你如何组织数据生命周期,而非压缩算法本身。
以上就是《多线程zlib压缩内存占用分析》的详细内容,更多关于的资料请关注golang学习网公众号!
 AI写作怎么让内容更有节奏感?押韵金句指令大公开!
- 上一篇
- AI写作怎么让内容更有节奏感?押韵金句指令大公开!

- 下一篇
- setTimeout与setImmediate执行顺序解析
-
- Golang · Go教程 | 1小时前 | Go教程 · Go encoding/xml 空元素 指针字段
- Go encoding/xml 空元素与指针字段的处理方式
- 142浏览 收藏
-
- Golang · Go教程 | 1小时前 | Go教程 · Go encoding/xml 字段映射 Unmarshaler
- Go encoding/xml 自定义 Unmarshaler 的字段映射
- 189浏览 收藏
-
- Golang · Go教程 | 1小时前 |
- Go encoding/xml Token 流式读取大型 XML
- 424浏览 收藏
-
- Golang · Go教程 | 2小时前 | go · encoding/json · JSON Go encoding/json omitempty
- Go encoding/json omitempty 对零值字段的输出边界
- 192浏览 收藏
-
- Golang · Go教程 | 2小时前 |
- Go encoding/json Decoder Token 流式读取嵌套结构
- 364浏览 收藏
-
- Golang · Go教程 | 3小时前 |
- Go encoding/json Decoder UseNumber 保留大整数精度
- 328浏览 收藏
-
- Golang · Go教程 | 3小时前 |
- Go fmt.Scanner 自定义扫描规则的实现要点
- 182浏览 收藏
-
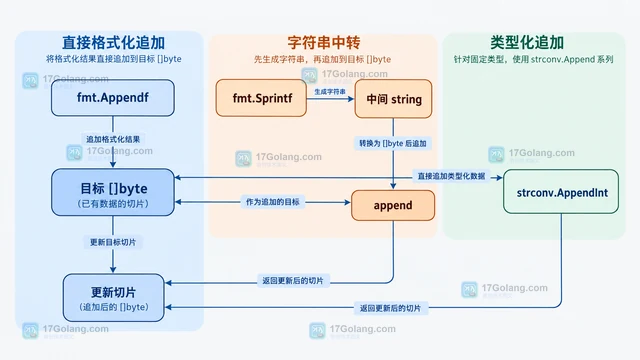
- Golang · Go教程 | 4小时前 |
- Go fmt.Appendf 追加格式化结果的低分配写法
- 478浏览 收藏
-
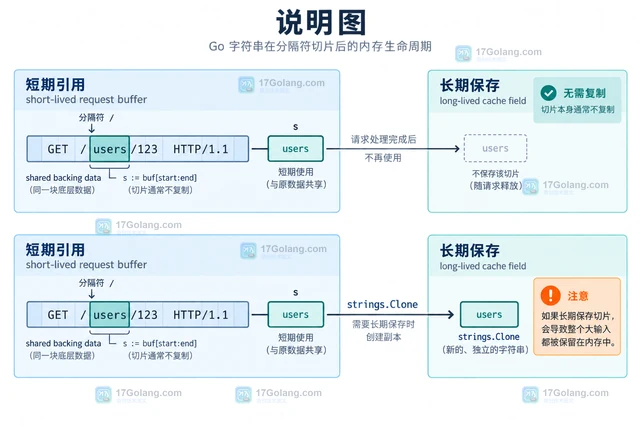
- Golang · Go教程 | 4小时前 |
- Go strings.IndexByte 定位协议分隔符的低分配写法
- 413浏览 收藏
-
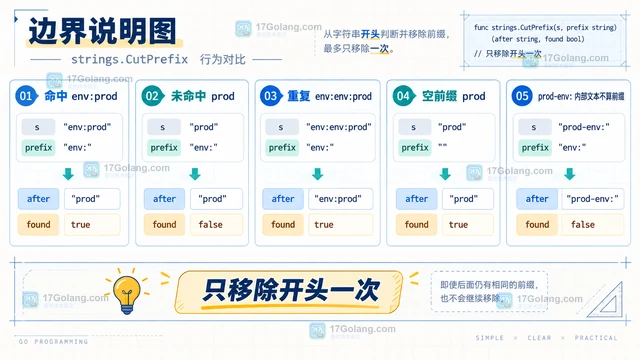
- Golang · Go教程 | 5小时前 | go · Strings · Go 字符串前缀 strings.CutPrefix
- Go strings.CutPrefix 处理可选前缀的分支设计
- 165浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 258次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 304次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 283次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 261次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 68次使用
-
- Java 性能优化上线清单:从定位、改造到灰度发布
- 2026-06-11 860浏览
-
- Spring Boot 压测验证:Gatling、JMeter 与性能回归门禁
- 2026-06-11 843浏览
-
- Java NMT 非堆内存排查:Direct Buffer、线程栈与 Metaspace 分析
- 2026-06-11 826浏览
-
- Spring Boot 容器内存优化:JVM 堆、非堆与 MaxRAMPercentage
- 2026-06-11 809浏览
-
- Tomcat 连接与线程参数调优:maxThreads、acceptCount 与 KeepAlive
- 2026-06-11 792浏览