
SynchronousQueue公平与非公平模式解析
SynchronousQueue 的公平与非公平模式本质是吞吐与顺序确定性之间的权衡:公平模式通过 FIFO 队列(TransferQueue)严格按调用时序匹配线程,保障响应可预测,适合音视频调度、金融撮合等对延迟抖动敏感的场景,但以更高上下文切换和 CAS 开销为代价,吞吐更低;非公平模式则采用 LIFO 栈(TransferStack),实现就近配对、缓存友好、单次操作更轻量,显著提升高并发短任务场景下的吞吐(常高出20%~40%),却可能导致老线程饿死——而 JDK 默认非公平并非随意设计,而是源于真实业务中绝大多数场景(如 Spring 线程池、Dubbo 消费端)更看重整体性能与资源效率;真正关键的决策点,不在于盲目追求“公平”,而在于通过压测、线程堆栈分析和延迟波动监控,冷静判断你的业务是否真的存在不可妥协的顺序敏感性。
公平模式下 SynchronousQueue 是怎么排队的
公平模式用的是 FIFO 队列,谁先 put 或 take,谁就优先匹配。比如线程 A 调用 put 后阻塞,线程 B 紧接着调用 take,那它们立刻配对;但如果线程 C 在 B 之前也调用了 take,C 就排在 B 前面——顺序严格按调用时间。
实际中容易误以为“公平 = 执行快”,其实它牺牲吞吐换确定性:多个线程竞争时,上下文切换更频繁,put/take 平均耗时会上升。
- 构造时显式指定:
new SynchronousQueue(true) - 不传参默认是非公平(
new SynchronousQueue()等价于new SynchronousQueue(false)) - JDK 9+ 中公平模式底层用
TransferQueue实现,非公平用TransferStack
非公平模式为什么默认用栈结构
非公平模式本质是 LIFO,后进先出。最新来的 put 线程会优先和最新来的 take 线程配对,跳过前面排队的线程。这带来两个关键效果:缓存局部性更好、线程唤醒更集中,所以吞吐更高。
但副作用明显:老线程可能饿死。比如一个慢消费者反复 take 失败,新生产者不断涌入,它就一直卡在队列头动不了。
- 栈结构让匹配逻辑变成“就近配对”,减少跨核缓存同步开销
- 在高并发短任务场景(如 ForkJoinPool 工作窃取),非公平性能通常高出 20%~40%
- 错误现象:
Thread.getState()长期显示WAITING,但堆栈里没别的线程在等——大概率是被新请求持续插队
TransferStack 和 TransferQueue 的实现差异在哪
这两个类不是 public API,但理解它们能解释行为差异。前者是无锁栈,靠 CAS 修改栈顶指针;后者是带哨兵节点的双向链表,插入/删除都要更新前后指针。
栈结构单次操作平均只需 1 次 CAS,队列往往要 2~3 次——这就是非公平模式更快的底层原因。不过栈对 GC 更友好:节点生命周期短,基本不进入老年代。
TransferStack节点有WAITING/FULFILLING两种状态,状态转换靠自旋 + CASTransferQueue节点必须维护prev/next引用,对象体积更大,且链表遍历有 cache miss 风险- 从 JDK 8 到 JDK 17,两者的 CAS 失败重试策略越来越激进,非公平优势进一步放大
什么时候该强制用公平模式
只有当你明确需要响应顺序可预测时才选公平模式,比如实时音视频帧调度、金融订单撮合这类对延迟抖动敏感的场景。
多数业务代码根本不需要——Spring 的 ThreadPoolTaskExecutor 默认用非公平 SynchronousQueue,Dubbo 的消费端线程池也是。盲目切公平,反而可能把 P99 延迟拉高一倍。
- 典型信号:监控发现
take平均等待时间波动极大(>5ms),且线程 dump 显示大量WAITING on java.util.concurrent.SynchronousQueue$TransferStack - 测试时别只看吞吐,用
jstack抓几次现场,确认阻塞线程是否真的按预期顺序唤醒 - 公平模式无法解决“生产者太快、消费者太慢”的根本问题,只是让慢线程饿得更规律
真正难的不是选公平还是非公平,而是判断你的场景到底有没有顺序敏感性。很多所谓“要公平”的需求,其实是没压测过非公平的真实表现。
本篇关于《SynchronousQueue公平与非公平模式解析》的介绍就到此结束啦,但是学无止境,想要了解学习更多关于文章的相关知识,请关注golang学习网公众号!
 Vue生命周期钩子图解及执行顺序
- 上一篇
- Vue生命周期钩子图解及执行顺序
- 下一篇
- 蓝屏unmountable_boot_volume解决方法
-
- 文章 · java教程 | 19小时前 |
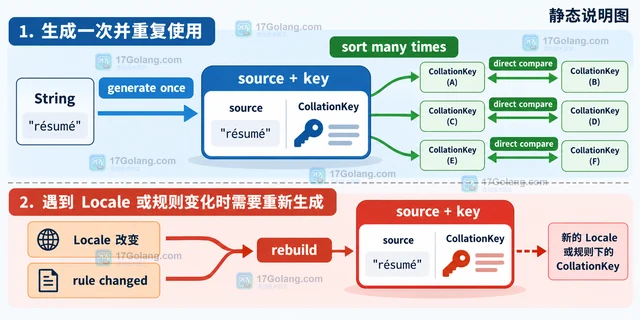
- Java CollationKey 怎样缓存多次字符串排序的比较键
- 339浏览 收藏
-
- 文章 · java教程 | 19小时前 | Java · 格式化 · Java教程 · java messageformat 数字范围 ChoiceFormat 临界值
- Java ChoiceFormat 的小于号和井号怎样划分临界值
- 203浏览 收藏
-
- 文章 · java教程 | 19小时前 | Java · 格式化 · Java教程 · java messageformat 数字范围 提示文本 ChoiceFormat
- Java ChoiceFormat 怎样把数字范围映射为提示文本
- 159浏览 收藏
-
- 文章 · java教程 | 19小时前 |
- Java AttributedCharacterIterator 怎样按属性区间遍历文本
- 150浏览 收藏
-
- 文章 · java教程 | 19小时前 | java AttributedString 字符属性
- Java AttributedString 怎样为局部字符范围添加属性
- 464浏览 收藏
-
- 文章 · java教程 | 19小时前 |
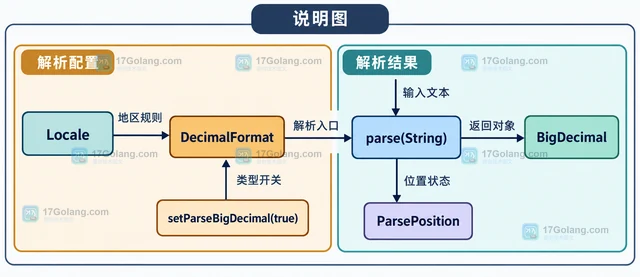
- Java DecimalFormat 怎样把解析结果直接保留为 BigDecimal
- 254浏览 收藏
-
- 文章 · java教程 | 19小时前 |
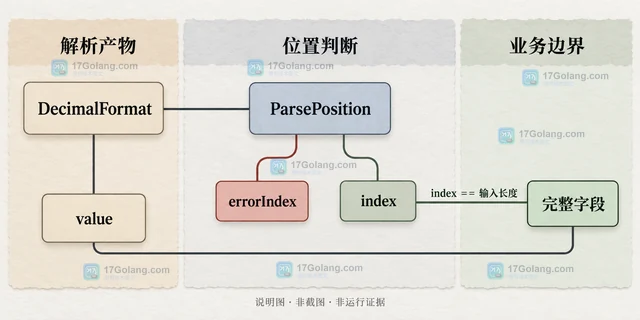
- Java DecimalFormat 的 parse 为什么可能只消费输入前缀
- 351浏览 收藏
-
- 文章 · java教程 | 19小时前 | 配置文件 · Java教程 · java UTF-8 Properties charset storeToXML XML配置
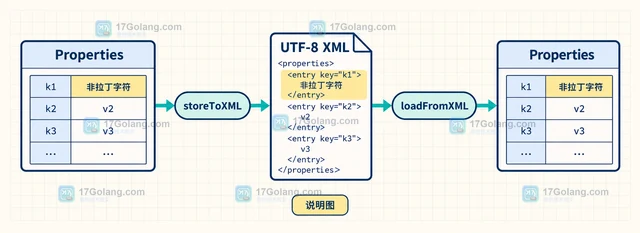
- Java Properties.storeToXML 怎样保存带非拉丁字符的配置
- 321浏览 收藏
-
- 文章 · java教程 | 19小时前 |
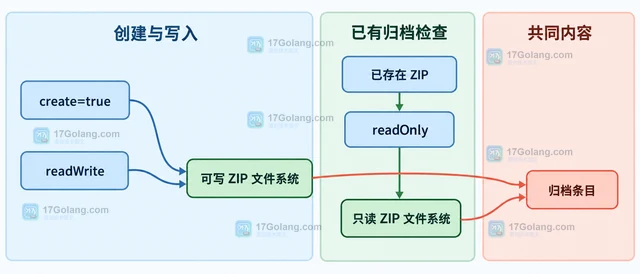
- Java ZIP 文件系统怎样在打开时创建不存在的归档
- 137浏览 收藏
-
- 文章 · java教程 | 19小时前 |
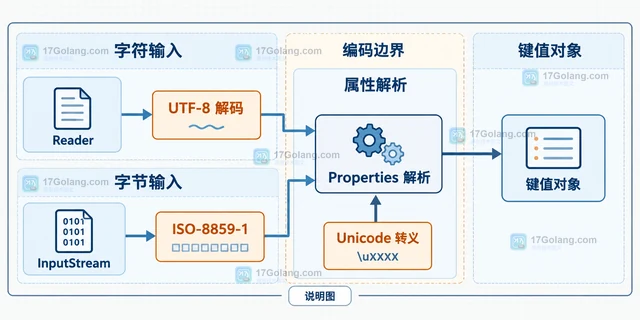
- Java Properties.load Reader 和 InputStream 的编码有什么区别
- 229浏览 收藏
-
- 文章 · java教程 | 19小时前 |
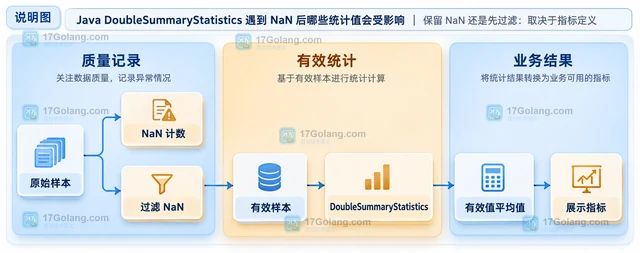
- Java DoubleSummaryStatistics 遇到 NaN 后哪些统计值会受影响
- 496浏览 收藏
-
- 文章 · java教程 | 19小时前 | java DoubleSummaryStatistics combine
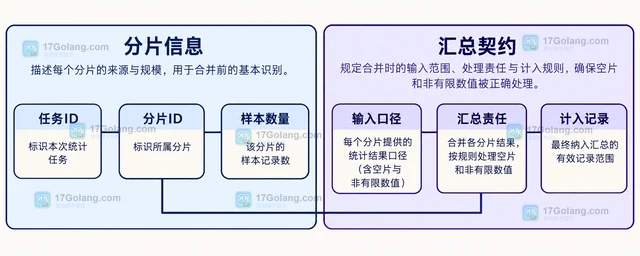
- Java DoubleSummaryStatistics 怎样合并分片统计结果
- 194浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 795次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 786次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 872次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 837次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 668次使用
-
- Java 时间格式兼容多个输入格式的方法
- 2026-10-18 501浏览
-
- Java try-with-resources 多个资源关闭顺序是什么
- 2026-09-10 501浏览
-
- 矩阵主副对角线快速定位技巧
- 2026-05-31 501浏览
-
- Java多态优化流程代码与行为分发改进
- 2026-05-26 501浏览
-
- JVM 类元数据双亲委派链表深度解析
- 2026-05-21 501浏览


