
Go语言JSON高效编码技巧分享
golang学习网今天将给大家带来《Go语言JSON渐进编码技巧分享》,感兴趣的朋友请继续看下去吧!以下内容将会涉及到等等知识点,如果你是正在学习Golang或者已经是大佬级别了,都非常欢迎也希望大家都能给我建议评论哈~希望能帮助到大家!

本文探讨了在Go语言中,如何对大型数据流(特别是来自通道的数据)进行JSON编码,而无需一次性将所有数据加载到内存中。由于标准库`encoding/json`不支持直接对通道类型进行流式编码,文章详细介绍了手动构建JSON结构并逐个编码元素的方法,并提供了一个高效且内存友好的实现方案,以应对大数据量下的性能和资源挑战。
Go语言中大型数据流的JSON编码挑战
在Go语言中处理大数据量时,一个常见的需求是将数据序列化为JSON格式并输出,例如写入文件或通过网络发送。然而,当数据量非常庞大,以至于无法一次性全部加载到内存中时,传统的json.Marshal或json.Encoder.Encode方法就显得力不从心。特别地,如果数据源是一个Go通道(chan),encoding/json包并不能直接识别并迭代通道中的元素进行编码,尝试对chan类型进行编码会导致运行时错误,如json: unsupported type: chan string。
这种情况下,我们需要一种机制,能够边接收数据边进行JSON编码,即“流式编码”或“渐进式编码”。
encoding/json包的局限性
Go标准库的encoding/json包在设计上主要针对已完全存在于内存中的数据结构进行编码和解码。虽然json.Encoder提供了向io.Writer写入JSON的能力,但它仍然期望接收一个完整的Go值。对于像chan string这样的流式数据源,encoding/json缺乏内置的反射机制来迭代通道并将其内容编码为JSON数组。
例如,以下尝试直接编码包含通道的结构体将会失败:
package main

import (
    "encoding/json"
    "log"
    "os"
    "time"
)

func main() {
    type Data struct {
        Foo string
        Bar chan string // 这是一个数据流,不希望一次性加载
    }

    data := Data{
        Foo: "Hello World",
        Bar: make(chan string),
    }

    // 模拟一个长时间的数据流
    go func() {
        defer close(data.Bar)
        for _, x := range []string{"one", "two", "three", "four", "five"} {
            data.Bar <- x
            time.Sleep(100 * time.Millisecond) // 模拟数据生成延迟
        }
    }()

    // 尝试直接编码,这将导致错误
    if err := json.NewEncoder(os.Stdout).Encode(&data); err != nil {
        log.Println("Error encoding:", err) // 输出: Error encoding: json: unsupported type: chan string
    }
}
手动实现JSON流式编码
鉴于encoding/json的上述局限,处理大型数据流的最佳实践是手动构建JSON结构。这意味着我们需要自己写入JSON对象的起始和结束符({, }),以及数组的起始和结束符([, ]),并在循环中逐个编码数据流中的元素。
这种方法的优势在于:
- 内存效率高: 数据在通道中流动,每次只处理一个元素,无需将所有元素存储在内存中。
- 即时输出: JSON数据可以立即写入输出流,减少延迟。
- 高度可控: 可以灵活地定制JSON的结构。
以下是一个实现流式编码的示例:
package main

import (
    "encoding/json"
    "fmt"
    "io"
    "log"
    "os"
    "time"
)

// Data结构体包含一个固定字段和一个数据流字段
type Data struct {
    Foo string
    Bar chan string
}

// StreamEncodeJSON 函数用于流式编码Data结构体
func StreamEncodeJSON(w io.Writer, data Data) error {
    // 写入JSON对象的起始部分和Foo字段
    _, err := fmt.Fprintf(w, `{"Foo": %s, "Bar": [`, strconv.Quote(data.Foo))
    if err != nil {
        return fmt.Errorf("failed to write initial JSON: %w", err)
    }

    firstElement := true
    // 迭代通道,逐个编码Bar中的元素
    for item := range data.Bar {
        if !firstElement {
            // 如果不是第一个元素,先写入逗号分隔符
            _, err := w.Write([]byte(","))
            if err != nil {
                return fmt.Errorf("failed to write comma: %w", err)
            }
        }

        // 使用json.NewEncoder编码单个元素
        // 注意:json.Encoder.Encode 会在每个值后面添加换行符,
        // 但由于我们是手动拼接数组,需要确保输出是纯粹的JSON值。
        // 更稳妥的做法是使用 json.Marshal 再写入,或者确保Encoder不会写入换行符。
        // 对于基本类型如string,可以直接使用 strconv.Quote
        _, err = fmt.Fprintf(w, "%s", strconv.Quote(item))
        if err != nil {
            return fmt.Errorf("failed to encode item: %w", err)
        }
        firstElement = false
    }

    // 写入JSON数组和对象的结束部分
    _, err = w.Write([]byte("]}"))
    if err != nil {
        return fmt.Errorf("failed to write closing JSON: %w", err)
    }
    return nil
}

func main() {
    data := Data{
        Foo: "Hello World",
        Bar: make(chan string),
    }

    // 模拟一个数据生成器
    go func() {
        defer close(data.Bar)
        for i := 0; i < 5; i++ {
            data.Bar <- fmt.Sprintf("element_%d", i+1)
            time.Sleep(100 * time.Millisecond) // 模拟数据生成延迟
        }
    }()

    fmt.Println("Starting stream encoding...")
    err := StreamEncodeJSON(os.Stdout, data)
    if err != nil {
        log.Fatalf("Stream encoding failed: %v", err)
    }
    fmt.Println("\nStream encoding finished.")
}
代码解析与注意事项:
- 手动拼接JSON结构: 我们首先写入{"Foo": "...", "Bar": [,然后进入循环。
- 循环迭代通道: for item := range data.Bar 会阻塞直到通道有数据或关闭。
- 逗号处理: 在写入除第一个元素之外的任何元素之前,需要先写入一个逗号(,)作为JSON数组元素的分隔符。
- 元素编码: 对于通道中的每个元素,我们再次使用strconv.Quote将其转换为JSON字符串。如果item是更复杂的结构体,则需要使用json.Marshal(item)将其转换为字节切片,再写入w。
- 错误处理: 每次写入操作都应检查错误。
- 关闭通道: 确保在所有数据发送完毕后关闭通道,以便for range循环能够正常结束。
- json.Encoder.Encode的局限: 直接使用json.NewEncoder(w).Encode(item)会在每个编码值后添加换行符,这会破坏JSON数组的格式。因此,对于数组内部的元素,更推荐使用json.Marshal或fmt.Fprintf结合strconv.Quote来确保输出纯粹的JSON值。
扩展思考:自定义json.Marshaler接口的未来
虽然目前encoding/json包不支持直接对通道进行流式编码,但如果json.Marshaler接口能够接受io.Writer作为参数,那么实现这种流式编码将会变得非常优雅。例如,一个理想的Marshaler接口可能如下:
type Marshaler interface {
    MarshalJSON(io.Writer) error
}
如果存在这样的接口,我们就可以为Data结构体实现MarshalJSON(w io.Writer)方法,在该方法内部自行控制JSON的写入过程,包括迭代通道并逐个编码元素。这将使得自定义流式编码能够更好地融入encoding/json的生态系统。
然而,在当前的Go版本中,json.Marshaler接口定义为MarshalJSON() ([]byte, error),要求返回一个完整的字节切片,这与流式编码的目标相悖。因此,手动构建JSON字符串仍是目前最直接和有效的方法。
总结
在Go语言中对大型数据流进行JSON编码,尤其当数据源是通道时,由于encoding/json包的固有设计,需要采取手动构建JSON结构的策略。通过逐个处理通道中的元素,并精确控制JSON字符串的写入,我们可以实现高效且内存友好的流式编码。虽然这种方法需要更多的手动操作,但它为处理大数据量场景提供了必要的灵活性和性能保障。
今天带大家了解了的相关知识,希望对你有所帮助;关于Golang的技术知识我们会一点点深入介绍,欢迎大家关注golang学习网公众号,一起学习编程~
 Windows下Golang环境搭建教程
- 上一篇
- Windows下Golang环境搭建教程

- 下一篇
- 悟空搜索精准筛选技巧分享
-
- Golang · Go教程 | 32分钟前 |
- Go reflect.TypeFor 和 TypeOf 空指针技巧有什么区别
- 126浏览 收藏
-
- Golang · Go教程 | 41分钟前 |
- Go sync.Map.Range 中删除当前键会不会影响后续遍历
- 191浏览 收藏
-
- Golang · Go教程 | 43分钟前 |
- Go sync.Cond 的 Signal 和 Broadcast 怎么按等待者数量选择
- 152浏览 收藏
-
- Golang · Go教程 | 46分钟前 | 并发 · sync · 标准库 · Go教程 · Mutex Go sync.Cond 并发状态 sync.Cond复制 sync.Locker
- Go sync.Cond 首次使用后为什么不能复制
- 422浏览 收藏
-
- Golang · Go教程 | 51分钟前 | 标准库 · Go教程 · Seek Go bytes.Reader io.WriterTo bytes.Reader.WriteTo 读取偏移
- Go bytes.Reader.WriteTo 导出后为什么读取位置已经改变
- 450浏览 收藏
-
- Golang · Go教程 | 52分钟前 | 错误处理 · go · Go Seek bytes.Reader io.Seeker 偏移位置
- Go bytes.Reader.Seek 移到数据开头之前会返回什么
- 403浏览 收藏
-
- Golang · Go教程 | 54分钟前 | 源码分析 · Go教程 · Go go/token 源码位置 token.File SetLines
- Go token.File.SetLines 返回 false 时怎样定位行偏移错误
- 200浏览 收藏
-
- Golang · Go教程 | 1小时前 | 单元测试 · Go教程 · Generator 属性测试 Go testing/quick quick.Check Config.Values
- Go testing/quick 遇到不可生成的结构体时怎么提供自定义 Generator
- 238浏览 收藏
-
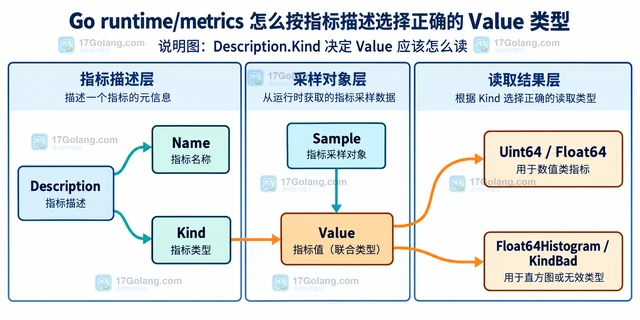
- Golang · Go教程 | 1小时前 | go · 性能监控 · Go runtime/metrics ValueKind Description Sample
- Go runtime/metrics 怎么按指标描述选择正确的 Value 类型
- 203浏览 收藏
-
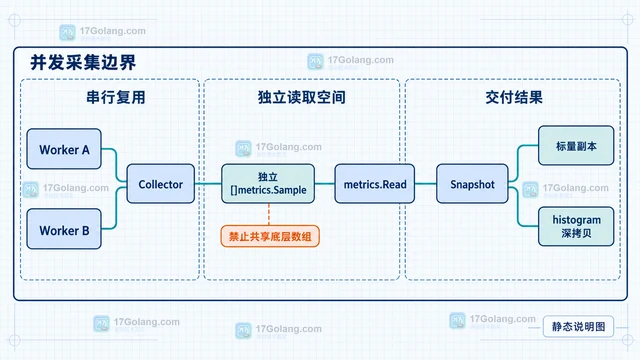
- Golang · Go教程 | 1小时前 |
- Go runtime/metrics.Read 怎么复用 Sample 切片减少采集分配
- 167浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 436次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 509次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 526次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 469次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 296次使用
-
- Java 性能优化上线清单:从定位、改造到灰度发布
- 2026-06-11 860浏览
-
- Spring Boot 压测验证:Gatling、JMeter 与性能回归门禁
- 2026-06-11 843浏览
-
- Java NMT 非堆内存排查:Direct Buffer、线程栈与 Metaspace 分析
- 2026-06-11 826浏览
-
- Spring Boot 容器内存优化:JVM 堆、非堆与 MaxRAMPercentage
- 2026-06-11 809浏览
-
- Tomcat 连接与线程参数调优:maxThreads、acceptCount 与 KeepAlive
- 2026-06-11 792浏览


