
AWS Bedrock 知识 - 基础测试脚本
来源:dev.to
2024-11-03 10:39:25
0浏览
收藏
来到golang学习网的大家,相信都是编程学习爱好者,希望在这里学习文章相关编程知识。下面本篇文章就来带大家聊聊《AWS Bedrock 知识 - 基础测试脚本》,介绍一下,希望对大家的知识积累有所帮助,助力实战开发!

这是一个简单但有用的测试脚本,可帮助您快速测试和验证您的 aws bedrock + kb 设置。如果不同,只需更新您的 aws 区域,然后插入您的 bedrock kb id。
import boto3
import json
import time
from datetime import datetime
def test_kb_setup():
    """Test function to verify Bedrock Knowledge Base setup and queries"""
    # Initialize clients
    bedrock_agent = boto3.client('bedrock-agent-runtime', region_name='us-east-1')
    bedrock_runtime = boto3.client('bedrock-runtime', region_name='us-east-1')
    # Your Knowledge Base ID
    kb_id = "**your-knowledge-base-id**"  # Replace with your actual KB ID
    def test_kb_query(query_text):
        """Test a single knowledge base query"""
        print(f"\nTesting query: '{query_text}'")
        print("-" * 50)
        try:
            # Query the knowledge base
            response = bedrock_agent.retrieve(
                knowledgeBaseId=kb_id,
                retrievalQuery={'text': query_text},
                retrievalConfiguration={
                    'vectorSearchConfiguration': {
                        'numberOfResults': 3
                    }
                }
            )
            # Print raw response for debugging
            print("\nRaw Response:")
            print(json.dumps(response, indent=2, default=str))
            # Process and print retrieved results
            print("\nProcessed Results:")
            if 'retrievalResults' in response:
                for i, result in enumerate(response['retrievalResults'], 1):
                    print(f"\nResult {i}:")
                    print(f"Score: {result.get('score', 'N/A')}")
                    print(f"Content: {result.get('content', {}).get('text', 'N/A')}")
                    print(f"Location: {result.get('location', 'N/A')}")
            else:
                print("No results found in response")
            return True
        except Exception as e:
            print(f"Error during query: {str(e)}")
            return False
    def test_kb_with_bedrock(query_text):
        """Test knowledge base integration with Bedrock"""
        print(f"\nTesting KB + Bedrock integration for: '{query_text}'")
        print("-" * 50)
        try:
            # First get KB results
            kb_response = bedrock_agent.retrieve(
                knowledgeBaseId=kb_id,
                retrievalQuery={'text': query_text},
                retrievalConfiguration={
                    'vectorSearchConfiguration': {
                        'numberOfResults': 3
                    }
                }
            )
            # Format context from KB results
            context = ""
            if 'retrievalResults' in kb_response:
                context = "\n".join([
                    f"Reference {i+1}:\n{result.get('content', {}).get('text', '')}\n"
                    for i, result in enumerate(kb_response['retrievalResults'])
                ])
            # Prepare Bedrock prompt
            enhanced_prompt = (
                f"Using the following references:\n\n{context}\n\n"
                f"Please answer this question: {query_text}\n"
                "Base your response on the provided references and clearly cite them when used."
            )
            # Get Bedrock response
            bedrock_response = bedrock_runtime.invoke_model(
                modelId="anthropic.claude-v2",
                body=json.dumps({
                    "prompt": f"\n\nHuman: {enhanced_prompt}\n\nAssistant:",
                    "max_tokens_to_sample": 500,
                    "temperature": 0.7,
                    "top_p": 1,
                }),
                contentType="application/json",
                accept="application/json",
            )
            response_body = json.loads(bedrock_response.get('body').read())
            final_response = response_body.get('completion', '').strip()
            print("\nBedrock Response:")
            print(final_response)
            return True
        except Exception as e:
            print(f"Error during KB + Bedrock integration: {str(e)}")
            return False
    # Run test queries
    test_queries = [
        "What are our company's remote work policies?",
        "Tell me about employee benefits",
        "What is the vacation policy?",
        "How does the performance review process work?",
        "What are the working hours?"
    ]
    print("Starting Knowledge Base Tests")
    print("=" * 50)
    # Test 1: Basic KB Queries
    print("\nTest 1: Basic Knowledge Base Queries")
    for query in test_queries:
        success = test_kb_query(query)
        if not success:
            print(f"Failed on query: {query}")
    # Test 2: KB + Bedrock Integration
    print("\nTest 2: Knowledge Base + Bedrock Integration")
    for query in test_queries:
        success = test_kb_with_bedrock(query)
        if not success:
            print(f"Failed on integration test: {query}")
if __name__ == "__main__":
    test_kb_setup()
今天带大家了解了的相关知识,希望对你有所帮助;关于文章的技术知识我们会一点点深入介绍,欢迎大家关注golang学习网公众号,一起学习编程~
版本声明
本文转载于:dev.to 如有侵犯,请联系study_golang@163.com删除
 使用 COLLATE 查找重复用户名时报错,如何解决?
- 上一篇
- 使用 COLLATE 查找重复用户名时报错,如何解决?

- 下一篇
- 如何在网页中执行 Shell 脚本和 SQL 语句并存储数据到数据库?
查看更多
最新文章
-
- 文章 · python教程 | 2天前 |
- Python logging Formatter 统一结构化字段输出
- 185浏览 收藏
-
- 文章 · python教程 | 2天前 | 配置 · python · Python教程 · 配置管理 Python 3.15 frozendict 不可变映射
- Python 3.15 frozendict 内置类型的配置使用场景
- 192浏览 收藏
-
- 文章 · python教程 | 2天前 | 序列化 · python · Python pickle 进程池 multiprocessing Pool
- Python multiprocessing 进程池传递不可序列化对象
- 255浏览 收藏
-
- 文章 · python教程 | 2天前 | 数据一致性 · Python教程 · Python 事务 自动提交 sqlite3 autocommit isolation_level
- Python sqlite3 事务模式与自动提交边界
- 197浏览 收藏
-
- 文章 · python教程 | 2天前 |
- Python contextlib.nullcontext 统一同步异步入口
- 316浏览 收藏
-
- 文章 · python教程 | 2天前 | 面向对象 · python · Python教程 · InitVar __post_init__ Python dataclass 派生字段 field(init=False)
- Python dataclass __post_init__ 计算派生字段
- 303浏览 收藏
-
- 文章 · python教程 | 2天前 |
- Python typing.TypeGuard 处理复杂容器类型收窄
- 437浏览 收藏
-
- 文章 · python教程 | 2天前 |
- Python os.fspath 支持自定义路径对象
- 214浏览 收藏
-
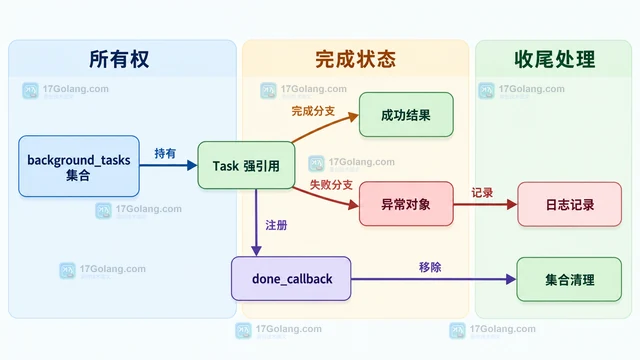
- 文章 · python教程 | 2天前 | 异常处理 · 异步编程 · Python教程 · asyncio · 后台任务 任务取消 CancelledError Python asyncio asyncio.shield
- Python asyncio.shield 保护后台任务免受外层取消
- 407浏览 收藏
-
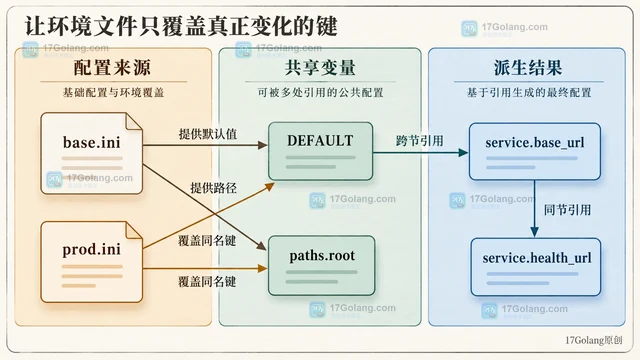
- 文章 · python教程 | 2天前 |
- Python configparser ExtendedInterpolation 组织分层配置
- 480浏览 收藏
查看更多
课程推荐
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
查看更多
AI推荐
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 448次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 519次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 535次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 480次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 304次使用
查看更多
相关文章
-
- Python sqlite3 Connection serialize 怎么导出数据库快照:备份窗口、内存占用与恢复校验
- 2026-08-26 501浏览
-
- Python监控网页状态:requests异常处理实战
- 2026-05-29 501浏览
-
- TensorFlow模型部署为API的TF Serving方法
- 2026-05-26 501浏览
-
- Python字符串编码转换:encode与decode详解
- 2026-05-16 501浏览
-
- TensorFlow裁剪无用算子方法详解
- 2026-05-15 501浏览


