
Snowflake高效导出20亿行数据方法
本文揭秘了在 Snowflake 中安全、高效导出超大规模数据(如20亿行表)的工程化最佳实践:摒弃易导致内存溢出和超时的客户端全量拉取方式(如to_pandas()),转而采用原生高性能的“COPY INTO 卸载 → 云存储或内部 Stage 存储 → GET 下载”三步分离方案,支持自动分片、GZIP压缩、字段安全封装与增量过滤,兼顾速度、稳定性与可审计性,真正释放Snowflake海量数据导出的生产级能力。
本文详解在 Snowflake 中安全、高效导出海量数据(如 20 亿行级表)的完整方案:推荐使用 COPY INTO 卸载至云存储或内部 Stage,再通过 GET 下载到本地;避免在 Snowflake 计算层直接生成文件或依赖 to_pandas() 全量拉取,规避内存溢出与超时风险。
本文详解在 Snowflake 中安全、高效导出海量数据(如 20 亿行级表)的完整方案:推荐使用 `COPY INTO` 卸载至云存储或内部 Stage,再通过 `GET` 下载到本地;避免在 Snowflake 计算层直接生成文件或依赖 `to_pandas()` 全量拉取,规避内存溢出与超时风险。
Snowflake 并非设计用于在服务器端生成并保存本地文件(如 .csv),其计算节点无持久化文件系统访问权限——这也是您原始脚本中 dataframe.to_csv(filename) 在 Snowflake Worksheet 中无法生效的根本原因。强行分月拉取并转为 Pandas DataFrame 不仅效率极低(网络传输 + 序列化开销大),还极易触发查询超时、内存不足(OOM)或会话中断,尤其面对 20 亿+ 行规模的数据。
✅ 正确路径是 “卸载(Unload)→ 存储 → 下载(Download)” 三步分离:
1. 使用 COPY INTO 卸载数据到目标位置
Snowflake 原生支持高性能并行卸载,可直接将表或任意查询结果写入外部云存储(S3/GCS/Azure Blob)或内部 Stage,全程在服务端完成,不经过客户端。
▪ 卸载至 AWS S3(推荐生产环境)
-- 确保已创建并授权 storage_integration(如 s3_int)
COPY INTO s3://my-backup-bucket/snowplow-exports/my_table_full/
FROM my_table
STORAGE_INTEGRATION = s3_int
FILE_FORMAT = (TYPE = CSV COMPRESSION = GZIP FIELD_OPTIONALLY_ENCLOSED_BY = '"' SKIP_HEADER = 1)
SINGLE = FALSE
MAX_FILE_SIZE = 1073741824; -- 1GB/文件,自动分片
✅ 优势:高吞吐、自动分片、压缩加密、权限集中管控;支持增量时间范围过滤(加 WHERE 子句)。
▪ 卸载至 Snowflake 内部 Stage(适合中小批量或调试)
-- 先创建命名内部 Stage(若未存在)
CREATE OR REPLACE STAGE my_backup_stage
    DIRECTORY = (ENABLE = TRUE);

-- 卸载全表(或带 WHERE 的查询)
COPY INTO @my_backup_stage/my_table_2024_q1/
FROM (
  SELECT * FROM my_table
  WHERE email_created_at >= '2024-01-01' AND email_created_at < '2024-04-01'
)
FILE_FORMAT = (TYPE = CSV COMPRESSION = GZIP FIELD_DELIMITER = ',' FIELD_OPTIONALLY_ENCLOSED_BY = '"' SKIP_HEADER = 1)
SINGLE = FALSE;
2. 从 Stage 下载文件到本地机器
卸载完成后,使用 GET 命令将 Stage 中的文件拉取至本地目录(需有对应权限):
-- 下载所有 CSV 文件到本地 ./backup/ 目录(当前用户 OS 路径)
GET @my_backup_stage/my_table_2024_q1/ file:///Users/you/backup/;
⚠️ 注意:file:// 路径必须为运行 SnowSQL 或 Snowpark 客户端的本地机器路径,而非 Snowflake 服务器路径。
3. Python(Snowpark)中自动化执行(推荐方式)
避免在 Worksheet 中硬编码 SQL,改用 Snowpark Python 脚本统一调度:
from snowflake.snowpark import Session

session = Session.builder.configs(connection_params).create()

# 步骤1:卸载查询结果到内部 Stage
query = """
SELECT * FROM my_table
WHERE email_created_at >= '2022-02-01' AND email_created_at < '2024-03-01'
"""
stage_path = f"@my_backup_stage/full_export_{int(time.time())}/"

copy_result = session.sql(f"""
    COPY INTO {stage_path}
    FROM ({query})
    FILE_FORMAT = (TYPE = CSV COMPRESSION = GZIP FIELD_DELIMITER = ',' SKIP_HEADER = 1)
    SINGLE = FALSE
""").collect()
print(f"Unloaded {copy_result[0]['rows_unloaded']} rows to {stage_path}")

# 步骤2:下载 Stage 中所有文件(需提前配置本地路径权限)
local_dir = "/path/to/your/local/backup/"
get_result = session.sql(f"GET {stage_path} 'file://{local_dir}'").collect()
print(f"Downloaded {len(get_result)} files to {local_dir}")
⚠️ 关键注意事项
- 不要依赖 to_pandas() 全量拉取:2B 行数据在客户端内存中不可行;即使分月,Pandas DataFrame 构建与序列化仍是性能瓶颈。
- 启用 DIRECTORY = (ENABLE = TRUE):对内部 Stage 启用目录表(LIST @stage 可查文件列表),便于后续管理与校验。
- 设置合理 MAX_FILE_SIZE 和 SINGLE = FALSE:确保大表自动切片为多文件(如 512MB–1GB),提升下载并发性与容错性。
- CSV 导出建议启用压缩与字段封装:COMPRESSION = GZIP 显著减小体积;FIELD_OPTIONALLY_ENCLOSED_BY = '"' 避免文本含逗号导致解析错误。
- 权限检查:确保角色拥有 USAGE on stage、OPERATE on integration(对外部存储)、以及本地文件系统写入权限。
通过 COPY INTO + GET 组合,您可稳定、可审计、可扩展地完成 TB 级数据备份,真正发挥 Snowflake 原生卸载能力——这才是面向海量数据的工程化实践。
以上就是本文的全部内容了,是否有顺利帮助你解决问题?若是能给你带来学习上的帮助,请大家多多支持golang学习网!更多关于文章的相关知识,也可关注golang学习网公众号。
 PHP事务机制面试必考点解析
- 上一篇
- PHP事务机制面试必考点解析
- 下一篇
- Win10屏保设置教程自定义美化方法
-
- 文章 · python教程 | 3小时前 | 并发 · 线程池 · python · Python concurrent.futures 多解释器 InterpreterPoolExecutor CPU并行
- Python concurrent.futures InterpreterPoolExecutor 适合什么任务
- 186浏览 收藏
-
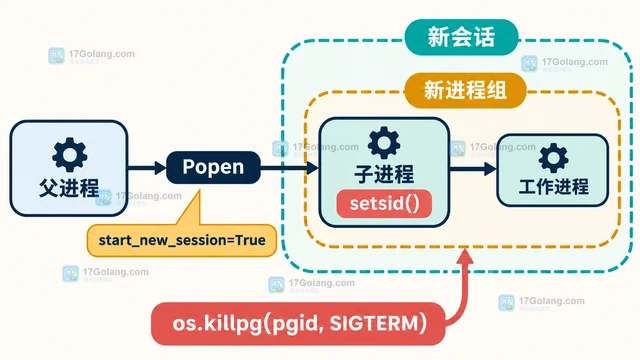
- 文章 · python教程 | 3小时前 | Python教程 · 进程管理 · Python subprocess.Popen TimeoutExpired 进程组 start_new_session killpg
- Python subprocess.Popen start_new_session 怎样清理进程组
- 340浏览 收藏
-
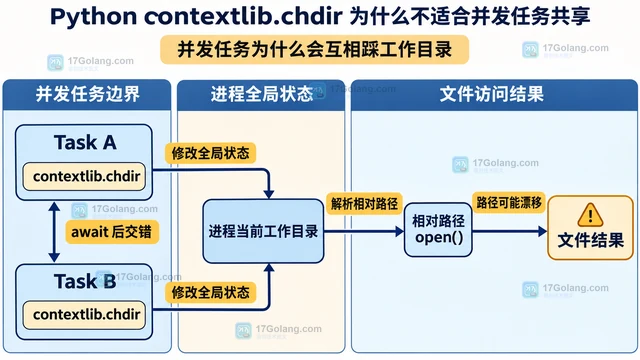
- 文章 · python教程 | 3小时前 |
- Python contextlib.chdir 为什么不适合并发任务共享
- 241浏览 收藏
-
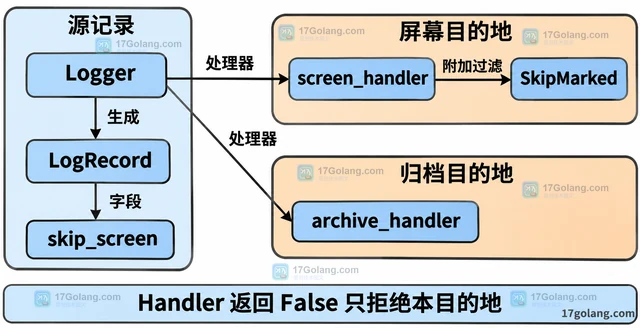
- 文章 · python教程 | 3小时前 | Python handler 日志过滤 logging.Filter
- Python logging.Filter 返回 False 时怎样阻止单条记录
- 447浏览 收藏
-
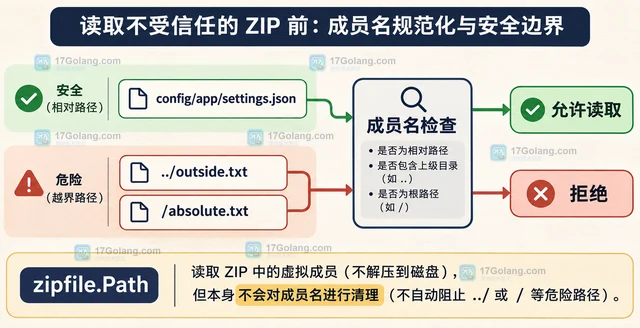
- 文章 · python教程 | 3小时前 |
- Python zipfile.Path 怎样读取压缩包内的嵌套资源
- 157浏览 收藏
-
- 文章 · python教程 | 3小时前 | 协程 · 任务调度 · Python教程 · asyncio · 兼容性 · Python asyncio 异步调度 create_task eager_start
- Python asyncio.create_task eager_start 如何影响调度
- 155浏览 收藏
-
- 文章 · python教程 | 4小时前 | Python CancelledError TaskGroup asyncio.timeout 嵌套超时
- Python asyncio.timeout 怎样把嵌套任务限制在总时限内
- 215浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 1020次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 1021次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 1158次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 1123次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 964次使用
-
- Python TaskGroup 怎样让子任务失败统一收敛
- 2026-11-12 501浏览
-
- Python xml.dom.minidom.unlink 怎样释放不再使用的 DOM 树引用
- 2026-10-27 501浏览
-
- Python typing 怎样用 TypeIs 缩小类型
- 2026-10-24 501浏览
-
- Python sqlite3 Connection serialize 怎么导出数据库快照:备份窗口、内存占用与恢复校验
- 2026-08-26 501浏览
-
- Python监控网页状态:requests异常处理实战
- 2026-05-29 501浏览


